
GESP C++ 四级 · 14 天闯关
函数数组 · 指针结构体排序与递推
7 天理论 + 7 天编程题:前 7 天把本级别考点的 近 12 期真题 300 道全部刷完(含 29 道需要看原卷配图的题), 后 7 天按知识点分天练编程题(洛谷题面 + 美力程题解),共 32 道; 末尾附 1 套模拟自测卷。
理论天含:① 今日考情(真题分布 + 配套教材)→ ② 知识地图(思维导图)→ ③ 核心精讲 → ④ 真题演练(本考点全部真题,10 题/卡)→ ⑤ 今日打卡。 编程天按知识点分组(如「图案输出 · 嵌套循环画图」一天),题面取洛谷、题解取美力程。 单选答案已与官方答案表逐题核对。进度保存在本机浏览器。
函数定义与调用
①今日考情 · 真题分布与备考建议
本考点在 GESP C++ 4级近 14 期真题中共 65 道客观题(单选 37 / 判断 28,其中 0 道需看原卷配图)。本页把这一考点的真题全部收进来了,一道没漏,按每 10 题一张卡分组,可分次完成。
本期分布
| 期次 | 题数 |
|---|---|
| 2023年6月 C++ 4级 | 7 |
| 2023年9月 C++ 4级 | 8 |
| 2024年12月 C++ 4级 | 5 |
| 2024年3月 C++ 4级 | 8 |
| 2024年6月 C++ 4级 | 2 |
| 2025年12月 C++ 4级 | 5 |
| 2025年3月 C++ 4级 | 4 |
| 2025年6月 C++ 4级 | 5 |
| 2025年9月 C++ 4级 | 7 |
| 2026年3月 C++ 4级 | 8 |
| 2026年9月 C++ 4级 | 6 |
配套教材
GESP 大通关 4 级(全书 58 页):本天对应 4.1 函数定义与调用。教材按同一套大纲顺序编排,可对照阅读。
备考建议(出题人视角)
函数是四级的门槛:题目从"看一段代码"变成"看几个函数互相调用",推演量直接翻倍。命题人最爱的三个点:**返回类型由定义决定**(不是由 return 决定)、**值传递改不了实参**、**递归必须有出口**。读带函数的题,先画一张"调用顺序表",标出每次进函数时参数的值。
②知识地图 · 本考点思维导图
- 定义结构
- 返回类型 函数名(参数表) { 函数体 }
- 返回类型可以是 int / double / bool / void
- void 表示不返回任何值
- 形参与实参
- 形参:定义时括号里的变量(局部)
- 实参:调用时真正传进去的值
- 返回值
- return 表达式; 把值带回调用处
- 非 void 函数必须有 return
- 返回类型由**定义**决定,不是由 return 的值决定
- 作用域与生命周期
- 局部变量:函数内定义,出函数即销毁
- 全局变量:所有函数外定义,整个程序有效
- 同名时**就近原则**
- 递归三要素
- ① 递归关系:f(n) 用 f(n-1) 表示
- ② 出口条件:n 到多少就停
- ③ 每层都要更靠近出口
③核心精讲
1. 函数的定义与调用
int add(int a, int b) {     // a、b 是形参
    return a + b;           // 返回类型是 int
}

int main() {
    int s = add(3, 5);      // 3、5 是实参
    cout << s;              // 8
}| 名词 | 含义 | 位置 |
|---|---|---|
| 返回类型 | 函数交回什么类型的值 | 定义的最前面 |
| 形参 | 定义时的占位变量 | 函数名的括号里 |
| 实参 | 调用时真正传的值 | 调用处的括号里 |
return | 把值送回调用处,并结束函数 | 函数体内 |
易错:返回类型由定义决定,不是由
return后面的值决定。int f() { return 3.9; }返回的是 3(截断),因为定义写的是 int。
2. void 与返回值
void printLine() {          // void:不需要 return
    cout << "----" << endl;
}

int max2(int a, int b) {
    if (a > b) return a;    // 可以有多个 return,走一个就结束
    return b;
}void函数不能出现在赋值号的右边:int x = printLine();编译错误。- 非
void函数在所有路径上都要有return,否则行为不确定。
3. 形参与实参:值传递
void change(int x) { x = 100; }     // 改的是副本

int main() {
    int a = 5;
    change(a);
    cout << a;            // 仍然是 5
}普通参数是值传递:函数里改的是实参的副本,原变量不受影响。 要让函数改动实参,必须用引用传递(int &x)或指针——这是第 23 天的事。
易错:这是四级最常考的坑。"值传递能不能改变实参"的答案是不能。
4. 作用域与生命周期
| 变量 | 定义位置 | 有效范围 | 生命周期 |
|---|---|---|---|
| 局部变量 | 函数内 / 花括号内 | 本块内 | 进入块时创建,离开时销毁 |
| 全局变量 | 所有函数外 | 整个程序 | 程序开始到结束 |
int g = 10;              // 全局
int main() {
    int g = 20;          // 局部,遮蔽全局
    cout << g;           // 20 —— 就近原则
}易错:局部变量与全局变量同名时,局部优先。
5. 递归三要素
int fact(int n) {
    if (n <= 1) return 1;          // ② 出口
    return n * fact(n - 1);        // ① 递归关系,③ 每层 n 减 1
}| 要素 | 含义 | 缺了会怎样 |
|---|---|---|
| 递归关系 | f(n) 怎么用 f(n−1) 表示 | 写不出递推 |
| 出口条件 | 什么时候直接返回 | 无限递归,栈溢出 |
| 向出口靠近 | 每层参数必须变小 | 永远到不了出口 |
6. 调用顺序表(读带函数的题必用)
int f(int n) {
    if (n <= 1) return 1;
    return f(n - 1) + 1;
}
// 调用 f(4)| 调用 | 参数 | 内部动作 | 返回 |
|---|---|---|---|
| ① | 4 | 要 f(3)+1 | 等 |
| ② | 3 | 要 f(2)+1 | 等 |
| ③ | 2 | 要 f(1)+1 | 等 |
| ④ | 1 | 直接返回 1 | 1 |
| ③' | — | 1+1 | 2 |
| ②' | — | 2+1 | 3 |
| ①' | — | 3+1 | 4 |
先一路往下,到出口再一路往上传——这个顺序画错了,答案一定错。
7. 一分钟记忆卡
- 返回类型由定义决定(int f 返回 3.9 得 3)
- 值传递改不了实参
void函数不能赋值给变量- 局部优先于全局(就近原则)
- 递归三要素:关系、出口、靠近出口
- 读递归先画调用表,先下后上
int multiply(int x, int y);

int main() {
    int a = 4;
    int b = 5;
    int result = multiply(a, b);
    std::cout << "The result is: " << result << std::endl;
    return 0;
}

int multiply(int x, int y) {
    return x * y;
}int add(int a, int b = 1); // 函数声明
int main() {
cout << add(2) << " " << add(2, 3);
return 0;
}
int add(int a, int b) { // 函数定义
return a + b;
}int climbStairs(int n) {
if(n <= 2) return n;
int a = 1, b = 2;
for(int i = 3; i <= n; i++) {
int temp = a + b;
a = b;
b = temp;
}
return b;
}#include <iostream>
using namespace std;
int calculate(int x, int y = 10);
int main() {
cout << calculate(5); // 调用1
return 0;
}
int calculate(int x, int y) {
return x * y;
}
int calculate(int x) { // 重载函数
return x * 2;
}- 1.A 下面的语句中,( )正确定义了一个计算浮点数x的平方(x2 = x …
- 2.A 关于下述代码,说法错误的是( )。…
- 3.A 下面这段代码会输出( )。…
- 4.B 给定函数 climbStairs(int n) 的定义如下,则 cl…
- 5.B 下面代码可以正常编译并输出 10。…
- 6.A 下列关于C++语言中函数的叙述,正确的是( )。…
- 7.A 在C++语言中,一个函数没有被调用时,它的参数不占用内存。…
- 8.B 下列关于C++语言中函数的叙述,正确的是( )。…
- 9.A 下列关于C++语言中函数的叙述,不正确的是( )。…
- 10.A 两个函数之间可以使用全局变量来传递数据。 ( )…
int x = 10;
void func() { int x = 20; std::cout << x; }
int main() {
    func();
    std::cout << x;
    return 0;
}int main() {
greet();
return 0;
}
void greet() {
cout << "Hello!" << endl;
}int a = 1;
void test() {
int a = 2;
{
int a = 3;
a++;
}
a++;
cout << a << " ";
}
int main() {
test();
cout << a;
return 0;
}int climb(int n){
if(n <= 2) return n;
int a = 1, b = 2, c = 0;
for(int i = 3; i <= n; i++){
c = a + b;
a = b;
b = c;
}
return c;
}int ways(int n) {
if (n <= 2)
return n;
int a = 1, b = 2, c = 0;
for (int i = 3; i <= n; i++) {
c = a + b;
a = b;
b = c;
}
return b;
}void change(int x) {
x = 20;
}
int main() {
int x = 10;
change(x);
cout << x;
return 0;
}- 11.B 函数不可以调用自己。…
- 12.B 一个函数必须在调用之前既声明又定义。…
- 13.B 以下哪个选项正确描述了C++中形参和实参的区别?…
- 14.B 一个函数必须在调用之前既声明又定义。…
- 15.B 执行下述代码将输出( )。…
- 16.B 关于以下 C++代码,说法正确的是( )。…
- 17.A 执行完下面的代码后,输出是( )。…
- 18.B 执行 climb(6) 的返回值为( )。…
- 19.C 某机器人每次可以向前移动 1 格或 2 格,到达第 n 格的方法数由…
- 20.B 执行下面程序后会输出 20。…
void n_chars(char c, int n) {
   while (n-- > 0)
        cout << c;
}

char my_char = 'w';
int times = 5;
n_chars(my_char, times);int value = 100;
void print1() {
int value = 50;
cout << value << " ";
cout << ::value << " ";
}
void print2() {
cout << value << " ";
}
print1();
print2();int add(int, int);
void foo(int x) {
    x += 5;
}
int main() {
    int a = 10;
    foo(a);
    cout << a << endl;
}int x = 5;
void foo() {
int x = 10;
cout << x << " ";
}
void bar() {
cout << x << " ";
}
int main() {
foo();
bar();
}int x = 10;
void f() {
int x = x + 1;
cout << x << endl;
}
int main() {
f();
}- 21.C 若函数声明为int f(int &x){ x+=3; return …
- 22.B 下面函数不能正常执行的是( )…
- 23.B 下面代码的描述中,正确的是( )。…
- 24.A 函数是C++中的核心概念,用于封装可重用的代码块。…
- 25.B 在C++中,函数的返回类型可以省略,默认为int。…
- 26.C 运行如下代码会输出( )。…
- 27.A 下面C++代码正确声明了一个返回int 类型、接受两个int 参数的…
- 28.B 下面C++代码的输出是15。…
- 29.D 下面这段代码会输出( )。…
- 30.B 执行下面C++代码将输出 11。…
int x = 10;
void f() { int x = 20; cout << x; }

int main() {
    f();
    cout << x;
}s[100][10];。
- 31.A 下面程序执行后输出 2010。…
- 32.D 下列关于C++语言中变量的叙述,正确的是( )。…
- 33.B 在C++语言中,可以定义四维数组,但在解决实际问题时不可能用到,因为…
- 34.B 如果希望记录10 个最长为99 字节的字符串,可以将字符串数组定义为…
- 35.C 一个三维数组定义为long long array[6][6][6];…
- 36.A 在C++语言中,每个变量都有其作用域。…
- 37.A 如果希望记录10个最长为99字节的字符串,可以将字符串数组定义为ch…
- 38.B C++语言中下面哪个关键字能够限定对象的作用域( )。…
- 39.B 定义变量int a=5 , 则cout << &++a 会输出6。(…
- 40.B 定义数组int a[2024][3][16]={2,0,2,4,3,…
int arr[2][3] = {{1, 2, 3}, {4, 5, 6}};void func(int* p) {
*p = 10;
}
int main() {
int a = 5;
func(&a);
cout << a << endl;
return 0;
}void byValue(int x) { x = 100; }
void byRef(int& x) { x = 200; }
void byPointer(int* x) { *x = 300; }
int main() {
int a = 1, b = 2, c = 3;
byValue(a);
byRef(b);
byPointer(&c);
return 0;
}- 41.D 给定如下定义的数组arr,则*(*(arr + 1) + 2) 的值…
- 42.A 以下哪个函数声明在调用时可以传递二维数组的名字作为参数?( )…
- 43.B 在C++语言中,如果一个函数可能抛出异常,那么一定要在try 子句里…
- 44.D 下列关于C++语言中指针的叙述,不正确的是( )。…
- 45.B 在C++语言中,在函数调用时,通过引用传递的参数不会复制实际参数,因…
- 46.B 一个可能抛出异常的函数,调用它的位置没有在try 子句中,会引起编译…
- 47.B 在 C++语言中,如果一个函数可能抛出异常,那么一定要在try 子句…
- 48.B 关于递推算法的描述,正确的是( )。…
- 49.A 执行下面C++代码将输出 10。…
- 50.C 执行完下面的代码后,a、b 和 c 的值分别是( )。…
int score = 60;

void update(int &score) {
    score += 5;
}

int main() {
    int score = 80;
    update(score);
    cout << score << " " << ::score;
    return 0;
}int main()
{
int x[]={2, 0, 2, 4};
char geSP[]="Grade Examination of SP";
cout << geSP[sizeof(x)] << endl;
cout << endl;
return 0;
}int foo(float *f)
{
return int(*f*2);
}
int main()
{
float fnum[10]={1.1};
fnum[1]=foo(fnum);
cout << fnum[0]+fnum[1] << endl;
cout << endl;
return 0;
}int rc=5;
int main()
{
int rc;
cout << ++rc << endl;
cout << endl;
return 0;
}int climbStairs(int n) {
if (n <= 2) return n;
int prev2 = 1;
int prev1 = 2;
int current = 0;
for (int i = 3; i <= n; ++i) {
________________ // 在此处填入代码
}
return current;
}int f(int x = 2){
return x * 3;
}
int main(){
cout << f() << " " << f(4);
}int calc(int x, int y = 10);
int calc(int x) { return x * 2; }
int calc(int x, int y) { return x * y; }
int main() {
cout << calc(5);
}struct Device {
int id;
int state;
};
void reset(Device d) {
d.state = 0;
}
void start(Device &d) {
d.state += 1;
}
int main() {
Device d{7, 2};
reset(d);
start(d);
cout << d.id << " " << d.state;
return 0;
}int factorial(int n) {
int result = 1;
for (int i = 1; i <= n; i++) {
result *= i;
}
return result;
}void func(int& x) {
x = x * 2;
}
int a = 5;
func(a);- 51.A 执行下面程序后,输出结果是( )。…
- 52.C 下面C++代码执行后,输出的是( )。…
- 53.D 下面C++代码执行后输出是( )。…
- 54.D 下面C++代码执行以后输出的是( )。…
- 55.B 小杨正在爬楼梯,需要 n 阶才能到达楼顶,每次可以爬 1 阶或 2 …
- 56.B 执行下面程序后,输出为( )。…
- 57.B 下面程序可以正常编译并输出 10。…
- 58.D 执行下面程序后,输出结果是( )。…
- 59.A 下面递推程序计算 n!。当 n = 4 时,返回值为 24。…
- 60.B 给定以下代码,执行上述代码后,变量a 的值为( )。…
void increaseA(int x) {
    x++;
}
void increaseB(int* p) {
    (*p)++;
}
int main() {
    int a = 5;
    increaseA(a);
    cout << a << " ";
    increaseB(&a);
    cout << a;
}void add(int &x){
x += 10;
}
int a = 5;
add(a);void fun(int a, int &b, int *c){
a += 1;
b += 2;
*c += 3;
}
int main(){
int x = 1, y = 1, z = 1;
fun(x, y, &z);
cout << x << " " << y << " " << z;
}int x = 3;
void f(int& x){
x += 2;
}
int main(){
int x = 10;
f(x);
cout << x << " " << ::x;
}void add10(int &x) { x += 10; }
int main() {
int a = 5;
add10(a);
}- 61.C 下面程序运行的结果是( )。…
- 62.A 执行下面程序后,变量 a 的值会变成 15。…
- 63.B 执行下面程序后,输出为( )。…
- 64.A 执行下面程序后输出为( )。…
- 65.A 下面代码执行结束时,变量 a 的值变成 15。…
④今日打卡 · 点一下就能勾选
- 写出一个带返回值的函数与一个 void 函数的完整定义,说明差别
- 解释「返回类型由定义决定」,算出 int f(){return 3.9;} 的返回值
- 用一段代码证明值传递改变不了实参,并说明原因
- 默写递归三要素,指出缺「出口」会发生什么
- 为 f(n)=f(n−1)+1(f(1)=1)画出 f(4) 的调用顺序表
- 说明局部变量与全局变量同名时程序取哪个
- 把本日 65 道客观题做完,错题标记出来
参数传递与指针
①今日考情 · 真题分布与备考建议
本考点在 GESP C++ 4级近 14 期真题中共 48 道客观题(单选 31 / 判断 17,其中 5 道需看原卷配图)。本页把这一考点的真题全部收进来了,一道没漏,按每 10 题一张卡分组,可分次完成。
本期分布
| 期次 | 题数 |
|---|---|
| 2023年12月 C++ 4级 | 3 |
| 2023年6月 C++ 4级 | 5 |
| 2023年9月 C++ 4级 | 3 |
| 2024年12月 C++ 4级 | 3 |
| 2024年3月 C++ 4级 | 5 |
| 2024年6月 C++ 4级 | 7 |
| 2025年12月 C++ 4级 | 5 |
| 2025年3月 C++ 4级 | 4 |
| 2025年6月 C++ 4级 | 2 |
| 2025年9月 C++ 4级 | 3 |
| 2026年3月 C++ 4级 | 4 |
| 2026年9月 C++ 4级 | 4 |
配套教材
GESP 大通关 4 级(全书 58 页):本天对应 4.2 参数传递与指针。教材按同一套大纲顺序编排,可对照阅读。
备考建议(出题人视角)
参数传递与指针是四级最难的一天,也是丢分最多的一天。三条必须分清:**值传递(改不了)**、**引用传递(能改)**、**指针传递(要解引用才改)**。另外 `&a` 是取地址、`*p` 是解引用,两个符号千万别混。建议每个点都写一段三行代码亲手跑一遍,光看是记不住的。
②知识地图 · 本考点思维导图
- 三种传递方式
- 值传递 void f(int x) 改不了实参
- 引用传递 void f(int &x) 能改实参
- 指针传递 void f(int *p) 要 *p 才能改
- 两个关键符号
- &a 取 a 的地址(定义引用时也写作 &)
- *p 取 p 指向的值(解引用)
- 指针基本概念
- 指针变量存的是**地址**
- int *p = &a; p 指向 a
- *p 就是 a 本身
- 引用
- int &r = a; r 是 a 的别名
- 引用必须初始化,且不能改指向
- 引用不是对象,不占独立空间
- 经典用途:交换两个变量
- 值传递换不了,必须引用或指针
③核心精讲
1. 三种传递方式对比
void byValue(int x)   { x = 100; }     // ① 值传递
void byRef(int &x)    { x = 100; }     // ② 引用传递
void byPtr(int *p)    { *p = 100; }    // ③ 指针传递

int main() {
    int a = 5;
    byValue(a);  cout << a;   // 5    没变
    byRef(a);    cout << a;   // 100  变了
    byPtr(&a);   cout << a;   // 100  变了
}| 方式 | 写法 | 能否改实参 | 说明 |
|---|---|---|---|
| 值传递 | void f(int x) | ❌ 不能 | 改的是副本 |
| 引用传递 | void f(int &x) | ✅ 能 | x 是实参的别名 |
| 指针传递 | void f(int *p) | ✅ 能(要 *p) | p 存的是地址 |
易错:指针传递时,
p = 100;是错的(把地址改成 100); 必须写*p = 100;才能改到实参。
2. & 和 * 的两个身份
| 符号 | 出现在定义里 | 出现在使用里 |
|---|---|---|
& | int &r = a; 声明引用 | &a 取地址 |
* | int *p; 声明指针 | *p 取指向的值 |
int a = 10;
int *p = &a;      // 定义指针 p,&a 取地址
cout << p;        // 打印地址(一个十六进制数)
cout << *p;       // 打印 10(解引用)
*p = 20;          // 等价于 a = 20
3. 指针与数组
int a[5] = {1, 2, 3, 4, 5};
int *p = a;         // 数组名就是首元素地址
cout << *p;         // 1
cout << *(p + 2);   // 3  ← 等价于 a[2]
a[i] 与 *(a + i) 完全等价,这是读程序题常考的一个点。
4. 引用
int a = 10;
int &r = a;     // r 是 a 的别名
r = 20; // a 也变成 20- 引用必须初始化:
int &r;编译错误。 - 引用一旦绑定不能改:
r = b;是把 b 的值赋给 a,不是让 r 改指 b。
5. 经典例题:交换两个变量
void swapWrong(int a, int b) { int t = a; a = b; b = t; }   // 无效
void swapRef(int &a, int &b) { int t = a; a = b; b = t; }   // 有效
void swapPtr(int *a, int *b) { int t = *a; *a = *b; *b = t; } // 有效要点:值传递的 swap 是四级最经典的"看起来对、其实无效"的代码。
6. 一分钟记忆卡
- 值传递改不了,引用传递能改,指针传递要
*p才能改 &在定义里是引用,在使用里是取地址*在定义里是指针,在使用里是解引用a[i]等价于*(a + i)- 引用必须初始化,且不能改绑
- 交换必须用引用或指针


int a = 5;
int *p = a;
int a = 5;
int* p1 = &a;
int* p2 = p1;
*p2 = 10;
int a = 10;
int b = 20;
const int *p = &a;

- 1.C 如果变量x的地址是0x6ffe14,下面C++代码执行以后输出的是(…
- 2.D 假设变量a 的地址是0x6ffe14,下面程序的输出是( )。…
- 3.B 如果下列程序输出的地址是0x6ffe00,则cout<<a+1<<e…
- 4.B int& a 和&a 是一样的,都是取a 的地址。…
- 5.B 假设整数数组arr[4]= {0, 1, 2, 3}; 的第一个元素…
- 6.B 以下代码能正确初始化指针。…
- 7.C 小杨想让指针 p 指向整数变量 x,正确写法是( )。…
- 8.C 小杨写了如下的指针接力程序,程序执行完后变量 a、*p1 和*p2 …
- 9.B 关于下面指针声明的说法,正确的是( )。…
- 10.A 下列程序横线处,应该输入的是 ( )。…
int count = 8;
int *p = &count;
*p += 4;
cout << count << " " << *p;
return 0;
p = &a[2];,则执行a[1] = *p;后,数组a 中的值会变为()。
- 11.C 小杨使用指针修改计数器的值。执行下面程序后,输出结果是( )。…
- 12.B 一个变量定义为int *p = nullptr;,则下列说法正确的是…
- 13.A 一个数组定义为int a[5] = {1, 2, 3, 4, 5};…
- 14.B 如果n 为int 类型的变量,一个指针变量定义为int *p = &…
- 15.A 一个数组定义为int a[5] = {1, 2, 3, 4, 5};…
- 16.B 在C++语言中,指针变量在逻辑上指向另一个变量在内存中的位置,指针变…
- 17.A 小杨今年春节回奶奶家了,奶奶家的数字电视要设置ip地址并接入到WIF…
- 18.A 引用是一个指针常量。…
- 19.D 以下哪种参数传递方式可以避免拷贝大型对象?…
- 20.A 在C++中,声明一个指向整型变量的指针的正确语法是( )。…
int arr[5] = {1, 2, 3, 4, 5};
int* p1 = arr;
int* p2 = arr + 2;

cout << p2 - p1;  // 输出结果
struct pass{
    int no;
    char name[20];
    int level;
};

int main()
{
    struct pass XiaoYang;

    cout << "&XiaoYang=" << &XiaoYang << endl;  //第11行
    cout << "&(XiaoYang.no)=" << &(XiaoYang.no) << endl; //第12行

    cout << endl;
    return 0;
}int x[10][10][10]={{0}};
int *p;
p=&x[0][0][0];
cout<<p<<endl;
cout<<++p<<endl;int x = 20; int* p = &x; *p = *p + 2;
int a = 10;
int* p = &a;
*p = 20
- 21.C 以下关于数组的描述中,( )是错误的。…
- 22.B 执行下面的C++代码,会输出 8,因为两个指针地址相差 8 个字节(…
- 23.B 在 C++ 中,如果声明了一个指针变量但没有显式初始化,该指针会自动…
- 24.B 在下列代码的横线处填写( ),可以使得输出是“20 10”。…
- 25.B 下列C++语句执行以后结果是true的是( )。…
- 26.C 对二维数组int arr[3][16];,若arr 的地址是0x28…
- 27.B 在如下的C++代码执行后,设第11和12行的输出地址值分别为X 和Y…
- 28.D 下面程序中,如果语句 cout<<p<<endl; 输出的是0x6f…
- 29.D 运行下面代码片段后,x 和*p 的结果分别是( )。…
- 30.B 执行下述代码后,变量a 的值为( )。…
int a = 42;
int* p = &a;
*p = *p + 1;
int arr[3][4] = {{1,2,3,4}, {5,6,7,8}, {9,10,11,12}};
int* p = &arr[0][0];int x = 5; int *p = &x; *p = *p + 3;
int main() {
    int a = 5;
    int* p = &a;
    int** q = &p;
    **q += 7;
    cout << a << " " << *p;
}int a[3][4] = {
{1,2,3,4},
{5,6,7,8},
{9,10,11,12}
};
int (*p)[4] = a;struct Book {
string name;
int pages;
};
int main() {
Book books[2] = {{"C++", 120}, {"Math", 150}};
Book *p = books + 1;
p->pages += 10;
cout << books[1].name << " " << books[1].pages;
return 0;
}int a = 10; int *p = &a; *p += 5;
int main()
{
    char *p="I love GESP!";
    cout << p+5 << endl;

    cout << endl;
    return 0;
}int main() {
int a[2][3];
cout << &a[1][2] - &a[0][1] << endl;
return 0;
}- 31.B 运行下面程序后变量a 的值是( )。…
- 32.D 执行完下面的代码后,*(p + 5) 和 arr[1][1] 的值分…
- 33.A 小杨正在调试他的温度传感器程序,其中变量 x 保存当前温度。下面这段…
- 34.B 执行下面代码后,输出为( )。…
- 35.B 已知: 则表达式 *(*(p + 2) + 1) 的值为( )。…
- 36.C 小杨定义了结构体数组,并使用指针访问其中的元素。执行下面代码后输出的…
- 37.A 执行下面程序后,变量 a 的值为 15。…
- 38.C 下面C++代码执行后输出是( )。…
- 39.B 执行下面代码,输出结果为 5。…
- 40.C 下列关于C++语言中指针的叙述,不正确的是( )。…
int* ptr;
*ptr = 10;
void swap(int a, int &b) {
    int temp = a;
    a = b;
    b = temp;
}
int main() {
    int x = 1, y = 2;
    swap(x, y);
    std::cout << x << y;
    return 0;
}- 41.B 在 C++ 中,下面代码可以正确定义指针和初始化指针。…
- 42.D 执行下述代码,将输出( )。…
- 43.B 在C++语言中,函数的参数默认以引用传递方式进行传递。…
- 44.A 下面有关函数参数的说法,正确的是( )。…
- 45.B 在C++语言中,函数的参数为指针时,可以在函数内部修改该参数的值。(…
- 46.A 函数参数传递过程中,如果传常量值、常量引用和常量指针都是不能被修改的…
- 47.B 函数参数可以通过值传递、引用传递和指针传递,这样函数内对参数的修改可…
- 48.A 在C++中,相比于值传递,使用引用传递作的优点可以直接操作和修改原始…
④今日打卡 · 点一下就能勾选
- 写出值传递、引用传递、指针传递三个版本,说明哪个能改实参
- 解释
p = 100;与*p = 100;的区别,指出哪个是错的 - 分清
&在定义(引用)与使用(取地址)中的两种含义 - 证明
a[i]与*(a + i)等价,用数组前三个元素举例 - 说明引用为什么必须初始化、为什么不能改绑
- 写一个真正有效的 swap 函数(引用版),并解释值传递版为什么无效
- 把本日 48 道客观题做完,错题标记出来
结构体
①今日考情 · 真题分布与备考建议
本考点在 GESP C++ 4级近 14 期真题中共 18 道客观题(单选 10 / 判断 8,其中 0 道需看原卷配图)。本页把这一考点的真题全部收进来了,一道没漏,按每 10 题一张卡分组,可分次完成。
本期分布
| 期次 | 题数 |
|---|---|
| 2023年9月 C++ 4级 | 2 |
| 2024年12月 C++ 4级 | 1 |
| 2025年12月 C++ 4级 | 3 |
| 2025年3月 C++ 4级 | 3 |
| 2025年6月 C++ 4级 | 2 |
| 2025年9月 C++ 4级 | 3 |
| 2026年3月 C++ 4级 | 3 |
| 2026年9月 C++ 4级 | 1 |
配套教材
GESP 大通关 4 级(全书 58 页):本天对应 4.3 结构体。教材按同一套大纲顺序编排,可对照阅读。
备考建议(出题人视角)
结构体在四级考的是"会不会用":定义、成员访问、结构体数组、配合 sort 排序。最容易丢分的是两个细节:**定义末尾的分号**(少写了编译错误)和 **`.` 与 `->` 的区别**(对象用点、指针用箭头)。多关键字排序的 cmp 写法也是常考点,记住"先判不等再比次关键字"。
②知识地图 · 本考点思维导图
- 定义
- struct 名字 { 成员列表 };
- **末尾必须有分号**
- 成员可以是不同类型
- 变量与数组
- struct Stu { ... } s1, s2;
- Stu a[100]; 结构体数组
- 成员访问
- 普通变量:s.name
- 指针变量:p->name(等价 (*p).name)
- 结构体套结构体:s.birth.year
- 配合 sort 排序
- cmp 返回 true 表示「a 排在 b 前面」
- 单关键字:return a.score > b.score;
- 多关键字:先判不等,再比次关键字
- 常见陷阱
- 定义末尾漏分号
- cmp 用 >= 会运行错误
- 结构体整体不能直接用 == 比较(要自定义)
③核心精讲
1. 定义与使用
struct Student {
    string name;
    int score;
    double height;
};                      // ← 分号不能少

Student s;
s.name = "小明";
s.score = 95;易错:
struct { ... }末尾必须有分号,漏了就是编译错误,而且报错位置很迷惑。
2. 成员访问:. 与 ->
| 变量类型 | 访问方式 | 例子 |
|---|---|---|
| 普通变量 | . | s.name |
| 指针变量 | -> | p->name |
| 指针解引用 | . | (*p).name |
Student s;
Student *p = &s;
s.name = "A";      // 普通变量用点
p->name = "B";     // 指针用箭头
(*p).name = "C"; // 等价写法易错:
p.name是错的(p 是指针),必须p->name。
3. 结构体数组
Student a[100];
for (int i = 0; i < n; i++)
    cin >> a[i].name >> a[i].score;
4. 配合 sort 排序
// 按分数从高到低
bool cmp(Student a, Student b) {
    return a.score > b.score;      // 降序用 >
}

sort(a, a + n, cmp);
cmp 的读法:返回 true 表示「a 应该排在 b 前面」。 所以 > 是降序,< 是升序。
多关键字排序:
bool cmp(Student a, Student b) {
    if (a.score != b.score) return a.score > b.score;  // 先比主关键字
    return a.name < b.name;                            // 并列时比次关键字
}易错:cmp 里写
>=会让相等元素也返回 true, 排序算法可能陷入非法状态而运行错误。必须用严格>或<。
5. 结构体套结构体
struct Date { int y, m, d; };
struct Student {
    string name;
    Date birth;        // 嵌套
};
Student s;
s.birth.y = 2014;      // 逐层用点
6. 一分钟记忆卡
- 定义末尾必须有分号
- 普通变量用
.,指针用-> p->x等价(*p).x- cmp 返回 true 表示 a 排前面;
>降序、<升序 - 多关键字:先判不等,再比次关键字
- cmp 里不要用
>=/<=
struct Person {
    std::string name;
    int age;
    struct Address {
        std::string street;
        std::string city;
    };
    Address address;
};struct Point {int x,y;};struct Student {
string name;
int age;
float score;
};
Student* students = new Student[20];struct GameCharacter {
string name;
int level;
float position_x;
float position_y;
struct Equipment {
string weapon;
int attack_bonus;
int defense_bonus;
} equipment;
struct Skill {
string name;
int damage;
} skills[8];
int skill_count;
};struct Point {
int x;
int y;
};
Point p{3, 4};- 1.D 给定如下代码,下面描述错误的是( )。…
- 2.A 结构体的成员默认是public 访问权限。…
- 3.B 关于结构体初始化,以下哪个选项中正确的是( )。…
- 4.A 以下C++代码合法。…
- 5.B 一个结构体不能包含另一个结构体。…
- 6.B 下列关于结构体初始化的写法,正确的是( )。…
- 7.A 下面代码没有语法错误。…
- 8.A 下面结构体初始化语句是合法的。…
- 9.A 在C++语言中,可以通过定义结构体,定义一个新的数据类型。…
- 10.A 在C++语言中,可以定义结构体类型的数组变量,定义结构体时也可以包含…
#include <string>
#include <vector>

using namespace std;

struct Library {
    struct Book {
        struct Author {
            string name;
            int birthYear;
        };

        string title;
        int year;
        Author author;
    };

    string name;
    vector<Book> books;
};struct Point {
int x, y;
};
struct Rectangle {
Point topLeft;
Point bottomRight;
};
int main() {
Rectangle rect = {{10, 10}, {20, 20}};
rect.topLeft.x = 5;
Point* p = &rect.bottomRight;
p->y = 5;
cout << rect.topLeft.x + rect.bottomRight.y;
return 0;
}struct Cat {
string name;
int age;
};
void birthday(Cat& c) {
c.age++;
}
int main() {
Cat kitty{"Mimi", 2};
birthday(kitty);
cout << kitty.name << " " << kitty.age;
}struct Player {
string name;
int score;
};
// 玩家索引playerIdx的分数刚刚更新,需要调整位置
void updateRanking(Player players[], int size, int playerIdx) {
Player updatedPlayer = players[playerIdx];
if (playerIdx > 0 && updatedPlayer.score > players[playerIdx - 1].score) {
int i = playerIdx;
while (____________________) { // 在此处填入代码
players[i] = players[i - 1];
i--;
}
players[i] = updatedPlayer;
}
else if (playerIdx < size - 1 && updatedPlayer.score < players[playerIdx + 1].score) {
int i = playerIdx;
while (____________________) { // 在此处填入代码
players[i] = players[i + 1];
i++;
}
players[i] = updatedPlayer;
}
}struct S { int a; int b; };
void g(S s){ s.a += 10; }
void h(S& s){ s.b += 10; }
int main(){
S s{1,2};
g(s);
h(s);
cout << s.a << " " << s.b;
}- 11.D 下面的描述中,( )不能正确定义一个名为Student 的结构体以及…
- 12.C 下面的描述中,( )正确定义一个名为Person 的结构体并正确初始…
- 13.B 下面c++代码在一个结构体中又定义了别的结构体。这种结构嵌套定义的方…
- 14.A 运行如下代码会输出( )。…
- 15.B 运行如下代码会输出( )。…
- 16.A 某游戏的排行榜系统需要实时更新玩家分数。每次只有一个玩家的分数发生变…
- 17.B 执行下面代码后输出为( )。…
- 18.C 在C++中,如果希望通过函数修改传入的结构体对象的内容,应该使用哪种…
④今日打卡 · 点一下就能勾选
- 写出一个学生结构体(姓名/分数/身高)并定义两个变量赋值
- 说明结构体定义末尾的分号为什么不能少
- 对比
s.name、p->name、(*p).name三种写法 - 写出按分数降序的 cmp,并说明为什么用 > 而不是 <
- 写一个双关键字排序的 cmp(分数降序、姓名升序)
- 解释 cmp 里写 >= 为什么会运行错误
- 把本日 18 道客观题做完,错题标记出来
二维数组与多维数组
①今日考情 · 真题分布与备考建议
本考点在 GESP C++ 4级近 14 期真题中共 20 道客观题(单选 14 / 判断 6,其中 1 道需看原卷配图)。本页把这一考点的真题全部收进来了,一道没漏,按每 10 题一张卡分组,可分次完成。
本期分布
| 期次 | 题数 |
|---|---|
| 2023年6月 C++ 4级 | 3 |
| 2023年9月 C++ 4级 | 1 |
| 2024年12月 C++ 4级 | 3 |
| 2024年3月 C++ 4级 | 2 |
| 2024年6月 C++ 4级 | 1 |
| 2025年12月 C++ 4级 | 2 |
| 2025年3月 C++ 4级 | 2 |
| 2025年6月 C++ 4级 | 2 |
| 2025年9月 C++ 4级 | 1 |
| 2026年9月 C++ 4级 | 3 |
配套教材
GESP 大通关 4 级(全书 58 页):本天对应 4.4 二维数组与多维数组。教材按同一套大纲顺序编排,可对照阅读。
备考建议(出题人视角)
二维数组在四级是"读程序题大户":矩阵的遍历、对角线、转置、行列最值,每一种都能出一题。最关键的认知是**二维数组在内存里是按行连续存放的**,所以 `a[i][j]` 的前一个元素是 `a[i][j-1]`(同列换行时才跳)。读题一律先画矩阵表。
②知识地图 · 本考点思维导图
- 定义与初始化
- int a[3][4]; 3 行 4 列,下标都从 0 起
- int a[3][4] = {{1,2,3,4},{5,6,7,8},{9,10,11,12}};
- 行数可省,列数不能省
- 遍历
- 外层 i 跑行,内层 j 跑列
- 按行优先:a[0][0] a[0][1] … a[1][0] …
- 四类高频题型
- 主对角线:i == j → a[i][i]
- 副对角线:i + j == n-1
- 上三角 / 下三角:j > i / j < i
- 转置:b[j][i] = a[i][j]
- 每行 / 每列的处理
- 行和:固定 i,累加 a[i][j]
- 列和:固定 j,累加 a[i][j]
- 常见陷阱
- 行列写反(a[j][i] 不是 a[i][j])
- 循环上界写成 <= n 越界
③核心精讲
1. 定义与遍历
int a[3][4];                     // 3 行 4 列
for (int i = 0; i < 3; i++)
    for (int j = 0; j < 4; j++)
        cin >> a[i][j];
行和列的下标都从 0 开始:合法的行下标 0~2,列下标 0~3。
易错:
int a[3][4]是 3 行 4 列,不是 4 行 3 列(前面的数是行)。
2. 内存是"按行连续存放"的
a[0][0] a[0][1] a[0][2] a[0][3] | a[1][0] a[1][1] ...所以 a[i][j] 的下一个元素是 a[i][j+1];只有到行末才跳到 a[i+1][0]。 这也解释了为什么外层循环跑行、内层跑列时访问最快。
3. 四类高频题型
① 主对角线
for (int i = 0; i < n; i++) sum += a[i][i]; // i == j② 副对角线
for (int i = 0; i < n; i++) sum += a[i][n-1-i]; // i + j == n-1③ 上三角 / 下三角
for (int i = 0; i < n; i++)
    for (int j = 0; j < n; j++) {
        if (j > i)  upper += a[i][j];   // 上三角
        if (j < i)  lower += a[i][j];   // 下三角
    }
④ 转置
for (int i = 0; i < n; i++)
    for (int j = 0; j < m; j++)
b[j][i] = a[i][j]; // 行列互换易错:转置必须
b[j][i] = a[i][j],写反了就等于没转。
4. 每行 / 每列的处理
// 每行的和
for (int i = 0; i < n; i++) {
    int s = 0;
    for (int j = 0; j < m; j++) s += a[i][j];
    cout << s << endl;
}

// 每列的和
for (int j = 0; j < m; j++) {
    int s = 0;
    for (int i = 0; i < n; i++) s += a[i][j];   // 注意 i、j 互换位置
    cout << s << endl;
}判断口诀:行和固定 i 变 j,列和固定 j 变 i。
5. 多维数组
int c[2][3][4];      // 2 层 × 3 行 × 4 列
c[1][2][3] = 7;
三维以上一般只考"定义与访问",很少考复杂遍历。
6. 一分钟记忆卡
a[3][4]= 3 行 4 列,下标从 0 起- 内存按行连续存,所以外层跑行内层跑列最快
- 主对角线
i==j,副对角线i+j==n-1 - 转置
b[j][i] = a[i][j] - 行和固定 i,列和固定 j
- 行数可省,列数不能省
int a[3][4] = {
    {1, 0, 1, 0},
    {0, 1, 0, 1},
    {1, 1, 0, 0}
};int a[2][4] = {{1, 2, 3, 4}, {5, 6, 7, 8}};void printArray(________) {
for (int i = 0; i < 3; ++i)
for (int j = 0; j < 4; ++j)
std::cout << arr[i][j] << " ";
}void addOne(________, int r) {
for (int j = 0; j < 5; j++) {
arr[r][j]++;
}
}
int main()
{
    char *s[]={(char*)"2024",(char*)"3.16",(char*)"GESP"};

    for (int i=0; i< 2; i++){
        cout << *s+i << endl;
    }

    cout << endl;
    return 0;
}- 1.D 在C++中,int arr[3][4] 和 int* arr = n…
- 2.B 小杨用一个二维数组表示棋盘,其中 1 表示有棋子,0 表示没有棋子。…
- 3.D 下列关于C++语言中数组的叙述,不正确的是( )。…
- 4.D 对二维数组int arr[3][16];,则arr[1] 占用内存的…
- 5.B int arr[3][] 是一个正确的二维数组的声明。…
- 6.A 下面二维数组在内存中按行优先连续存储,因此 *(*(a + 1) +…
- 7.D 下面的函数接收一个3行4列的二维数组并输出其中元素,则横线上不能填写…
- 8.C 下面函数用于将一个 3 行 5 列二维数组的第 r 行元素全部加 1…
- 9.A 在下面这个程序里,a[i][j] 和一个普通的整型变量一样使用。…
- 10.C 执行下列C++代码时输出中的第2行是( )。…
int goods[3][4] = {{2, 4, 6, 8}, {10, 12, 14, 16}, {18, 20, 22, 24}};
int (*p)[4] = goods;
int x = *(*(p + 1) + 2);void f(int arr[][4], int rows) {
// 访问 arr[i][j]
}
int main() {
int arr[3][4] = { /* 初始化 */ };
f(arr, 3);
}int array[2][3] = {
{0, 1, 2},
{3, 4, 5}
};- 11.D 一个二维数组定义为double array[3][10];,则这个二…
- 12.C 一个二维数组定义为int array[5][3];,则array[1…
- 13.B 一个二维数组定义为char array[3][10];,则这个二维数…
- 14.D 下面( )正确定义二维数组。…
- 15.B 下面( )正确定义了二维数组。…
- 16.A 在 C++ 中,定义如下二维数组:int a[3][4];,数组 a…
- 17.B 小杨用二维数组记录仓库货物数量。执行下面代码后,变量 x 的值是( …
- 18.B 二维数组作为函数参数时,必须显式指定所有维度的大小。…
- 19.B 下面代码将二维数组arr 传递给函数f,函数内部用arr[i][j]…
- 20.D 假定整型是32位,对一个2行3列的二维整数数组array ,假设数组…
④今日打卡 · 点一下就能勾选
- 默写 3 行 4 列二维数组的定义与双层遍历,标明行列下标范围
- 说明二维数组在内存中的存放顺序,解释为什么外层跑行更快
- 写出主对角线与副对角线的求和代码,标出判断条件
- 写出转置的代码,说明为什么是 b[j][i] = a[i][j]
- 写「每行和」与「每列和」两段代码,指出 i、j 的区别
- 列举二维数组的两个常见错误(行列写反、上界越界)
- 把本日 20 道客观题做完,错题标记出来
递推
①今日考情 · 真题分布与备考建议
本考点在 GESP C++ 4级近 14 期真题中共 16 道客观题(单选 7 / 判断 9,其中 0 道需看原卷配图)。本页把这一考点的真题全部收进来了,一道没漏,按每 10 题一张卡分组,可分次完成。
本期分布
| 期次 | 题数 |
|---|---|
| 2023年6月 C++ 4级 | 1 |
| 2023年9月 C++ 4级 | 1 |
| 2024年12月 C++ 4级 | 3 |
| 2024年3月 C++ 4级 | 1 |
| 2024年6月 C++ 4级 | 2 |
| 2025年12月 C++ 4级 | 1 |
| 2025年3月 C++ 4级 | 2 |
| 2025年6月 C++ 4级 | 3 |
| 2025年9月 C++ 4级 | 1 |
| 2026年3月 C++ 4级 | 1 |
配套教材
GESP 大通关 4 级(全书 58 页):本天对应 4.5 递推。教材按同一套大纲顺序编排,可对照阅读。
备考建议(出题人视角)
递推是四级里"最有算法味"的一天,也是复赛的前置。核心就一句话:**用前面的项算出后面的项**。命题人的考法很固定:给递推式求第 n 项,要求你列表逐项算。最容易错的是**初值定错**和**下标从 0 还是 1 起**。务必养成"先把前 5 项写出来"的习惯,前 5 项对了,规律就清楚了。
②知识地图 · 本考点思维导图
- 三个要素
- ① 递推式:a[n] 用 a[n-1]、a[n-2] 表示
- ② 初值:a[1]、a[2] 是多少(必须给)
- ③ 边界:n 从几算到几
- 正向递推(循环实现)
- 一维:a[i] = a[i-1] + a[i-2]
- 二维:f[i][j] = f[i-1][j] + f[i][j-1]
- 典型模型
- 斐波那契:1 1 2 3 5 8 13
- 爬楼梯:f(n) = f(n-1) + f(n-2)
- 平面分割:f(n) = f(n-1) + n
- 错排:D(n) = (n-1)(D(n-1) + D(n-2))
- 递推 vs 递归
- 递归:从 n 往下问,有重复计算
- 递推:从初值往上算,每项只算一次
- 常见陷阱
- 初值少给一个
- 下标越界(a[0] 没定义)
- 结果溢出 int(要用 long long)
③核心精讲
1. 递推的三个要素
// 斐波那契:a[i] = a[i-1] + a[i-2]
long long a[100];
a[1] = 1;  a[2] = 1;                 // ② 初值(必须给两项)
for (int i = 3; i <= n; i++)         // ③ 从第 3 项开始推
    a[i] = a[i-1] + a[i-2];          // ① 递推式
cout << a[n];| 要素 | 含义 | 缺了会怎样 |
|---|---|---|
| 递推式 | 后项怎么由前项算出 | 无从下手 |
| 初值 | 最开始的一两项 | 全错或越界 |
| 边界 | 从第几项开始循环 | 下标越界 |
2. 列表是最稳的解法
以 f(n) = f(n-1) + n,f(1) = 1 为例:
| n | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| f(n) | 1 | 3 | 6 | 10 | 15 |
前 5 项一写,规律立刻出来(这是 1+2+…+n)。读程序题也靠这张表。
3. 四个典型模型
| 模型 | 递推式 | 初值 | 前几项 |
|---|---|---|---|
| 斐波那契 | a[i] = a[i-1] + a[i-2] | 1, 1 | 1 1 2 3 5 8 |
| 爬楼梯 | f(n) = f(n-1) + f(n-2) | 1, 2 | 1 2 3 5 8 |
| 平面分割 | f(n) = f(n-1) + n | 1 | 1 3 6 10 15 |
| 错排 | D(n) = (n-1)(D(n-1) + D(n-2)) | 0, 1 | 0 1 2 9 44 |
易错:爬楼梯的初值是
f(1)=1, f(2)=2,和斐波那契不一样,别混。
4. 递推与递归的关系
| 递归 | 递推 | |
|---|---|---|
| 方向 | 从 n 往回问 | 从初值往前算 |
| 重复计算 | 有(f(n-2) 被算很多次) | 无(每项只算一次) |
| 效率 | 慢(指数级) | 快(线性) |
| 写法 | 函数自己调自己 | 一个循环 |
同一个问题,递推通常比递归快得多——这是四级常考的一句话。
5. 二维递推
// 杨辉三角:f[i][j] = f[i-1][j-1] + f[i-1][j]
f[1][1] = 1;
for (int i = 2; i <= n; i++)
    for (int j = 1; j <= i; j++)
        f[i][j] = f[i-1][j-1] + f[i-1][j];
6. 精度与溢出
斐波那契第 50 项已经超过 int 范围,必须用 long long。 看到"求第 n 项"且 n 较大,一律先想会不会溢出。
7. 一分钟记忆卡
- 三要素:递推式、初值、边界
- 先列前 5 项,规律自然出来
- 斐波那契 1 1 2 3 5;爬楼梯 1 2 3 5 8(初值不同)
- 递推比递归快:无重复计算
- 二维递推看杨辉三角
- 大数用 long long 防溢出
int fib(int n) {
    if (n == 0 || n == 1)
        return n;

    int f1 = 0;
    int f2 = 1;
    int result = 0;
    for (int i = 2; i <= n; i++) {
        ________________________________     // 在此处填入代码
    }
    return result;
}int f(int n) {
if (n == 1 || n == 2)
return n;
int f1 = 1;
int f2 = 2;
int res = 0;
for (int i = 3; i <= n; i++) {
________________________________ // 在此处填入代码
}
return res;
}int factorial(int n) {
int res = 1;
for (int i = 0; i < n; ++i) {
res *= i;
}
return res;
}int fib(int n)
{
int i, f[n]={0, 1};
for(int i=2; i<=n; i++)
f[i]=f[i-1]+f[i-2];
return f[n];
}- 1.A 下面代码采用递推算法来计算斐波那契数列f(n) = f(n − 1)…
- 2.A 数列1, 1, 2, 3, 5, 8 ... 是以意大利数学家列昂纳…
- 3.A 一个一维数组,至少含有一个自然数N,是一个合法的数列。可以在一维数组…
- 4.A 递推是一种通过已知的初始值和递推公式,逐步求解目标值的算法。…
- 5.A 递推是一种通过已知的初始值和递推公式,逐步求解目标值的算法。…
- 6.B 以下关于递推算法基本思想的描述,正确的是( )。…
- 7.A 递推是在给定初始条件下,已知前一项(或前几项)求后一项的过程。…
- 8.B 小杨正在爬楼梯,需要爬n阶才能到达楼顶。如果每次可以爬1个或2个台阶…
- 9.B 以下程序中使用了递推方式计算阶乘(n! = 1 × 2. . . ×…
- 10.A 下面C++函数中采用的算法是( )。…
int fibonacci(int n) {
    if (n == 0) return 0;
    if (n == 1) return 1;
    return fibonacci(n - 1) + fibonacci(n - 2);
}int n = 10;
int f[20];
f[0] = 0;
f[1] = 1;
for (int i = 2; i <= n; i++)
f[i] = f[i - 1] + f[i - 2];int fib(int n) {
if (n <= 1) return n;
int f0 = 0, f1 = 1, cur = 0;
for (int i = 2; i <= n; i++) {
cur = f0 + f1;
f0 = f1;
f1 = cur;
}
return cur;
}- 11.A 下面关于递推的说法不正确的是( )。…
- 12.A 某算法的递推关系式为 T(n) = T(n − 1) + n(n为正…
- 13.D 下述斐波那契数列计算的时间复杂度是( )。…
- 14.A 考虑用如下递推方式计算斐波那契数列,时间复杂度是 O(n)。…
- 15.B 下面用递推方式计算斐波那契数列第 n 项的程序,时间复杂度是 O(2…
- 16.D 下列关于C++语言中数组的叙述,不正确的是( )。…
④今日打卡 · 点一下就能勾选
- 写出斐波那契的递推代码,标明初值、递推式、循环边界
- 为 f(n)=f(n−1)+n(f(1)=1)列出前 5 项,说出它的通项
- 对比爬楼梯与斐波那契的初值差异,说明为什么不同
- 默写四个典型模型的递推式与初值(斐波那契/爬楼梯/平面分割/错排)
- 说明递推为什么比递归快,各写一段代码对比
- 解释「求第 50 项要用 long long」的原因
- 把本日 16 道客观题做完,错题标记出来
排序与算法复杂度
①今日考情 · 真题分布与备考建议
本考点在 GESP C++ 4级近 14 期真题中共 59 道客观题(单选 37 / 判断 22,其中 2 道需看原卷配图)。本页把这一考点的真题全部收进来了,一道没漏,按每 10 题一张卡分组,可分次完成。
本期分布
| 期次 | 题数 |
|---|---|
| 2023年12月 C++ 4级 | 3 |
| 2023年6月 C++ 4级 | 2 |
| 2023年9月 C++ 4级 | 3 |
| 2024年12月 C++ 4级 | 7 |
| 2024年3月 C++ 4级 | 3 |
| 2024年6月 C++ 4级 | 5 |
| 2025年12月 C++ 4级 | 5 |
| 2025年3月 C++ 4级 | 6 |
| 2025年6月 C++ 4级 | 6 |
| 2025年9月 C++ 4级 | 7 |
| 2026年3月 C++ 4级 | 5 |
| 2026年9月 C++ 4级 | 7 |
配套教材
GESP 大通关 4 级(全书 58 页):本天对应 4.6 排序与算法复杂度。教材按同一套大纲顺序编排,可对照阅读。
备考建议(出题人视角)
四级的排序考三件事:**三种排序的过程**(尤其交换/比较次数)、**稳定性**(哪些稳定)、**复杂度**(谁是 O(n²)、谁是 O(n log n))。冒泡和选择、插入的手推一定要练,因为读程序题会给一段排序代码问中间结果。稳定性记法:**冒泡、插入、归并稳定;选择、快排、堆排不稳定**。
②知识地图 · 本考点思维导图
- 三种基础排序
- 冒泡:相邻两两比较,大的往后冒
- 交换次数 = 逆序对数
- 选择:每轮找最小,放到前面
- 交换次数最少(最多 n−1 次)
- 插入:把当前元素插入前面已排好的部分
- 接近有序时最快
- 稳定性
- 稳定:冒泡、插入、归并
- 不稳定:选择、快速、堆
- 复杂度
- O(n²):冒泡、选择、插入
- O(n log n):快速(平均)、归并、堆
- 快速最坏 O(n²)(已有序时)
- 复杂度估算
- O(1) < O(log n) < O(n) < O(n log n) < O(n²) < O(2ⁿ)
- n=10⁵ 时 O(n²) 会超时,O(n log n) 可以
③核心精讲
1. 三种基础排序的过程
冒泡排序:相邻两个比较,大的往后换。
原始:3 1 4 2
第1趟:1 3 2 4   (3↔1,4↔2)
第2趟:1 2 3 4   (3↔2)
第3趟:1 2 3 4   (无交换,结束)
交换次数 = 逆序对数。3 1 4 2 的逆序对有 (3,1)(3,2)(4,2) = 3 对。
选择排序:每轮从剩下里找最小,和本轮首位交换。
原始:3 1 4 2
第1轮:1 3 4 2   (找最小 1,与 3 换)
第2轮:1 2 4 3   (找最小 2,与 3 换)
第3轮:1 2 3 4 (找最小 3,与 4 换)交换次数最少,最多 n−1 次。
插入排序:把当前元素插到前面已排好的合适位置。
原始:3 | 1 4 2
插 1:1 3 | 4 2
插 4:1 3 4 | 2
插 2:1 2 3 4接近有序时最快。
2. 稳定性
稳定 = 两个相等的元素,排序后相对顺序不变。
| 排序 | 稳定? | 记忆 |
|---|---|---|
| 冒泡 | ✅ 稳定 | 只换相邻,相等不换 |
| 插入 | ✅ 稳定 | 插在相等元素后面 |
| 归并 | ✅ 稳定 | 合并时优先取左边 |
| 选择 | ❌ 不稳定 | 远距离交换会打乱 |
| 快速 | ❌ 不稳定 | 分区交换跨距离 |
| 堆排序 | ❌ 不稳定 | 堆顶下沉跨距离 |
易错:选择排序不稳定是常考的陷阱。记住"冒插归稳,选快堆不稳"。
3. 时间复杂度
| 排序 | 平均 | 最坏 | 空间 |
|---|---|---|---|
| 冒泡 | O(n²) | O(n²) | O(1) |
| 选择 | O(n²) | O(n²) | O(1) |
| 插入 | O(n²) | O(n²) | O(1) |
| 快速 | O(n log n) | O(n²) | O(log n) |
| 归并 | O(n log n) | O(n log n) | O(n) |
| 堆 | O(n log n) | O(n log n) | O(1) |
易错:快速排序最坏是 O(n²)(数组已有序且取首元素为基准),不是 O(n log n)。
4. 复杂度大小顺序与规模对照
O(1) < O(log n) < O(n) < O(n log n) < O(n²) < O(n³) < O(2ⁿ) < O(n!)| 复杂度 | n = 10⁵ 时大约运算次数 | 1 秒内能否完成 |
|---|---|---|
| O(n) | 10⁵ | ✅ 轻松 |
| O(n log n) | 约 1.7×10⁶ | ✅ 可以 |
| O(n²) | 10¹⁰ | ❌ 超时 |
经验值:1 秒大约能跑 10⁸ 次基本运算。
5. 读排序代码的方法
给一段排序代码问"第 k 趟后的结果",做法:
- 认准是哪一种排序(看循环结构和交换方式)
- 按趟画数组状态
- 数清每趟交换了几次、比较了几次
6. 一分钟记忆卡
- 冒泡交换次数 = 逆序对数
- 选择排序交换最少(≤ n−1)
- 插入排序接近有序时最快
- 稳定:冒泡、插入、归并;不稳定:选择、快速、堆
- 快排平均 O(n log n),最坏 O(n²)
- 1 秒约 10⁸ 次运算
- 1.C 对包含n 个元素的数组进行冒泡排序,平均时间复杂度一般为( )。…
- 2.A 对N个元素的数组执行插入排序算法,通常的时间复杂度是O(N²)。…
- 3.C 插入排序在最好情况下的时间复杂度是( )。…
- 4.D 关于直接插入排序,下列说法错误的是( )…
- 5.A 插入排序算法中,平均时间复杂度是O(n²),最坏的情况逆序情况下,达…
- 6.A 冒泡排序的平均时间复杂度为 O(n²),但最优情况下为O(n)。…
- 7.B 下面关于排序稳定性的描述,正确的是( )。…
- 8.B 插入排序在最好情况(已有序)下的时间复杂度是O(n²)。…
- 9.B 关于插入排序的时间复杂度,下列说法正确的是( )。…
- 10.A 虽然插入排序的时间复杂度为 O (n²),但由于单元操作相对较少,因…


int a[8]={ 2,3, 4, 5, 6,2,3,1};
for (int i=1;i<8;i++)
{

    int key = a[i];
    int j=i-1;
    while(a[j]>key && j>=0)
    {
        ________;
        j -= 1;

    }
    a[j + 1]= key;
}- 11.B 由于选择排序和插入排序的时间复杂度均为 O(n²),在任何实际场景下…
- 12.C 关于冒泡排序、插入排序和选择排序,下列说法正确的是( )。…
- 13.C 下面关于排序算法(冒泡排序、插入排序和选择排序)的描述中,不正确的是…
- 14.C 排序算法是稳定的(Stable Sorting),就是指排序算法可以…
- 15.A 在下列代码的横线处填写( ),完成对有n 个int 类型元素的数组a…
- 16.C 在下列代码的横线处填写( ),完成对有n 个int 类型元素的数组a…
- 17.A 对int a[]={2,0,2,4,3,1,6},执行第一趟选择排序…
- 18.A 如果待排序数据不能都装进内存,需要使用外排序算法。( )…
- 19.B 关于几种排序算法的说法,下面说法错误的是( )。…
- 20.D 下面的排序算法程序中,横线处应该填入的是( )。…
- 21.B 冒泡排序的第一轮操作是从左到右遍历数组,通过两两比较相邻元素,将当前…
- 22.A 冒泡排序和插入排序都是稳定的排序算法。…
- 23.B 选择排序是稳定的排序算法。…
- 24.A 对数组arr[]={5, 3, 8, 1} 进行升序排序,执行第一轮…
- 25.B 对数组arr[]={4, 3, 1, 5, 2} 进行升序排序,执行…
- 26.B 小杨在整理一副扑克牌的所有红心扑克牌,使其从小到大排列。他的做法是:…
- 27.A 无论初始数组是否有序,选择排序都执行 O (n²) 次比较…
- 28.C 关于排序算法的稳定性,以下说法错误的是( )。…
- 29.B 对整数数组{4, 1, 3, 1, 5, 2} 进行冒泡排序(将最大…
- 30.A 冒泡排序和插入排序都是稳定排序算法。…
while (j >= 0 && a[j] >= key) {
    a[j + 1] = a[j];
    j--;
}int cnt = 0;
for (int i = 0; i < n; i++) {
for (int j = i + 1; j < n; j++) {
for (int k = j + 1; k < n; k++) {
if (scores[i] + scores[j] + scores[k] == 300) {
cnt++;
}
}
}
}int cnt=0;
for(int i=0; i<n; i++){
for(int j=0; j<n; j++){
if( (i+j) % 3 == 0) cnt++;
}
}for (int i = 0; i < n; i++) {
for (int j = 1; j < n; j *= 2) {
cout << i + j;
}
}int cellRecur(int n) {
if (n == 1)
return 1;
return cellRecur(n - 1) + cellRecur(n - 1) + 1;
}bool f(int arr[], int n, int target) {
for (int i = 0; i < (1 << n); i++) {
int sum = 0;
for (int j = 0; j < n; j++) {
if (i & (1 << j)) {
sum += arr[j];
}
}
if (sum == target) return true;
}
return false;
}bool f(int arr[], int n, int target) {
for (int i = 0; i < n; i++) {
int sum = 0;
for (int j = 0; j < n; j++) {
if (i & (1 << j)) {
sum += arr[j];
}
}
if (sum == target) return true;
}
return false;
}bool f(int arr[], int n, int target) {
for (int i = 0; i < n; i++) {
int sum = 0;
for (int j = 0; j < n; j++) {
if (i & (1 << j)) {
sum += arr[j];
}
}
if (sum == target) return true;
}
return false;
}- 31.B 某排序算法对如下数据排序(按 score 升序),则下面关于该排序算…
- 32.B 对于按升序实现的稳定插入排序,移动元素的条件通常应为 a[j] >=…
- 33.A 考虑最坏情况下冒泡排序算法的时间复杂度,T(n)为待排序数字的数目为…
- 34.C 假设有一个班级的成绩单,存储在一个长度为 n 的数组 scores …
- 35.C 下列代码段的时间复杂度为( )。…
- 36.B 下面两层循环的时间复杂度是 O(n²)。…
- 37.B 给定如下代码,其时间复杂度为( )。…
- 38.B 给定如下算法,其时间复杂度为( )。…
- 39.B 给定如下算法,其时间复杂度为( )。…
- 40.B 给定如下算法,其时间复杂度为( )。…
int countPairs(int a[], int n) {
    int cnt = 0;
    for (int i = 0; i < n; i++) {
        for (int j = i + 1; j < n; j++) {
            if (a[i] + a[j] == 100) {
                cnt++;
            }
        }
    }
    return cnt;
}void bubbleSortWithFlag(vector<int> &nums) {
for (int i = nums.size() - 1; i > 0; i--) {
bool flag;
________________ // 在此处填入代码
for (int j = 0; j < i; j++) {
if (nums[j] > nums[j + 1]) {
swap(nums[j], nums[j + 1]);
___________________________ // 在此处填入代码
}
}
if (!flag)
break;
}
}for (int i = 0; i < n - 1; ++i) {
int minIndex = i;
for (int j = i + 1; j < n; ++j) {
if (arr[j] < arr[minIndex])
minIndex = j;
}
if (minIndex != i)
swap(arr[i], arr[minIndex]);
}void insertion_sort(vector<int> &nums) {
for (int i = 1; i < nums.size(); i++) {
________________________________ { // 在此处填入代码
while (j >= 0 && nums[j] > base)
nums[j + 1] = nums[j];
j--;
}
nums[j + 1] = base;
}
}void selectionSort(vector<int>& nums) {
int n = nums.size();
for (int i = 0; i < n - 1; ++i) {
int minIndex = i;
for (int j = i + 1; j < n; ++j) {
if ( __________ ) { // 在此处填入代码
minIndex = j;
}
}
____________________; // 在此处填入代码
}
}void insertionSort(int arr[], int n) {
for (int i = 1; i < n; i++) {
int key = arr[i];
int j = i - 1;
while ( j >= 0 && ____________________ ) { // 在此处填入代码
arr[j + 1] = arr[j];
j--;
}
____________________; // 在此处填入代码
}
}- 41.D 下面代码的时间复杂度是( )。…
- 42.B 为了提高冒泡排序的效率,如果某轮“冒泡”中没有执行任何交换操作,说明…
- 43.C 以下哪种情况是使用插入排序的合适场景?…
- 44.A 以下C++代码,尝试对有n 个整数的数组arr 进行排序。这个代码实…
- 45.A 数组{45,66,23,1,10,97,52,88,5,33}进行从…
- 46.A C++的内置函数sort() 支持数组的局部排序。例如int a={…
- 47.A C++内置函数sort() 可以对整数、浮点数、字符数组进行从大到小…
- 48.A 下面代码实现了插入排序函数,则横线上应填写( )。…
- 49.A 下面代码试图实现选择排序,使其能对数组 nums 排序为升序,则横线…
- 50.A 下面程序实现插入排序(升序排序),则横线上应分别填写( )。…
void sort(int a[], int n) {
    for (int i = 1; i < n; i++) {
        int x = a[i];
        int j = i - 1;
        while (j >= 0 && a[j] > x) {
            a[j + 1] = a[j];
            j--;
        }
        a[j + 1] = x;
    }
}void ins(int a[], int n){
for(int i = 1; i < n; i++){
int key = a[i];
int j = i-1;
while(j >= 0 && __________){
a[j+1] = a[j];
j--;
}
a[j+1] = key;
}
}void insertionSort(int a[], int n) {
for (int i = 1; i < n; i++) {
int key = a[i];
int j = i - 1;
while (j >= 0 && __________) {
a[j + 1] = a[j];
j--;
}
a[j + 1] = key;
}
}void bubbleSort(int a[], int n) {
for (int i = n - 1; i > 0; i--) {
bool changed = __________;
for (int j = 0; j < i; j++) {
if (a[j] > a[j + 1]) {
int t = a[j];
a[j] = a[j + 1];
a[j + 1] = t;
changed = __________;
}
}
if (!changed)
break;
}
}struct Card {
int value;
char suit; // 花色
};
Card cards[4] = {{5,'A'}, {3,'B'}, {5,'C'}, {3,'D'}};struct Student {
string name;
int score;
};
void selectTopK(Student students[], int n, int k) {
for (int i = 0; i < k; i++) {
int maxIdx = i;
for (____________________) { // 在此处填入代码
if (students[j].score > students[maxIdx].score) {
maxIdx = j;
}
}
if (maxIdx != i) {
Student temp = students[i];
students[i] = students[maxIdx];
students[maxIdx] = temp;
}
}
}struct Player{ int score; };
void up(Player players[], int n, int idx){
Player cur = players[idx];
int i = idx;
while( ____________________ ){
players[i] = players[i-1];
i--;
}
players[i] = cur;
}struct student {
int score;
char id;
};
(90, 'A'), (80, 'B'), (90, 'C'), (80, 'D')
(80, 'B'), (80, 'D'), (90, 'C'), (90, 'A')- 51.B 下面这段代码实现了选择排序算法。…
- 52.B 下面代码试图把数组按升序进行“插入排序”,横线处应填写( )。…
- 53.B 下面代码使用插入排序将数组按升序排列,横线处应填写( )。…
- 54.A 下面函数使用冒泡排序将数组按升序排列。为了在数组已经有序时提前结束,…
- 55.A 用递归法求n的阶乘,时间复杂度是O(n)。…
- 56.B 对如下4个扑克牌进行排序,使用某排序算法按value排序后,结果为:…
- 57.B 下面的函数 selectTopK() 实现从 n 个学生中选出前 k…
- 58.A 下列函数实现排行榜中单个元素的位置调整(类似插入排序的相邻搬移)。当…
- 59.C 对一组 struct student 的学生按成绩(score)升序…
④今日打卡 · 点一下就能勾选
- 手推 3 1 4 2 的冒泡过程,数出交换次数并与逆序对数对照
- 手推 3 1 4 2 的选择排序与插入排序过程,比较交换次数
- 默写六种排序的稳定性(冒插归稳定,选快堆不稳定)
- 默写三种基础排序与快排、归并的复杂度,指出快排最坏情况
- 排出 O(1) 到 O(2ⁿ) 的大小顺序,说明 n=10⁵ 时 O(n²) 为什么超时
- 说出「1 秒约 10⁸ 次运算」这条经验值,并据此判断 O(n log n) 能否过关
- 把本日 59 道客观题做完,错题标记出来
文件操作与综合
①今日考情 · 真题分布与备考建议
本考点在 GESP C++ 4级近 14 期真题中共 74 道客观题(单选 44 / 判断 30,其中 21 道需看原卷配图)。本页把这一考点的真题全部收进来了,一道没漏,按每 10 题一张卡分组,可分次完成。
本期分布
| 期次 | 题数 |
|---|---|
| 2023年12月 C++ 4级 | 19 |
| 2023年6月 C++ 4级 | 7 |
| 2023年9月 C++ 4级 | 7 |
| 2024年12月 C++ 4级 | 3 |
| 2024年3月 C++ 4级 | 6 |
| 2024年6月 C++ 4级 | 8 |
| 2025年12月 C++ 4级 | 4 |
| 2025年3月 C++ 4级 | 4 |
| 2025年6月 C++ 4级 | 5 |
| 2025年9月 C++ 4级 | 3 |
| 2026年3月 C++ 4级 | 4 |
| 2026年9月 C++ 4级 | 4 |
配套教材
GESP 大通关 4 级(全书 58 页):本天对应 4.7 文件操作与异常处理。教材按同一套大纲顺序编排,可对照阅读。
备考建议(出题人视角)
最后一天收口:文件操作只考 `freopen` 的两行写法(复赛必备),异常处理只考 try-catch 的基本结构,剩下时间用来把四级前六天的易错点过一遍。文件那两行是"背了就有分、没背就丢分"的典型,务必让学生默写到能闭眼写出来。
②知识地图 · 本考点思维导图
- 为什么需要文件重定向
- 复赛评测时程序从 .in 读、写到 .out
- 用 freopen 把 cin/cout 绑到文件上
- freopen 两行(必背)
- freopen("in.txt", "r", stdin);
- freopen("out.txt", "w", stdout);
- 文件读写模式
- "r" 读 "w" 写(清空重写) "a" 追加
- 忘了写就默认按文本打开
- 异常处理
- try { 可能出错的代码 }
- catch (类型 e) { 出错后怎么办 }
- throw 抛出异常
- 四级综合(把前六天串起来)
- 函数 + 数组 + 排序 + 递推
- 读程序:先找函数调用顺序,再列表
③核心精讲
1. freopen:复赛的敲门砖
#include <cstdio>
int main() {
    freopen("data.in",  "r", stdin);    // 把 cin 改成从文件读
    freopen("data.out", "w", stdout);   // 把 cout 改成写文件

    int n;
    cin >> n;                          // 实际是从 data.in 读
    cout << n * 2;                     // 实际是写到 data.out
    return 0;
}| 参数 | 含义 |
|---|---|
| 第一个 | 文件名(含扩展名) |
| 第二个 | "r" 读 / "w" 写(清空)/ "a" 追加 |
| 第三个 | stdin(标准输入)或 stdout(标准输出) |
易错:
"w"会清空原文件重新写;想保留原内容追加要用"a"。 这两行必须写在main的最开头,在第一次输入输出之前。
2. 其他文件读写方式(了解)
#include <fstream>
ifstream fin("data.in");      // 读文件
ofstream fout("data.out");    // 写文件
fin >> n;
fout << n;
fin.close();  fout.close();
四级只要求认识 freopen 和 ifstream/ofstream 的名字与作用,不要求复杂操作。
3. 异常处理
try {
    int a = 10, b = 0;
    if (b == 0) throw "除数为 0";   // 抛出
    cout << a / b;
} catch (const char* e) {           // 捕获,类型要匹配
    cout << "出错了:" << e;
}| 关键字 | 作用 |
|---|---|
try | 包住可能出错的代码 |
throw | 抛出一个异常 |
catch | 接住异常并处理 |
要点:
catch后面的类型要和throw的类型对得上,否则接不住。
4. 四级综合:把六天串起来
四级的读程序题经常是"函数里套数组、数组上跑排序、排序里用递推"。 破题顺序固定:
① 先看 main 里调用了哪些函数,排出调用顺序
② 再逐个函数看它做了什么(输入 → 处理 → 返回什么)
③ 数组类的题一律画下标表
④ 排序类的题一律按趟画状态
⑤ 递推类的题一律列前 5 项
5. 四级高频易错清单
| 考点 | 最常见的错 |
|---|---|
| 函数 | 以为返回值由 return 的值决定(实际由定义决定) |
| 传递 | 以为值传递能改实参 |
| 指针 | p = 100 与 *p = 100 混用 |
| 结构体 | 定义末尾漏分号;p.name 应为 p->name |
| 二维数组 | 行列写反;转置写成 b[i][j]=a[i][j] |
| 递推 | 初值少给一项;结果溢出 int |
| 排序 | 以为选择排序稳定;以为快排一定 O(n log n) |
| 文件 | "w" 当 "a" 用;freopen 写在输入之后 |
6. 一分钟记忆卡
freopen("in.txt","r",stdin);+freopen("out.txt","w",stdout);"r"读 /"w"清空重写 /"a"追加- try 包代码、throw 抛、catch 接(类型要匹配)
- 读程序五步:调用顺序 → 逐个函数 → 数组画表 → 排序按趟 → 递推列项
- 四级八条易错清单,考前默一遍


ifstream in("data.txt");
string line;
while (getline(in, line)) {
    cout << line << endl;
}ofstream out("data.txt");
out << "Hello";
out.close();ofstream file("data.txt");
cout<<"Hello"<< endl;
file.close();ofstream fout("data.txt");
cout << "Hello";
fout.close();- 1.B 在下面的C++代码中,将对1.txt文件写入hello。( )…
- 2.B 文本文件1.txt 第1行由01234 共5个字符组成其间没有空格,…
- 3.D C++中,关于文件路径说法错误的是( )…
- 4.C 下面哪种方式不能实现将字符串"Welcome to GESP!"输出…
- 5.C 下面哪种方式不能实现将字符串"Happy Spring!" 输出重定…
- 6.C 关于下面 C++ 程序的描述,( )最准确。…
- 7.A 下面C++代码实现将 Hello 写入 data.txt。…
- 8.B 以下代码将 Hello 写入文件 data.txt。…
- 9.B 下面哪种方式不能实现将字符串 Welcome to 2026! 输出…
- 10.B 下面程序能够把 Hello 写入 data.txt 文件中。…
50 2024 3.16 I
love
GESP!
int main()
{
    ifstream fin;
    string line;
    int x;
    fin.open("1.txt",ios::in);

    for (int i=0; i< 2; i++){
        fin >> line;
        cout << line << endl;
    }
    fin>>x;
    cout << x << endl; //####

    cout << endl;
    return 0;
}int main() {
ofstream fout("test.txt");
fout << "Happy" << endl;
fout << "New Year";
fout.close();
ifstream fin("test.txt");
string s1, s2;
fin >> s1;
getline(fin, s2);
fin.close();
cout << s1 << "|" << s2;
return 0;
}int main() {
ofstream fout("data.txt");
fout << 10 << " " << 20 << endl;
fout << 30 << " " << 40;
fout.close();
ifstream fin("data.txt");
int a, b, c, d;
fin >> a >> b >> c >> d;
fin.close();
cout << a + b + c + d;
return 0;
}Blue Sky
int main() {
ifstream fin("data.txt");
string a, b;
fin >> a >> b;
cout << b << "-" << a;
fin.close();
return 0;
}int main() {
ofstream fout("log.txt");
fout << "Welcome";
fout.close();
return 0;
}
- 11.C 如果文件1.txt 中的内容如下,则执行下面C++代码时,注释了##…
- 12.D 执行下面 C++ 程序,会输出( )。…
- 13.A 执行下面代码会输出 100。…
- 14.B 假设文件 data.txt 的内容如下:执行下面程序后,输出结果是(…
- 15.A 假设文件能够正常打开,下面程序会把 Welcome 写入 log.t…
- 16.A 由于文件重定向操作,程序员在使用C++语言编写程序时无法确定通过co…
- 17.A 下列关于C++语言中异常处理的叙述,正确的是( )。…
- 18.A 通过使用文件重定向操作,可以将程序中输出到cout 的内容输出到文件…
- 19.A 下面C++代码执行后生成的文件其字节数为( )。…
- 20.B 在C++中,异常处理机制(try-catch块)的主要目的是( )。…
int main() {
    try {
        throw 42;
    } catch (...) {
        cout << "Caught" << endl;
    }
    return 0;
}int divide(int a, int b) {
if(b == 0) throw "Division by zero";
return a / b;
}
int main() {
int result = 0;
try {
result = divide(10, 0);
cout << "A";
}
catch(const char* msg) {
cout << "B";
result = -1;
}
cout << result;
return 0;
}int divi(int a,int b){
if(b==0) throw 0;
return a/b;
}
int main(){
try{
cout << divi(10,0);
}catch(const char* msg){
cout << "A";
}catch(int){
cout << "B";
}
}int main() {
try {
int age = -1;
if (age < 0)
throw age;
cout << "A";
} catch (const char *msg) {
cout << "B";
} catch (int value) {
cout << "C" << value;
}
return 0;
}int main() {
try {
throw "Error";
} catch (int e) {
cout << "Caught";
}
return 0;
}- 21.B 如果一个异常在 try 块中抛出但没有任何 catch 匹配,它将在…
- 22.D 关于异常处理,以下说法错误的是( )。…
- 23.B 以下代码只能捕获int 类型异常。…
- 24.B 执行下面C++代码,会输出( )。…
- 25.B 执行下面程序,输出结果是( )。…
- 26.C 执行下面程序后,输出结果是( )。…
- 27.B 执行下面程序时,catch (int e) 能够捕获由 throw …
- 28.A 未捕获异常会调用std::terminate终止程序。…
- 29.D 高级语言编写的程序需要经过以下( )操作,可以生成在计算机上运行的可…
- 30.C 如果a 为int 类型的变量,且a 的值为6,则执行a &= 3;之…


- 31.D 执行以下C++语言程序后,输出结果是( )。…
- 32.B 域名是由一串用点分隔的名字来标识互联网上一个计算机或计算机组的名称,…
- 33.B 字符常量'0'和'\0'是等价的。…
- 34.A >=和>>=都是C++语言的运算符。…
- 35.B 人们所使用的手机上安装的App通常指的是( )。…
- 36.A 下列流程图的输出结果是?( )…
- 37.C 如果a 为int 类型的变量,且a 的值为6,则执行a = ~a; …
- 38.D 执行以下C++语言程序后,输出结果是( )。…
- 39.B == 和:= 都是C++语言的运算符。…
- 40.B 下面C++代码执行后,输出的是( )。…


- 41.D 下面C++代码最后执行后输出是( )。…
- 42.C 下面C++代码执行后的结果是( )。…
- 43.C 下面C++代码执行后输出是( )。…
- 44.A 在C++中,执行下面代码后,输出的是( )。…
- 45.A 在如下的C++代码中实现了对字符串中出现的26个字母的个数统计,横线…
- 46.D 下列C++代码输入1,2,3,4,执行后,将输出的是( )。…
- 47.A 以下C++代码用于实现每个整数对应的因数,如输入12,则输出1 2 …
- 48.C 某公司新出了一款无人驾驶的小汽车,通过声控智能驾驶系统,乘客只要告诉…
- 49.B 现代计算机是指电子计算机,它所基于的是( )体系结构。…
- 50.B 输入一个正整数N(N>=7),想找出它所有相邻的因数对,比如,输入1…

- 51.B [(1,2)*2]*3 在C++中是合法的表达式。( )…
- 52.A 执行C++代码cout<<(5||2); 后将输出1。( )…
- 53.A 在C++中,两个字符串相加的运算符为+相当于字符串的合并运算。下面C…
- 54.B 小杨最近在准备考GESP,他用的Dev C++来练习和运行程序,所以…
- 55.A 任何一个while循环都可以转化为等价的for循环( )。…
- 56.C 小杨的父母最近刚刚给他买了一块华为手表,他说手表上跑的是鸿蒙,这个鸿…
- 57.C 中国计算机学会(CCF)在2024年1月27日的颁奖典礼上颁布了王选…
- 58.B 在C++语言中try 子句里抛出的结构体等类型的异常无法被catch…
- 59.B C++语言中cout << 9^2 << endl; 会输出81。(…
- 60.A 任何一个for 循环都可以转化为等价的while 循环( )。…


double* p_arr = new double [3];
p_arr[0] = 0.2;
p_arr[1] = 0.5;
p_arr[2] = 0.8;
p_arr += 1;
cout << p_arr[0] << endl;
p_arr -= 1;
delete p_arr;
double hmean(double a, double b) {
    if (a == -b )
        throw runtime_error("Runtime error occurred");
    return 2.0*a*b/(a + b);
}

int main() {
    double x = 10;
    double y = -10;

    try {
        int result = hmean(x, y);
        cout << "hmean: " << result << endl;
    }
    catch (const runtime_error& e) {
        cout << "Caught: " << e.what() << endl;
    } catch (...) {
        cout << "Caught an unknown exception." << endl;
    }
    return 0;
}- 61.B 下列代码中,输出结果是( )…
- 62.B 下面程序输出的是( )…
- 63.A 下面的程序中,如果输入10 0,会输出( )。…
- 64.B 10条直线,最多可以把平面分为多少个区域( )。…
- 65.A 以下代码不能够正确执行。…
- 66.A 下面程序两个输出结果是一样的。…
- 67.A 下面代码输出的值等于0。…
- 68.B 运行下面代码,屏幕上输出是( )。…
- 69.A 运行下面的代码,将出现什么情况?( )…
- 70.D 假设int arr[2][3] = {{1,2,3},{4,5,6}…
double hmean(double a, double b) {
    if (a == -b )
        throw runtime_error("Runtime error occurred.");
    return 2.0*a*b/(a + b);
}

int main() {
    double x = 10;
    double y = -10;

    try {
        int result = hmean(x, y);
        cout << "hmean: " << result << endl;
    }
    catch (const runtime_error& e) {
        cout << "Caught: " << e.what() << endl;
    } catch (...) {
        cout << "Caught an unknown exception." << endl;
    }
    return 0;
}int arr[2][3][2] = {
{{1,2}, {3,4}, {5,6}},
{{7,8}, {9,10}, {11,12}}
};
int sum = 0;
for(int i = 0; i < 2; i++)
for(int j = 0; j < 3; j++)
for(int k = 0; k < 2; k++)
if((i+j+k) % 2 == 0)
sum += arr[i][j][k];- 71.A 运行下面的代码,将出现( )。…
- 72.B 下面这段代码不合法,因为每一行都必须显式初始化3个元素。 int a…
- 73.B 执行完下面的代码后,sum 的值是( )。…
- 74.A 引用一旦绑定某个变量,就不能再绑定其他变量。( )…
④今日打卡 · 点一下就能勾选
- 默写 freopen 的两行代码,标明 "r"/"w" 与 stdin/stdout 的位置
- 说明 "w" 与 "a" 两种模式的区别,误用会怎样
- 写出 try-throw-catch 的最小例子,指出 catch 的类型要与 throw 一致
- 背下读程序的五步破题顺序
- 默写四级八条高频易错清单(函数/传递/指针/结构体/二维/递推/排序/文件)
- 把前六天各自的「一分钟记忆卡」串一遍,标出自己最不熟的两条
- 把本日 74 道客观题做完,错题标记出来
枚举与判定
①本日知识点 · 枚举与判定
定范围、写条件、逐个试;能推出的量就别多写一层循环。
本组 6 道题全部来自 GESP 真题,按「枚举与判定」归在一起练。题面取洛谷原题(含公式与样例),题解取美力程 GESP 题解库(思路 + 参考代码 + 复杂度)。
在本题中,我们将给出 N 个不同进制的数。你需要分别把它们转换成十进制数。
保证 N ≤ 1000;保证 2 ≤ K ≤ 16。
保证所有 K 进制数的位数不超过 9。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 2 8 1362 16 3F0 | 754 1008 |
| 2 | 2 2 11011 10 123456789 | 27 123456789 |
1. 八进制数 1362 对应的十进制数为:1×8^3+3×8^2+6×8^1+2×8^0=754;
2. 十六进制数 3F0 对应的十进制数为:3×16^2+15×16^1+0×16^0=1008。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
N 进制数逢 N 进一。十六进制中用字母 A ~ F 表示 10 ~ 15。
给出 N 个不同进制的数,请分别把它们转换成十进制数。每行输入一个整数 K 和一个 K 进制数(由数字和大写字母组成、不以 0 开头、保证合法)。
例:八进制 1362 = 1×8³ + 3×8² + 6×8¹ + 2×8⁰ = 754;十六进制 3F0 = 3×16² + 15×16 + 0 = 1008。
💡人话翻译:把每一位数字乘上它的"位权"再相加。但更省事的写法是从左到右累乘:每读一位,就把当前结果乘 K 再加这一位的值。这样不用计算幂,一趟扫描就够。
🔍 关键词提取
Horner 法则字符转数值从左到右累乘避免幂运算
已知条件
项目说明
输入第一行 N;随后 N 行每行 K 和 K 进制数
输出N 行,每行对应的十进制数
数据范围N ≤ 1000,2 ≤ K ≤ 16
位数每个数不超过 9 位
字符集数字与大写字母,不以 0 开头
需要解决的问题
位权怎么算?不用单独算幂!用累乘:res = res * K + digit
字母怎么转数值?'0'~'9' → 0 ~ 9;'A'~'F' → 10 ~ 15
结果会溢出吗?9 位的十六进制数最大约 16⁹ ≈ 6.9 × 10¹⁰,超过 int,必须用 long long
📥 读入
N ≤ 1000
每行 K 和字符串
位数 ≤ 9
结果用 long long
🔤 字符转数值
'0'~'9' → 0~9
'A'~'F' → 10~15
用 if 或查表
K ≤ 16 只需到 F
🧮 Horner 累乘
res = 0
每读一位:res = res*K + digit
一趟扫描完成
不需要算幂
⚠️ 易错点
用 int 导致溢出
字母转换漏掉 +10
误以为要算幂
读入格式(K 和数之间有空格)
用"从左到右累乘"的方法,每读一位就乘 8 再加。
读入的位字符值计算过程res
11res = 0 × 8 + 11
33res = 1 × 8 + 311
66res = 11 × 8 + 694
22res = 94 × 8 + 2754
1
与"位权法"对照
位权法:1×8³ + 3×8² + 6×8¹ + 2×8⁰
= 512 + 192 + 48 + 2 = 754
累乘法每步的结果:1 → 11 → 94 → 754
两者结果完全一致
✅ 两种方法等价
2
为什么累乘法更好?
位权法要先算出 8³、8²、8¹ 等幂次
或者从右往左处理
累乘法只用一个变量、一趟从左到右
代码更短,也不容易出错
✅ 推荐累乘法
八进制 1362 = 754 ✓
🧮 样例:十六进制 3F0 → 1008
注意 F 要转成数值 15。
读入的位字符值计算过程res
33res = 0 × 16 + 33
F15res = 3 × 16 + 1563
00res = 63 × 16 + 01008
十六进制 3F0 = 1008 ✓
🔤 字符转数值对照
字符数值字符数值字符数值
'0'0'5'5'A'10
'1'1'6'6'B'11
'2'2'7'7'C'12
'3'3'8'8'D'13
'4'4'9'9'E'14
————'F'15
⚠️一定要用 long long:9 位十六进制数的最大值是 16⁹ − 1 = 68719476735,远超 int 上限(约 2.1 × 10⁹)。用 int 存结果会溢出,这是本题最容易失分的地方。
🟢 Horner 从左到右累乘(推荐) 推荐
res = res * K + digit,一趟扫描
时间 O(位数)
代码 5 行
不需要算幂
天然处理任意位数
💡原理:把 (...((d₁ × K + d₂) × K + d₃) × K + ...) 展开后恰好等于 d₁K^(n-1) + d₂K^(n-2) + ...,与位权法完全等价。
🟠 位权法(从右往左)
从最低位开始,每位乘 K 的对应次幂再累加
需要计算或维护幂 K^i
要么写 pow()(浮点,不安全)
要么自己维护一个递推的幂
代码更长
⚠️注意:用 pow(K, i) 会引入浮点误差,对 10¹⁰ 量级的整数可能算错最后几位,整数题里应避免用 pow。
📈 性能对比
方案代码量风险
Horner 累乘约 5 行无
位权法 + pow约 10 行浮点误差
每行输入"K 和 K 进制数"(空格分隔),程序会展示逐位累乘过程。
输入(每行一组)8 1362
16 3F0
2 11011
10 123456789
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
// 字符 -> 数值:'0'~'9' 为 0~9,'A'~'F' 为 10~15
int charVal(char c) {
if (c >= '0' && c <= '9') return c - '0';
return c - 'A' + 10;
}
int main() {
int n;
scanf("%d", &n);
while (n--) {
int k;
char s[20];
scanf("%d %s", &k, s); // K 和进制数之间用空格分隔
long long res = 0; // 必须用 long long
for (int i = 0; s[i]; i++) {
res = res * k + charVal(s[i]); // Horner 累乘
}
printf("%lld\n", res);
}
return 0;
}
🔑为什么 res * k + digit 能算出正确的位权?展开看:处理完前 m 位后,res 正好是这 m 位的值。再读一位时,前面所有位的"权重"都乘了 k(相当于左移一位),新位则加在最低位——这与手算"每位乘对应幂再相加"的结果完全一致,而且不需要显式计算幂。
📖 关键几行怎么看
代码作用为什么这样写
c - '0'数字字符转值'0' 的 ASCII 是 48
c - 'A' + 10字母转值A 对应 10
res = res * k + charVal(s[i])Horner 累乘一行完成"左移一位 + 加新位"
long long res类型选择9 位十六进制可达 6.9 × 10¹⁰,超过 int
⚠️三个坑:① 用 int 存结果导致溢出;② 字母转换写成 c - 'A'(漏掉 +10);③ 输出格式用 %d 而不是 %lld。
写完程序后,用这些数据自查一遍:
输入答案考察点
8 1362754题面样例 1
16 3F01008题面样例 1
2 1101127题面样例 2
10 123456789123456789十进制本身(验证算法无损)
16 FFFFFFFF42949672958 位十六进制,超过 int 上限
16 FFFFFFFFF687194767359 位十六进制,必须用 long long
✅自查清单:① 结果用 long long 了吗?② 字母 +10 了吗?③ 输出用 %lld 了吗?
🚨 易错点清单
⚠️用 int 存结果:9 位十六进制可达 6.87 × 10¹⁰,会溢出,必须用 long long。
⚠️字母转换漏 +10:F 应该是 15,写成 c - 'A' 会得到 5。
⚠️用 pow 算位权:pow(16, 8) 返回浮点数,大数时可能丢失精度。
时间复杂度
O(N × 位数)
空间复杂度
O(1)
位数
≤ 9
N 最大
1000
时间怎么算的?
每个数逐位处理一次
位数不超过 9
N ≤ 1000 时总共约 9000 次运算
空间都用在哪?
只需要一个累加变量。
✅ 运算量不到 1 万次,瞬间完成。这题考的是 Horner 累乘技巧和对数据类型的选择。
// 任意进制转十进制(Horner 法则)
long long toDecimal(const string &s, int base) {
long long res = 0;
for (char c : s) res = res * base + charVal(c);
return res;
}
// 十进制转任意进制(除基取余,逆序拼接)
string fromDecimal(long long n, int base) {
const string DIG = "0123456789ABCDEF";
if (n == 0) return "0";
string ans;
while (n > 0) { ans = DIG[n % base] + ans; n /= base; }
return ans;
}
// 溢出检查技巧:把 res * base + d 改写为判断形式
if (res > (LLONG_MAX - d) / base) { /* 会溢出 */ }
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
Horner 法则从左到右累乘所有进制转换题
字符与数值互转数字/字母统一映射进制、编码、密码类题目
数据类型选择预估最大值再选类型所有涉及乘加累加的题目
🌟思考题:如果题目要求"把十进制数转成 K 进制"(与本题方向相反),该怎么做?(提示:用除基取余——反复对 K 取余得到低位、除以 K 缩小,最后把余数序列倒序拼接。这正是 GESP 三级"进制转换"一题的解法,两者正好互为逆运算。)
#include <bits/stdc++.h>

using namespace std;


// 字符 -> 数值:'0'~'9' 为 0~9,'A'~'F' 为 10~15

int charVal(char c) {

    if (c >= '0' && c <= '9') return c - '0';

    return c - 'A' + 10;

}


int main() {

    int n;

    scanf("%d", &n);


    while (n--) {

        int k;

        char s[20];

        scanf("%d %s", &k, s);       // K 和进制数之间用空格分隔


        long long res = 0;           // 必须用 long long

        for (int i = 0; s[i]; i++) {

            res = res * k + charVal(s[i]);   // Horner 累乘

        }


        printf("%lld\n", res);

    }

    return 0;

}// 任意进制转十进制(Horner 法则)
long long toDecimal(const string &s, int base) {
long long res = 0;
for (char c : s) res = res * base + charVal(c);
return res;
}
// 十进制转任意进制(除基取余,逆序拼接)
string fromDecimal(long long n, int base) {
const string DIG = "0123456789ABCDEF";
if (n == 0) return "0";
string ans;
while (n > 0) { ans = DIG[n % base] + ans; n /= base; }
return ans;
}
// 溢出检查技巧:把 res * base + d 改写为判断形式
if (res > (LLONG_MAX - d) / base) { /* 会溢出 */ }接下来 n 行,每行 m 个整数 a_{i,1}, a_{i,2}, …, a_{i,m},表示各行中的网格是否适合排兵。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 4 3 0 1 1 1 0 1 0 1 1 1 1 1 | 4 |
| 2 | 3 5 1 0 1 0 1 0 1 0 1 0 0 1 1 1 0 | 3 |
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
地图是 n 行 m 列的网格,适合排兵的格子标 1、不适合的标 0。现在需要选一个矩形区域排兵,要求区域内不能包含任何 0。问可选的矩形区域最多能包含多少个网格。
💡人话翻译:找出一个"全是 1 的矩形",让它包含的格子最多。注意 n, m ≤ 12,数据非常小——这暗示我们可以用比较暴力的做法:直接枚举矩形的上下左右四条边。
🔍 关键词提取
最大全 1 矩形枚举边界数据量小前缀和验证
已知条件
项目说明
输入第一行 n、m;随后 n 行每行 m 个 0/1
输出全 1 矩形的最大网格数(面积)
数据范围1 ≤ n, m ≤ 12
网格值0 或 1
合法区域矩形内部不能含有 0
需要解决的问题
怎么枚举矩形?四重循环:上边界 r1、下边界 r2、左边界 c1、右边界 c2
怎么快速验证全 1?用二维前缀和 O(1) 判断,或直接累加(面积最大 144,很便宜)
要枚举多少种矩形?约 C(13,2)² ≈ 6000 种,每种检查 ≤ 144 格
📥 读入
n、m ≤ 12
0/1 网格
数据极小是重要提示
int 足够
🎯 枚举边界
r1 上边界
r2 下边界(r2 ≥ r1)
c1 左边界
c2 右边界(c2 ≥ c1)
✅ 验证全 1
统计区域内 1 的个数
个数 == 面积 → 全 1
或用二维前缀和 O(1)
合格就更新最大面积
⚠️ 易错点
边界循环范围写错
忘记 r2 ≥ r1
只数 1 的个数却搞错面积
max 初始化
0 1 1

1 0 1

0 1 1

1 1 1
1
先看能否找到 1 × 3 的横条
第 1 行:0 1 1 → 含 0,不行
第 2 行:1 0 1 → 含 0,不行
第 3 行:0 1 1 → 含 0,不行
第 4 行:1 1 1 → 全是 1,面积 3
目前最好:3
2
再看 2 × 2 的方块
第 3~4 行、第 2~3 列:
第 3 行第 2~3 列 = 1 1
第 4 行第 2~3 列 = 1 1
四格全是 1 → 面积 4
✅ 刷新为 4
3
能更大吗?
2 × 3 需要两行全是 1,但只有第 4 行满足
3 × 2 需要某两列连续三行全 1,检查后不成立
3 × 3 显然不行(第 1 行有 0)
✅ 最大值是 4
候选矩形位置面积是否全 1
1 × 3第 4 行3✅
2 × 2第 3~4 行、第 2~3 列4✅
2 × 3第 2~3 行—❌ 含 0
3 × 3任意位置—❌ 含 0
答案 4 ✓
🧮 样例 2:3 × 5 网格,答案 3
1 0 1 0 1

0 1 0 1 0

0 1 1 1 0
候选矩形位置面积是否全 1
1 × 3第 3 行第 2~4 列(1 1 1)3✅
2 × 1第 2~3 行某列2✅
2 × 2任意位置—❌ 均含 0
1 × 5任意行—❌ 均含 0
答案 3 ✓
🔑这道题的数据范围是"善意提示":n, m ≤ 12 意味着最多 12 × 12 = 144 个格子,矩形总数约 6000 个,每个最多检查 144 格 → 总共不到 100 万次运算。看到这么小的数据范围,就该放心用暴力枚举。如果 n, m 是 10³ 甚至 10⁵,那才需要用单调栈之类的进阶方法。
🟢 四重循环暴力(推荐) 推荐
枚举上下左右边界,逐格检查是否全 1
时间 O(n²m² × nm)
本题约 10⁶ 次,极快
代码 15 行
几乎不会写错
💡为什么推荐暴力:n, m ≤ 12 时暴力上限约 100 万次运算,远低于时间限制。用简单方法解决小数据,是最稳妥的策略。
🟠 单调栈求最大矩形
把问题逐行转化成"柱状图中的最大矩形"
时间 O(n × m),更快
但代码复杂(约 40 行)
需要理解单调栈
对本题属于过度设计
⚠️什么时候必须用:当 n, m 达到 10³ 时,暴力 O(n²m² × nm) 会超时,那时单调栈(O(nm))就是必修课了。建议:先掌握暴力,再学单调栈。
📈 性能对比
方案本题运算量n=m=1000 时
四重循环约 10⁶约 10¹²(超时)
单调栈约 1.4 × 10²约 10⁶(可行)
第一行输入 n 和 m,随后 n 行每行 m 个 0/1,程序会找出最大的全 1 矩形并高亮它。
输入数据4 3
0 1 1
1 0 1
0 1 1
1 1 1
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int a[15][15];
int main() {
int n, m;
scanf("%d %d", &n, &m);
for (int i = 0; i < n; i++)
for (int j = 0; j < m; j++)
scanf("%d", &a[i][j]);
int ans = 0;
// 四重循环枚举矩形的上下左右边界
for (int r1 = 0; r1 < n; r1++) {
for (int r2 = r1; r2 < n; r2++) {
for (int c1 = 0; c1 < m; c1++) {
for (int c2 = c1; c2 < m; c2++) {
int ones = 0;
int area = (r2 - r1 + 1) * (c2 - c1 + 1);
// 统计矩形内 1 的个数
for (int i = r1; i <= r2; i++)
for (int j = c1; j <= c2; j++)
if (a[i][j] == 1) ones++;
// 1 的个数等于面积,说明全是 1
if (ones == area && area > ans) ans = area;
}
}
}
}
printf("%d\n", ans);
return 0;
}
🔑"全是 1"的判定技巧:先算出矩形面积,再数里面有几个 1。如果个数 == 面积,就说明每格都是 1。这个"用计数代替逐格判断"的思路很常用,配合二维前缀和还能把判断降到 O(1)。
📖 关键几行怎么看
代码作用为什么这样写
r2 = r1 作为内层起点保证 r2 ≥ r1下边界不能在上边界之上
(r2-r1+1) * (c2-c1+1)计算面积行数 × 列数,注意 +1
if (ones == area)判定全 11 的个数等于格数,说明没有 0
if (area > ans) ans = area;取最大只有全 1 的矩形才参与比较
⚠️三个坑:① 边界循环写成 r2 = r1 + 1 起步,会漏掉所有"只有一行"的矩形;② 面积算成 (r2-r1)*(c2-c1),漏掉 +1;③ 只统计了 1 的个数却没和面积比较,导致含 0 的矩形也被算进去。
写完程序后,用这些数据自查一遍:
输入答案考察点
4 3
0 1 1 / 1 0 1 / 0 1 1 / 1 1 14题面样例 1
3 5
1 0 1 0 1 / 0 1 0 1 0 / 0 1 1 1 03题面样例 2
1 1
11单格且为 1
2 2
1 1 / 1 14全 1,整块都是
2 2
1 0 / 0 11只能选单个格子
1 4
1 1 1 14单行横向全 1
✅自查清单:① 四个边界循环范围对吗?② 面积公式对了吗?③ 验证过"全 1"吗?
🚨 易错点清单
⚠️下边界从上边界开始:必须允许 r2 = r1,否则会漏掉所有单行矩形。
⚠️面积公式漏 +1:行数是 r2 − r1 + 1,列数是 c2 − c1 + 1。
⚠️没有验证"全 1":必须比较 1 的个数与面积,否则含 0 的矩形也会被统计。
时间复杂度
O(n²m² × nm)
空间复杂度
O(nm)
n, m 最大
12
最坏运算
约 10⁶
时间怎么算的?
枚举上下边界:约 n²/2 种
枚举左右边界:约 m²/2 种
每种检查 nm 格
n = m = 12 时约 6000 × 144 ≈ 10⁶ 次
空间都用在哪?
只需一个 12 × 12 的网格数组。
✅ 约 100 万次运算,任何语言都能瞬间完成。数据范围小是这个解法成立的前提。
// 用"计数 == 面积"判断全 1(配合二维前缀和可做到 O(1))
long long pre[15][15];
// 矩形内 1 的个数 = 矩形和(因为 0 不贡献)
long long ones = pre[r2+1][c2+1] - pre[r1][c2+1] - pre[r2+1][c1] + pre[r1][c1];
long long area = (r2-r1+1) * (c2-c1+1);
if (ones == area) { /* 全 1 */ }
// 当 n, m 很大时的进阶做法:逐行转化为柱状图最大矩形(单调栈)
// 对每一行 i,维护 h[j] = 以 (i,j) 结尾的连续 1 的个数
// 然后在 h[] 上用单调栈求最大矩形面积,整体 O(nm)
for (int j = 0; j < m; j++) h[j] = a[i][j] ? h[j] + 1 : 0;
// ... 单调栈求 h[] 中的最大矩形
// 经典结论:n × m 网格中矩形总数 = n(n+1)/2 × m(m+1)/2
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
枚举边界四重循环给出所有矩形小规模网格的暴力解法
计数 == 面积判断区域是否全是 1棋盘、图像、区域判定
按数据范围选算法12 用暴力、1000 用单调栈所有题目的第一步决策
🌟思考题:如果题目要求矩形内1 的个数不少于 0 的个数(而不是全为 1),暴力解法要改哪里?(提示:把 ones == area 换成 ones * 2 >= area,统计方式不变。这说明"计数 == 面积"只是判定的一个特例,换成任意关于计数的条件都很容易扩展。)
0 1 1 1 0 1 0 1 1 1 1 1
1 0 1 0 1 0 1 0 1 0 0 1 1 1 0
#include <bits/stdc++.h>

using namespace std;


int a[15][15];


int main() {

    int n, m;

    scanf("%d %d", &n, &m);

    for (int i = 0; i < n; i++)

        for (int j = 0; j < m; j++)

            scanf("%d", &a[i][j]);


    int ans = 0;


    // 四重循环枚举矩形的上下左右边界

    for (int r1 = 0; r1 < n; r1++) {

        for (int r2 = r1; r2 < n; r2++) {

            for (int c1 = 0; c1 < m; c1++) {

                for (int c2 = c1; c2 < m; c2++) {

                    int ones = 0;

                    int area = (r2 - r1 + 1) * (c2 - c1 + 1);


                    // 统计矩形内 1 的个数

                    for (int i = r1; i <= r2; i++)

                        for (int j = c1; j <= c2; j++)

                            if (a[i][j] == 1) ones++;


                    // 1 的个数等于面积,说明全是 1

                    if (ones == area && area > ans) ans = area;

                }

            }

        }

    }


    printf("%d\n", ans);

    return 0;

}// 用"计数 == 面积"判断全 1(配合二维前缀和可做到 O(1))
long long pre[15][15];
// 矩形内 1 的个数 = 矩形和(因为 0 不贡献)
long long ones = pre[r2+1][c2+1] - pre[r1][c2+1] - pre[r2+1][c1] + pre[r1][c1];
long long area = (r2-r1+1) * (c2-c1+1);
if (ones == area) { /* 全 1 */ }
// 当 n, m 很大时的进阶做法:逐行转化为柱状图最大矩形(单调栈)
// 对每一行 i,维护 h[j] = 以 (i,j) 结尾的连续 1 的个数
// 然后在 h[] 上用单调栈求最大矩形面积,整体 O(nm)
for (int j = 0; j < m; j++) h[j] = a[i][j] ? h[j] + 1 : 0;
// ... 单调栈求 h[] 中的最大矩形
// 经典结论:n × m 网格中矩形总数 = n(n+1)/2 × m(m+1)/2停机坪为一个 3 × 3 的区域,且内部所有 9 个点的最大高度和最小高度之差不超过 H。
小 A 想请你计算出,在所有适合建造停机坪的区域中,区域内部 9 个点海拔之和最大是多少。
之后 M 行,第 i 行包含 N 个整数 a_{i1}, a_{i2}, …, a_{iN},代表坐标 (i, j) 的高度。
数据保证总存在一个适合建造停机坪的区域。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 5 5 3 5 5 5 5 5 5 1 5 1 5 5 5 5 5 5 5 2 5 2 5 3 5 5 5 2 | 40 |
对于所有测试点,保证 1 ≤q M, N ≤q 10^3,1 ≤q H, a_{ij} ≤q 10^5。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
给定 M 行 N 列的地形图,a(i,j) 表示坐标 (i,j) 的海拔。
停机坪是一个 3 × 3 的区域,要求内部 9 个点的最大高度与最小高度之差不超过 H。求所有适合建造的区域中,内部 9 个点海拔之和的最大值。
💡人话翻译:把每个 3 × 3 的小方块都检查一遍:先看它"最高点减最低点"是否 ≤ H(够平),够平的话再算 9 格之和,最后取最大的和。数据保证至少有一个合格区域,不用考虑无解。
🔍 关键词提取
滑动窗口二维前缀和最大值与最小值枚举
已知条件
项目说明
输入第一行 M、N、H;随后 M 行每行 N 个数
输出合格 3×3 区域中海拔和的最大值
数据范围M, N ≤ 1000
高度范围1 ≤ H, a ≤ 10⁵
窗口大小固定 3 × 3
需要解决的问题
有多少个候选区域?(M − 2) × (N − 2) 个,最多约 10⁶ 个
怎么快速求 9 格之和?用二维前缀和,O(1) 算出任意矩形和
最大最小值怎么办?窗口只有 9 格,直接枚举 9 个格即可(10⁶ × 9 = 9 × 10⁶,可接受)
📥 读入
M 行 N 列
高度可能到 10⁵
和可达 9 × 10⁵
用 long long 更稳
📊 二维前缀和
pre[i][j] 表示左上角矩形和
pre[i][j] = 上 + 左 − 左上 + 自己
矩形和 O(1) 查询
窗口和立刻可得
🔍 窗口检查
枚举左上角 (i, j)
求 9 格 max 与 min
max − min ≤ H 才合格
合格就更新答案
⚠️ 易错点
前缀和公式写错
max/min 初始化不当
i、j 的循环上界
H 是"之差"不是"最大值"
M = N = 5,所以有 (5−2) × (5−2) = 9 个候选窗口。
5 5 5 5 5

5 1 5 1 5

5 5 5 5 5

5 2 5 2 5

3 5 5 5 2
窗口左上角9 格之和最大值最小值极差极差 ≤ 3?
(1,1)41514❌
(1,2)37514❌
(1,3)41514❌
(2,1)38514❌
(2,2)31514❌
(2,3)38514❌
(3,1)40523✅
(3,2)39523✅
(3,3)39523✅
1
为什么前 6 个窗口都不合格?
它们内部都含有海拔 1(第 2 行的 1)
而同一窗口内还有海拔 5
极差 = 5 − 1 = 4 > H = 3 → 不合格
❌ 极差超标
2
后 3 个窗口为什么合格?
它们只覆盖第 3 ~ 5 行,避开了所有的 1
内部最低是 2(第 4 行的 2)
极差 = 5 − 2 = 3 ≤ 3 → 合格
✅ 三个都合格
3
取最大的和
左上角 (3,1) 的窗口和 = 40
另两个是 39
最大值为 40
✅ 输出 40
🔑注意"极差"的定义:题目要求的是最大值 − 最小值 ≤ H,不是"最大值 ≤ H",也不是"每个数都 ≤ H"。本样例中所有高度都达到 5 远超 H = 3,但因为窗口内部足够"平",所以依然合格。
🟢 二维前缀和(推荐) 推荐
预处理前缀和,窗口和 O(1) 查询;窗口内 9 格枚举求极值
时间 O(M × N)
窗口和 O(1)
总共约 9 × 10⁶ 次操作
M = N = 1000 也轻松
💡二维前缀和公式:sum = pre[i+3][j+3] - pre[i][j+3] - pre[i+3][j] + pre[i][j],注意右下角是"含"的,所以偏移是 +3 而不是 +2。
🟠 每个窗口重算 9 格之和
对每个窗口直接累加 9 个数
时间 O(M × N × 9)
约 9 × 10⁶ 次加法
本题其实也够快
但前缀和更显功力
⚠️实话实说:本题窗口固定 3×3,直接累加 9 格也只有 9 × 10⁶ 次运算,C++ 一秒能跑 10⁸ 次,暴力也能过。但前缀和是可迁移的通用技能,更值得掌握。
📈 性能对比
方案运算量(1000×1000)通用性
二维前缀和约 10⁶ + 9 × 10⁶强
直接累加约 9 × 10⁶弱(窗口变大就退化)
第一行输入 M、N、H,随后 M 行每行 N 个数。程序会检查所有 3×3 窗口并给出最大和。
输入数据5 5 3
5 5 5 5 5
5 1 5 1 5
5 5 5 5 5
5 2 5 2 5
3 5 5 5 2
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
long long a[1005][1005];
long long pre[1005][1005]; // 二维前缀和
int main() {
int M, N, H;
scanf("%d %d %d", &M, &N, &H);
for (int i = 1; i <= M; i++)
for (int j = 1; j <= N; j++) {
scanf("%lld", &a[i][j]);
// 前缀和递推:上 + 左 - 左上 + 自己
pre[i][j] = pre[i - 1][j] + pre[i][j - 1] - pre[i - 1][j - 1] + a[i][j];
}
long long ans = -1;
for (int i = 1; i + 2 <= M; i++) {
for (int j = 1; j + 2 <= N; j++) {
// 求窗口内 9 格的最大值、最小值
long long mx = -1, mn = 1000000;
for (int x = 0; x < 3; x++)
for (int y = 0; y < 3; y++) {
long long v = a[i + x][j + y];
if (v > mx) mx = v;
if (v < mn) mn = v;
}
if (mx - mn <= H) {
// 用前缀和 O(1) 求 9 格之和
long long sum = pre[i + 2][j + 2] - pre[i - 1][j + 2]
- pre[i + 2][j - 1] + pre[i - 1][j - 1];
if (sum > ans) ans = sum;
}
}
}
printf("%lld\n", ans);
return 0;
}
🔑前缀和下标从 1 开始最省心:把数组开成 a[1..M][1..N],这样 pre[i-1] 在 i = 1 时自然是 0,不用额外特判边界。这是网格题里非常常用的技巧。
📖 关键几行怎么看
代码作用为什么这样写
pre[i][j] = pre[i-1][j] + pre[i][j-1] - pre[i-1][j-1] + a[i][j]前缀和递推容斥原理:减去重复算的左上角
i + 2 <= M窗口上界窗口占 3 行,所以左上角最多到 M − 2
mx - mn <= H合格判定注意是极差,不是最大值本身
pre[i+2][j+2] - pre[i-1][j+2] - pre[i+2][j-1] + pre[i-1][j-1]O(1) 求窗口和四个角的前缀和做容斥
⚠️三个坑:① 前缀和公式漏掉 + pre[i-1][j-1];② 窗口上界写成 i <= M,数组越界;③ mn 初始化为 0(高度都是正数,会导致极差偏大)。
写完程序后,用这些数据自查一遍:
输入答案考察点
5 5 3
5 5 5 5 5 / 5 1 5 1 5 / 5 5 5 5 5 / 5 2 5 2 5 / 3 5 5 5 240题面样例
3 3 0
5 5 5 / 5 5 5 / 5 5 545H = 0 要求完全相等,全 5 的网格恰好满足
3 3 100
1 2 3 / 4 5 6 / 7 8 945H 足够大,唯一窗口就是答案
3 4 1
1 1 1 9 / 1 1 1 9 / 1 1 1 99含 9 的窗口极差为 8 超限,只能选全 1 的窗口
✅自查清单:① 极差算对了吗?② 前缀和四个角写对了吗?③ 窗口枚举范围对吗?
🚨 易错点清单
⚠️把"极差 ≤ H"理解成"最大值 ≤ H":题目要求的是窗口内最大值与最小值的差不超过 H。
⚠️前缀和公式写错:必须是"上 + 左 − 左上 + 自己",漏掉减左上会导致重复计算。
⚠️窗口上界越界:左上角行下标最大是 M − 3(0 基)或 M − 2(1 基)。
时间复杂度
O(M × N)
空间复杂度
O(M × N)
M, N 最大
1000
最坏运算
约 10⁷
时间怎么算的?
前缀和预处理 O(M × N)
枚举窗口:(M−2)(N−2) 个,每个检查 9 格
合计约 10⁶ + 9 × 10⁶ = 10⁷ 量级
空间都用在哪?
需要两个二维数组:原网格和前缀和,各约 10⁶ 个 long long。
✅ 约 1000 万次操作,C++ 瞬间完成,稳过。
// 二维前缀和模板
long long a[1005][1005], pre[1005][1005];
for (int i = 1; i <= M; i++)
for (int j = 1; j <= N; j++) {
scanf("%lld", &a[i][j]);
pre[i][j] = pre[i-1][j] + pre[i][j-1] - pre[i-1][j-1] + a[i][j];
}
// 查询以 (r1,c1) 为左上、(r2,c2) 为右下的矩形和
long long rectSum(int r1, int c1, int r2, int c2) {
return pre[r2][c2] - pre[r1-1][c2] - pre[r2][c1-1] + pre[r1-1][c1-1];
}
// 若窗口固定且很小,也可以用"行前缀 + 列累加"的滑动技巧
// 但要处理窗口内极值,本题直接枚举 9 格最简单
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
二维前缀和O(1) 查询任意矩形和矩阵求和、子矩阵统计、图像处理
固定窗口枚举左上角双层循环卷积、滑窗、局部统计
极差判定max − min ≤ H稳定性判断、质量控制
🌟思考题:如果题目把窗口从 3 × 3 改成 k × k(k 最多 1000),直接枚举 9 格就变成 k² 次,总复杂度 O(M N k²) 会超时。该怎么优化?(提示:用二维滑动窗口 + 单调队列求窗口极值,可以把每行的 k 长区间极值先算出来,再把列方向做一次,整体优化到 O(M × N)。)
5 5 5 5 5 5 1 5 1 5 5 5 5 5 5 5 2 5 2 5 3 5 5 5 2
#include <bits/stdc++.h>

using namespace std;


long long a[1005][1005];

long long pre[1005][1005];      // 二维前缀和


int main() {

    int M, N, H;

    scanf("%d %d %d", &M, &N, &H);


    for (int i = 1; i <= M; i++)

        for (int j = 1; j <= N; j++) {

            scanf("%lld", &a[i][j]);

            // 前缀和递推:上 + 左 - 左上 + 自己

            pre[i][j] = pre[i - 1][j] + pre[i][j - 1] - pre[i - 1][j - 1] + a[i][j];

        }


    long long ans = -1;

    for (int i = 1; i + 2 <= M; i++) {

        for (int j = 1; j + 2 <= N; j++) {

            // 求窗口内 9 格的最大值、最小值

            long long mx = -1, mn = 1000000;

            for (int x = 0; x < 3; x++)

                for (int y = 0; y < 3; y++) {

                    long long v = a[i + x][j + y];

                    if (v > mx) mx = v;

                    if (v < mn) mn = v;

                }


            if (mx - mn <= H) {

                // 用前缀和 O(1) 求 9 格之和

                long long sum = pre[i + 2][j + 2] - pre[i - 1][j + 2]

                              - pre[i + 2][j - 1] + pre[i - 1][j - 1];

                if (sum > ans) ans = sum;

            }

        }

    }


    printf("%lld\n", ans);

    return 0;

}// 二维前缀和模板
long long a[1005][1005], pre[1005][1005];
for (int i = 1; i <= M; i++)
for (int j = 1; j <= N; j++) {
scanf("%lld", &a[i][j]);
pre[i][j] = pre[i-1][j] + pre[i][j-1] - pre[i-1][j-1] + a[i][j];
}
// 查询以 (r1,c1) 为左上、(r2,c2) 为右下的矩形和
long long rectSum(int r1, int c1, int r2, int c2) {
return pre[r2][c2] - pre[r1-1][c2] - pre[r2][c1-1] + pre[r1-1][c1-1];
}
// 若窗口固定且很小,也可以用"行前缀 + 列累加"的滑动技巧
// 但要处理窗口内极值,本题直接枚举 9 格最简单如果一个单元格的海拔不高于其所有相邻单元格(相邻包括上、下、左、右、左上、右上、左下、右下,最多 8 个方向)的海拔,则称该单元格为山谷。
请你数一数该片山地中有多少山谷。
之后 N 行,每行包含 M 个整数 h_{i,1}, h_{i,2}, …, h_{i,M},表示海拔。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 3 5 7 6 6 7 9 6 5 6 7 6 6 5 7 8 9 | 3 |
样例 1 如图所示,绿色单元格代表山谷:
:::align{center}

:::
数据范围
保证 1 ≤q N, M ≤q 100,1 ≤q h_{i,j} ≤q 10^5。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
给定 N 行 M 列的网格,第 i 行 j 列的海拔为 h(i,j)。
如果一个单元格的海拔不高于其所有相邻单元格的海拔,则称该单元格为山谷。相邻包括上、下、左、右、左上、右上、左下、右下共最多 8 个方向。
请统计山谷的数量。
💡人话翻译:对每个格子,把它周围 8 个邻居都看一遍,如果没有任何邻居比它更低(允许相等),它就是山谷。注意边界格子只有 5 个或 3 个邻居,不能把网格外的位置当作 0 或无限大。
🔍 关键词提取
8 邻域方向数组边界处理比较所有邻居
已知条件
项目说明
输入第一行 N、M;随后 N 行每行 M 个海拔
输出山谷的数量
数据范围1 ≤ N, M ≤ 100
海拔范围1 ≤ h ≤ 10⁵
判定条件该格 ≤ 所有相邻格(相等也算)
需要解决的问题
怎么枚举 8 个方向?用两个方向数组 dx[8]、dy[8],配合循环
边界怎么处理?越界的邻居要跳过,不能比较
"不高于"是什么意思?是 ≤ 而不是 <,相等也满足条件
📥 读入
N 行 M 列
二维数组 h[][]
N,M ≤ 100
注意下标从 0 或 1 开始
🧭 8 方向
dx = {-1,-1,-1,0,0,1,1,1}
dy = {-1,0,1,-1,1,-1,0,1}
配合循环枚举
边界要跳过
✅ 判定
对每个邻居比较
若存在更低 → 不是山谷
全部 ≥ 它 → 是山谷
相等也算通过
⚠️ 易错点
把"不高于"写成"低于"
越界没跳过
只考虑 4 邻域
数组开太小
网格如下,我们逐个格子检查它的 8 个邻居。
7 6 6 7 9

6 5 6 7 6

6 5 7 8 9
位置海拔相邻格中的最小值是否 ≤ 最小值
(1,1)75❌ 7 > 5
(1,2)65❌
(1,3)65❌
(1,4)76❌
(1,5)96❌
(2,1)65❌
(2,2)55✅ 5 ≤ 5
(2,3)65❌
(2,4)76❌
(2,5)67✅ 6 ≤ 7
(3,1)65❌
(3,2)55✅ 5 ≤ 5
(3,3)75❌
(3,4)86❌
(3,5)96❌
🔑注意 (2,2) 这个格子:它海拔 5,周围有另一个 5(在 (3,2)),因为题目要求"不高于",所以相等也满足条件。如果写成严格小于,答案就会少算。
另外注意 (2,5):它海拔 6,邻居里最小值是 7,6 ≤ 7 成立,所以它是山谷。
🧮 边界格子怎么处理
四个角的格子只有 3 个邻居,边上的格子有 5 个。处理方法是越界就跳过,而不是把网格外当成 0。
位置类型邻居个数处理方式
内部格子8全部比较
边上(非角)5越界的 3 个方向跳过
四个角3越界的 5 个方向跳过
// 越界判断:只处理网格内的邻居

int nx = i + dx[d], ny = j + dy[d];

if (nx < 0 || nx >= N || ny < 0 || ny >= M) continue;
⚠️如果把网格外当成海拔 0,那么所有边上的格子都会"高于"这些虚拟的 0,于是永远不可能是山谷——正确答案会大幅偏少。这是本题最常见的错误。
🟢 方向数组 + 循环(推荐) 推荐
用 dx/dy 两个数组配合循环枚举 8 个邻居
时间 O(N × M × 8)
代码 8 行搞定邻居遍历
边界判断只需写一次
扩展成 4 邻域很方便
💡方向数组的写法:dx[8] = {-1,-1,-1,0,0,1,1,1}、dy[8] = {-1,0,1,-1,1,-1,0,1},两个数组同下标配成一组偏移。
🟠 手写 8 个判断
写 8 个 if 分别检查上、下、左、右、四个斜角
代码冗长
每个方向都要重复写边界判断
容易漏掉某个方向
不便于修改
⚠️注意:手写 8 个方向时,每个都要写 i-1 >= 0 && j-1 >= 0 这样的边界判断,一共要写 8 次,出错概率明显更高。
📈 性能对比
方案代码量漏方向的概率
方向数组约 8 行低
手写 8 个 if约 30 行高
第一行输入 N 和 M,随后 N 行每行 M 个数。程序会标出所有山谷。
输入数据3 5
7 6 6 7 9
6 5 6 7 6
6 5 7 8 9
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int h[105][105];
// 8 个方向的偏移量:上、下、左、右、四个斜角
int dx[8] = {-1, -1, -1, 0, 0, 1, 1, 1};
int dy[8] = {-1, 0, 1, -1, 1, -1, 0, 1};
int main() {
int N, M;
scanf("%d %d", &N, &M);
for (int i = 0; i < N; i++)
for (int j = 0; j < M; j++)
scanf("%d", &h[i][j]);
int ans = 0;
for (int i = 0; i < N; i++) {
for (int j = 0; j < M; j++) {
bool ok = true;
for (int d = 0; d < 8; d++) {
int nx = i + dx[d], ny = j + dy[d];
if (nx < 0 || nx >= N || ny < 0 || ny >= M) continue; // 越界跳过
if (h[nx][ny] < h[i][j]) { ok = false; break; } // 有更低的就不是山谷
}
if (ok) ans++;
}
}
printf("%d\n", ans);
return 0;
}
🔑方向数组怎么记?把 8 个方向按"从上到下、从左到右"排列:第一行是 (-1,-1)、(-1,0)、(-1,1),中间是 (0,-1)、(0,1),最后是 (1,-1)、(1,0)、(1,1)。这样一眼就能看出覆盖了全部 8 个方向,不会漏也不会重。
📖 关键几行怎么看
代码作用为什么这样写
dx[8]、dy[8]方向偏移同下标配成一组,循环一次得一个邻居
if (nx < 0 || nx >= N ...) continue;越界判断越界就跳过,绝不能把界外当成 0
h[nx][ny] < h[i][j]判定条件只要有一个邻居更低,就不是山谷(注意是严格小于)
if (ok) ans++;计数所有邻居都不更低才算山谷
⚠️三个坑:① 把"不高于"写成"低于",导致相等的格子被漏掉;② 越界没跳过(或把界外当 0),导致边界格子全部被误判;③ 只考虑了 4 邻域(上下左右),漏掉四个斜角方向。
写完程序后,用这些数据自查一遍:
输入答案考察点
3 5
7 6 6 7 9 / 6 5 6 7 6 / 6 5 7 8 93题面样例
1 1
51单格没有邻居,条件自然成立,算山谷
2 2
1 1 / 1 14全部相等,每格都是山谷
3 3
9 9 9 / 9 1 9 / 9 9 91只有中心的 1 是山谷
1 3
5 3 51单行时左右两个邻居,3 是山谷
✅自查清单:① 8 个方向都考虑了吗?② 越界跳过了吗?③ 相等的情况算作山谷吗?
🚨 易错点清单
⚠️把界外当成海拔 0:边上的格子会"高于"这些 0,永远不可能是山谷,答案偏少。
⚠️"不高于"写成"低于":题目允许相等,所以判定条件应是 邻居 < 自己 才淘汰,即自己 ≤ 所有邻居。
⚠️只考虑 4 邻域:题目明确说包括 8 个方向,斜角方向也必须比较。
时间复杂度
O(N × M × 8)
空间复杂度
O(N × M)
N, M 最大
100
最坏运算
约 8 × 10⁴
时间怎么算的?
每个格子检查 8 个邻居
总共 N × M × 8 次比较
N = M = 100 时约 8 万次
空间都用在哪?
需要存整个网格,100 × 100 = 10⁴ 个整数。
✅ 8 万次比较,瞬间完成;这题的关键是方向数组和边界处理。
// 4 邻域与 8 邻域的方向数组
int dx4[4] = {-1, 1, 0, 0};
int dy4[4] = { 0, 0,-1, 1};
int dx8[8] = {-1,-1,-1, 0, 0, 1, 1, 1};
int dy8[8] = {-1, 0, 1,-1, 1,-1, 0, 1};
// 通用邻居遍历模板
for (int d = 0; d < 8; d++) {
int nx = i + dx8[d], ny = j + dy8[d];
if (nx < 0 || nx >= N || ny < 0 || ny >= M) continue;
// 处理 (nx, ny)
}
// 用方向数组模拟"走迷宫"时也完全一样
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
方向数组用两个数组表示偏移网格搜索、迷宫、扫雷、BFS/DFS
越界跳过先判断再访问所有二维网格题目的必备写法
"不高于"语义相等也满足所有含"至少/至多/不超过"的判定
🌟思考题:如果题目改成"海拔不高于所有相邻格且严格低于至少一个相邻格"(排除掉"平坦区域"),判定条件要加什么?(提示:再加一个标记"是否出现过严格更低或更高"——实际上这类定义在真实的地理题目(如山脊/山谷判定)里很常见。)
7 6 6 7 9 6 5 6 7 6 6 5 7 8 9
// 越界判断:只处理网格内的邻居 int nx = i + dx[d], ny = j + dy[d]; if (nx < 0 || nx >= N || ny < 0 || ny >= M) continue;
#include <bits/stdc++.h>

using namespace std;


int h[105][105];

// 8 个方向的偏移量:上、下、左、右、四个斜角

int dx[8] = {-1, -1, -1,  0, 0,  1, 1, 1};

int dy[8] = {-1,  0,  1, -1, 1, -1, 0, 1};


int main() {

    int N, M;

    scanf("%d %d", &N, &M);

    for (int i = 0; i < N; i++)

        for (int j = 0; j < M; j++)

            scanf("%d", &h[i][j]);


    int ans = 0;

    for (int i = 0; i < N; i++) {

        for (int j = 0; j < M; j++) {

            bool ok = true;

            for (int d = 0; d < 8; d++) {

                int nx = i + dx[d], ny = j + dy[d];

                if (nx < 0 || nx >= N || ny < 0 || ny >= M) continue;  // 越界跳过

                if (h[nx][ny] < h[i][j]) { ok = false; break; }        // 有更低的就不是山谷

            }

            if (ok) ans++;

        }

    }


    printf("%d\n", ans);

    return 0;

}// 4 邻域与 8 邻域的方向数组
int dx4[4] = {-1, 1, 0, 0};
int dy4[4] = { 0, 0,-1, 1};
int dx8[8] = {-1,-1,-1, 0, 0, 1, 1, 1};
int dy8[8] = {-1, 0, 1,-1, 1,-1, 0, 1};
// 通用邻居遍历模板
for (int d = 0; d < 8; d++) {
int nx = i + dx8[d], ny = j + dy8[d];
if (nx < 0 || nx >= N || ny < 0 || ny >= M) continue;
// 处理 (nx, ny)
}
// 用方向数组模拟"走迷宫"时也完全一样有三个可以放圆盘柱子,编号为 A、B 和 C。
开始时柱子 A 上套着 n 个圆盘,它们从上到下按照从小到大的顺序排列。
我们的任务是要把这 n 个圆盘移到柱子 C 上,并保持它们的原有顺序不变。
在移动圆盘的过程中,需要遵守以下规则:
1. 圆盘只能从一根柱子顶部拿出,从另一根柱子顶部放入。
2. 每次只能移动一个圆盘。
3. 小圆盘必须时刻位于大圆盘之上。
小杨在学习了汉诺塔问题后,决定添加一个新规则:
4. 每一次移动,圆盘只能从 A 移动到 B,从 B 移动到 C,或者从 C 移动到 A;其它移动是不允许的。
在新规则下,给定圆盘数量 n,试问最少移动步数是多少?
| # | 输入 | 输出 |
|---|---|---|
| 1 | 2 | 7 |
| 2 | 3 | 21 |
以下步骤是最佳的(编号为 1 的是小盘,为 2 的是大盘):
1. 将 1 从 A 移动到 B;
2. 将 1 从 B 移动到 C;
3. 将 2 从 A 移动到 B;
4. 将 1 从 C 移动到 A;
5. 将 2 从 B 移动到 C;
6. 将 1 从 A 移动到 B;
7. 将 1 从 B 移动到 C。
可以证明没有更少步骤可以完成这个任务。
数据范围
对于所有数据,n ≤ 20。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
经典汉诺塔中,n 个圆盘从小到大叠在 A 柱上,目标是把它们移到 C 柱且保持顺序,规则是每次只能移动一个圆盘、大盘不能压在小盘上。
新规则:圆盘只能从 A 移到 B、从 B 移到 C、或从 C 移到 A,其他方向的移动都不允许(即只能"顺时针"移动)。
给定 n,求最少移动步数。
样例:n = 2 → 7;n = 3 → 21。
💡人话翻译:加了"只能顺时针移动"这个限制后,移动变得更麻烦——因为想从 A 直接到 C 是不允许的,必须绕道 A→B→C。所以我们需要同时维护两种成本:"移动 1 格"(如 A→B)和"移动 2 格"(如 A→C)。
🔍 关键词提取
递推状态定义循环移动限制long long
已知条件
项目说明
输入一个正整数 n
输出最少移动步数
数据范围n ≤ 20
允许的移动仅 A→B、B→C、C→A(顺时针)
样例n = 2 → 7;n = 3 → 21
需要解决的问题
为什么要两种状态?因为"把 n 个盘从 A 移到 B"(1 格)和"从 A 移到 C"(2 格)所需步数不同,而且互相依赖
递推关系是什么?记 F(n) = 移 2 格的步数、G(n) = 移 1 格的步数,则:
F(n) = 2F(n−1) + G(n−1) + 2
G(n) = 2F(n−1) + 1
初值呢?F(0) = 0、G(0) = 0;由此 F(1) = 2、G(1) = 1
🧠 状态定义
A→B→C 是顺时针环
F(n):移 2 格(如 A→C)
G(n):移 1 格(如 A→B)
两者互相依赖
📐 递推式
F(n) = 2F(n−1) + G(n−1) + 2
G(n) = 2F(n−1) + 1
初值 F(0) = G(0) = 0
一路推到 F(n)
🎯 关键步骤
最大盘必须 A→B 再 B→C
移动前要把上面 n−1 个盘挪开
挪开后还要挪回来
共两个 F 和 一个 G
⚠️ 易错点
只用一个状态(漏掉 G)
用 int 溢出
初值搞错
以为答案还是 2ⁿ − 1
先明确:F(n) 表示把 n 个盘顺时针移 1 格(如 A→B)的步数,G(n) 表示顺时针移 2 格(如 A→C)的步数。
nG(n):移 1 格F(n):移 2 格计算依据
000没有盘子,不用移动
112G(1) = A→B 一步;F(1) = A→B→C 两步
257G(2) = 2F(1)+1 = 5;F(2) = 2F(1)+G(1)+2 = 7
31521G(3) = 2F(2)+1 = 15;F(3) = 2F(2)+G(2)+2 = 21
1
F(n) 递推式怎么来的?
要把 n 个盘从 A 移到 C(顺时针 2 格)
① 先把上面 n−1 个盘从 A 移到 C(占位),需 F(n−1) 步
② 最大盘从 A 移到 B,1 步
③ 把 n−1 个盘从 C 移到 A(顺时针 1 格),需 G(n−1) 步
④ 最大盘从 B 移到 C,1 步
⑤ 再把 n−1 个盘从 A 移到 C,需 F(n−1) 步
合计 2F(n−1) + G(n−1) + 2
F(n) = 2F(n−1) + G(n−1) + 2
2
G(n) 递推式怎么来的?
要把 n 个盘从 A 移到 B(顺时针 1 格)
① 把 n−1 个盘从 A 移到 C(让位),需 F(n−1) 步
② 最大盘从 A 移到 B,1 步
③ 把 n−1 个盘从 C 移到 B(顺时针 1 格),需 F(n−1) 步
合计 2F(n−1) + 1
G(n) = 2F(n−1) + 1
📊 逐项验证样例
nG(n)F(n)是否与样例一致
112n = 1 → 2(题面未给,但可推理)
257✅ 与样例 7 一致
31521✅ 与样例 21 一致
43159(继续递推)
563163
🔑为什么不能只用"移 2 格"这一个状态?因为在递推过程中,"把 n−1 个盘从 C 移到 A"这一步是移 1 格(C→A),不是移 2 格。所以必须同时维护 F 和 G 两个状态——这是本题的核心难点,也是"递推题需要设计合适状态"的典型例子。
🟢 双向递推(推荐) 推荐
从 n = 0 递推到 n,同时维护 F、G
时间 O(n)
代码 10 行
n = 20 时几乎瞬间
状态定义清晰
💡实现结构:for (k = 1; k <= n; k++) { long long nf = 2f + g + 2, ng = 2f + 1; f = nf; g = ng; }——注意要先算出新值再赋值,否则会互相污染。
🟠 记忆化搜索
写递归函数,用数组记录已算过的 F(k)、G(k)
时间 O(n)
代码稍长(要写两个函数)
需要考虑递归深度
本质相同
⚠️两种都可以:递推更简洁,记忆化搜索的推导过程更贴近思维。对本题这种线性递推,递推写法既短又不会爆栈。
📈 性能对比
方案代码量适用性
双向递推约 10 行线性递推的最优写法
记忆化搜索约 25 行状态依赖复杂时更方便
输入圆盘数 n(1 ~ 20),程序会展示递推过程中每一步的 F、G 值。
输入 n
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int main() {
int n;
scanf("%d", &n);
// f = 顺时针移 2 格(如 A → C)的步数
// g = 顺时针移 1 格(如 A → B)的步数
long long f = 0, g = 0; // n = 0 时都不需要移动
for (int k = 1; k <= n; k++) {
long long nf = 2 * f + g + 2; // 先算新值
long long ng = 2 * f + 1;
f = nf; // 再一起赋值,避免互相污染
g = ng;
}
printf("%lld\n", f);
return 0;
}
🔑为什么要"先算新值再赋值"?因为 nf 和 ng 都用到了同一轮的 f、g。如果先写 f = nf; 再算 ng = 2 * f + 1;,f 已经被更新成新值了,ng 就会算错。递推中"同时更新多个状态"时务必小心这个陷阱。
📖 关键几行怎么看
代码作用为什么这样写
long long f = 0, g = 0初值0 个盘不需要移动
nf = 2 * f + g + 2F 递推两次 F(n−1) + 一次 G(n−1) + 两次单步
ng = 2 * f + 1G 递推两次 F(n−1) + 一次单步
f = nf; g = ng;同时更新必须先算出两个新值再赋值
⚠️三个坑:① 只用 F 一个状态(漏掉 G,无法处理"移 1 格"那一步);② 用 int 存(n = 20 时答案约 5.8 × 10⁸,虽然勉强在 int 内,但中间量 2*f 可能溢出,用 long long 更安全);③ 先更新 f 再算 ng,导致数值错误。
写完程序后,用这些数据自查一遍:
输入答案考察点
121 个盘:A→B→C,共 2 步
27题面样例 1
321题面样例 2
459继续递推 F(4) = 2×21+15+2 = 59
5163F(5) = 2×59+31+2 = 163
20运行验证最大值,考察 long long
✅自查清单:① 两个状态都维护了吗?② 先算新值再赋值吗?③ 用 long long 了吗?
🚨 易错点清单
⚠️只用一个状态:必须同时维护 F(移 2 格)和 G(移 1 格),因为递推过程中需要用 G。
⚠️先更新 f 再算 ng:会用到被覆盖的值,结果错误。
⚠️以为答案仍是 2ⁿ − 1:新规则下步数远大于经典汉诺塔。
时间复杂度
O(n)
空间复杂度
O(1)
n 最大
20
运算量
20 次
时间怎么算的?
从 1 递推到 n
每轮做常数次算术运算
总共 n ≤ 20 次循环
空间都用在哪?
只需要 f、g 两个变量(连数组都不需要)。
✅ 20 次循环,瞬间完成。这题的难点在于"设计正确的递推状态",而不是效率。
// 经典汉诺塔:H(n) = 2H(n-1) + 1 = 2^n - 1
long long hanoi(int n) { return (1LL << n) - 1; }
// 本题(顺时针限制):需要两个状态
// F(n) = 2F(n-1) + G(n-1) + 2 移 2 格
// G(n) = 2F(n-1) + 1 移 1 格
// 也可以合并成一个二阶递推
// 由 G(n) = 2F(n-1) + 1 得 G(n-1) = 2F(n-2) + 1
// 代入 F(n) = 2F(n-1) + 2F(n-2) + 3
// 验证:F(3) = 2×7 + 2×2 + 3 = 21 ✓
// 递推题的一般方法
// 1) 定义清楚状态(本题:移 k 格需要多少步)
// 2) 找出"最大元素"的处理方式
// 3) 写出状态之间的转移式
// 4) 确定初值,从初值递推到目标
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
状态设计移 1 格 / 移 2 格分别定义所有"操作受限"的递推题
同时更新多状态先算新值再统一赋值所有多变量递推
结构对比受限版 vs 经典版理解"限制条件如何改变复杂度"
🌟思考题:本题的 F(n) 增长约为 2.73ⁿ,而经典汉诺塔是 2ⁿ。为什么加了限制会变慢这么多?(提示:因为"移 2 格"需要借用"移 1 格"的操作,形成一个更复杂的依赖网络,相当于每一步都要多绕路。可以把这个结果和 (1+√3)ⁿ 对照——从递推式的特征方程 r² = 2r + 2 解出来正是 1 + √3 ≈ 2.732。)
#include <bits/stdc++.h>

using namespace std;


int main() {

    int n;

    scanf("%d", &n);


    // f = 顺时针移 2 格(如 A → C)的步数

    // g = 顺时针移 1 格(如 A → B)的步数

    long long f = 0, g = 0;      // n = 0 时都不需要移动


    for (int k = 1; k <= n; k++) {

        long long nf = 2 * f + g + 2;   // 先算新值

        long long ng = 2 * f + 1;

        f = nf;                          // 再一起赋值,避免互相污染

        g = ng;

    }


    printf("%lld\n", f);

    return 0;

}// 经典汉诺塔:H(n) = 2H(n-1) + 1 = 2^n - 1
long long hanoi(int n) { return (1LL << n) - 1; }
// 本题(顺时针限制):需要两个状态
// F(n) = 2F(n-1) + G(n-1) + 2 移 2 格
// G(n) = 2F(n-1) + 1 移 1 格
// 也可以合并成一个二阶递推
// 由 G(n) = 2F(n-1) + 1 得 G(n-1) = 2F(n-2) + 1
// 代入 F(n) = 2F(n-1) + 2F(n-2) + 3
// 验证:F(3) = 2×7 + 2×2 + 3 = 21 ✓
// 递推题的一般方法
// 1) 定义清楚状态(本题:移 k 格需要多少步)
// 2) 找出"最大元素"的处理方式
// 3) 写出状态之间的转移式
// 4) 确定初值,从初值递推到目标| # | 输入 | 输出 |
|---|---|---|
| 1 | 11 20 | 11 13 17 |
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
如果一个两位数本身是素数,且它的数字位置对换后仍是素数,则称为绝对素数,例如 13(13 和 31 都是素数)。
给定两个正整数 A、B(10 < A < B < 100),求出 ≥ A 且 ≤ B 的所有绝对素数,从小到大输出,每行一个。
💡人话翻译:只处理两位数。对区间内每个数,检查两件事:① 它自己是素数;② 十位和个位对换后的数也是素数。两个条件都满足就输出。
🔍 关键词提取
素数判定数位对换区间枚举试除法
已知条件
项目说明
输入一行两个正整数 A、B
输出每行一个绝对素数,从小到大
范围10 < A < B < 100
处理对象两位数(10 ~ 99)
判定条件本身是素数 且 对换后也是素数
需要解决的问题
怎么判素数?试除法:从 2 试到 √n,有因子就不是素数
怎么对换数位?设 n = 10a + b(a 是十位、b 是个位),对换后是 10b + a
有什么特殊情况?如果个位是 0(如 20),对换后是个位数 2——但 20 本身不是素数,所以会被第一关筛掉
📥 读入
A、B(10 < A < B < 100)
只需处理两位数
从 A 枚举到 B
从小到大输出
✅ 第一关
检查 n 是否为素数
试除 2 ~ √n
不是素数直接跳过
两位数只需试到 9
🔄 数位对换
a = n / 10(十位)
b = n % 10(个位)
swap = b × 10 + a
例如 13 → 31
✅ 第二关
检查 swap 是否为素数
也是素数 → 输出
否则跳过
两个条件缺一不可
逐个检查 11 到 20。
数字本身是素数?对换后对换后是素数?结论
11✅ 是11✅ 是输出 11
12❌ 偶数21—跳过
13✅ 是31✅ 是输出 13
14❌ 偶数41—跳过
15❌ 5 的倍数51—跳过
16❌ 偶数61—跳过
17✅ 是71✅ 是输出 17
18❌ 偶数81—跳过
19✅ 是91❌ 91 = 7 × 13不输出
20❌ 偶数02 = 2—跳过
1
19 为什么不是绝对素数?
19 本身是素数 ✅
对换后是 91
91 = 7 × 13,不是素数 ❌
所以 19 不满足条件
❌ 不输出 19
2
为什么 11 可以?
11 是素数 ✅
对换后还是 11,也是素数 ✅
"回文式"的两位素数(11)天然满足条件
✅ 输出 11
输出 11、13、17 ✓
🧮 一个易错点:对换后可能不是两位数
如果个位是 0,对换后得到的是一位数(前导 0)。比如 20 → 02 = 2。
数字十位 a个位 b对换后说明
20202个位是 0,对换后变成一位数
30303同上
131331正常两位
🔑本题不需要特判这种情况——因为个位是 0 的两位数(10、20、…、90)全部都是偶数或含因子 5,本身就不是素数,第一关就被筛掉了。但如果你想写得更严谨,可以加一句判断。
另外注意:个位是偶数或 5 的两位数都不是素数(除了它自己等于 2 或 5,但那是位数为 1 的情况),所以实际只需试除 3、7 两个因子即可判断两位数的素性——这是一个很好的优化思路。
🟢 试除法(推荐) 推荐
对每个数从 2 试到 √n 判素数
单个判定 O(√n)
两位数只需试到 9
代码 8 行
区间最多 90 个数
💡为什么够用:区间长度不到 90,每个数最多试除 3、7 等几个因子,总运算量不到几百次。
🟠 先筛出 1 ~ 99 的素数表
用埃氏筛把 99 以内的素数全标出来,之后 O(1) 查询
预处理 O(99 log log 99)
查询 O(1)
代码稍长
对本题是过度设计
⚠️什么时候值得:如果区间很大(比如要判 10⁶ 以内的数),筛法优势明显。本题只有两位数,试除法更简单直接。
📈 性能对比
方案本题运算量代码量
试除法几百次约 8 行
埃氏筛约 100 次 + 查询约 15 行
输入两个两位数 A 和 B(空格分隔),程序会逐个检查并列出绝对素数。
输入 A B
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
// 判断 x 是否为素数
bool isPrime(int x) {
if (x < 2) return false;
for (int i = 2; i * i <= x; i++) {
if (x % i == 0) return false;
}
return true;
}
int main() {
int A, B;
scanf("%d %d", &A, &B);
for (int n = A; n <= B; n++) {
if (!isPrime(n)) continue; // 第一关:本身必须是素数
// 数位对换:n = 10a + b -> 10b + a
int a = n / 10; // 十位
int b = n % 10; // 个位
int sw = b * 10 + a;
if (isPrime(sw)) printf("%d\n", n); // 第二关:对换后也是素数
}
return 0;
}
🔑为什么 isPrime 里循环条件写 i * i <= x?因为如果 x 有因子,必然存在一个因子 ≤ √x——所以只需试除到 √x 就够了。比试除到 x 快得多,而且 i * i <= x 比 i <= sqrt(x) 避免了浮点误差。
📖 关键几行怎么看
代码作用为什么这样写
if (x < 2) return false;特殊值0 和 1 都不是素数,必须单独处理
i * i <= x试除上界只需到 √x,且用整数比较避免浮点误差
a = n / 10; b = n % 10;取十位与个位整数除法截断,正好取十位
sw = b * 10 + a;对换把个位当十位、十位当个位
⚠️三个坑:① isPrime 没处理 x < 2 (虽然本题 n ≥ 11,但函数应写完整);② 试除时写成 i < x,效率低且没必要;③ 对换公式写成 a * 10 + b(那就是原数,没有对换)。
写完程序后,用这些数据自查一遍:
输入答案考察点
11 2011 / 13 / 17题面样例
11 1111单个数字
19 19(无输出)19 是素数,但 91 = 7 × 13 不是
10 3011 / 13 / 17 / 31 中的 13、17…需按区间逐个判定
90 99(无输出)该区间内没有满足条件的数
✅自查清单:① 两个条件都判了吗?② 对换公式对吗?③ isPrime 完整吗?
🚨 易错点清单
⚠️只判一个条件:必须两个条件都满足——本身是素数且对换后也是素数。例如 19 本身是素数但 91 不是。
⚠️对换公式写错:应该是 (n % 10) * 10 + n / 10。
⚠️isPrime 漏掉 < 2 的处理:写完整更稳妥。
时间复杂度
O((B−A) × √n)
空间复杂度
O(1)
区间长度
≤ 90
试除次数
每个数 ≤ 9 次
时间怎么算的?
枚举区间内每个数
每个数试除到 √n(两位数时 √n ≤ 9)
最多 90 × 9 ≈ 800 次运算
空间都用在哪?
只需几个整型变量。
✅ 不到 1000 次运算,瞬间完成。这题考的是素数判定和数位拆分的组合。
// 素数判定的标准写法
bool isPrime(int x) {
if (x < 2) return false;
if (x == 2) return true;
if (x % 2 == 0) return false; // 偶数快速筛掉
for (int i = 3; i * i <= x; i += 2) // 只试奇数因子
if (x % i == 0) return false;
return true;
}
// 两位数的数位拆分与合并
int tens = n / 10; // 十位
int ones = n % 10; // 个位
int swapped = ones * 10 + tens;
// 更通用的"反转数字"
int rev = 0, t = n;
while (t > 0) { rev = rev * 10 + t % 10; t /= 10; }
// 埃氏筛(区间很大时使用)
vector<bool> isP(100, true);
isP[0] = isP[1] = false;
for (int i = 2; i * i < 100; i++)
if (isP[i]) for (int j = i * i; j < 100; j += i) isP[j] = false;
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
素数判定试除到 √n所有素数相关题目
数位拆分/ 10 和 % 10数位统计、回文数、数字反转
双重条件枚举两个 if 依次筛所有"同时满足多个条件"的枚举题
🌟思考题:如果把范围扩展到所有整数(不限两位数),"绝对素数"还有哪些?(提示:三位数以上就不存在了——因为数字重排后如果能得到偶数或 5 的倍数,就不是素数。例如任何包含偶数位的三位数,把偶数放到末位就得到偶数(大于 2)→ 不是素数。所以"绝对素数"(任意重排都是素数)最多只到两位数,这是个很漂亮的结论。)
#include <bits/stdc++.h>

using namespace std;


// 判断 x 是否为素数

bool isPrime(int x) {

    if (x < 2) return false;

    for (int i = 2; i * i <= x; i++) {

        if (x % i == 0) return false;

    }

    return true;

}


int main() {

    int A, B;

    scanf("%d %d", &A, &B);


    for (int n = A; n <= B; n++) {

        if (!isPrime(n)) continue;              // 第一关:本身必须是素数


        // 数位对换:n = 10a + b -> 10b + a

        int a = n / 10;                          // 十位

        int b = n % 10;                          // 个位

        int sw = b * 10 + a;


        if (isPrime(sw)) printf("%d\n", n);      // 第二关:对换后也是素数

    }

    return 0;

}// 素数判定的标准写法
bool isPrime(int x) {
if (x < 2) return false;
if (x == 2) return true;
if (x % 2 == 0) return false; // 偶数快速筛掉
for (int i = 3; i * i <= x; i += 2) // 只试奇数因子
if (x % i == 0) return false;
return true;
}
// 两位数的数位拆分与合并
int tens = n / 10; // 十位
int ones = n % 10; // 个位
int swapped = ones * 10 + tens;
// 更通用的"反转数字"
int rev = 0, t = n;
while (t > 0) { rev = rev * 10 + t % 10; t /= 10; }
// 埃氏筛(区间很大时使用)
vector<bool> isP(100, true);
isP[0] = isP[1] = false;
for (int i = 2; i * i < 100; i++)
if (isP[i]) for (int j = i * i; j < 100; j += i) isP[j] = false;②编程打卡 · 点一下就能勾选
- 完成 B3869《进制转换》,跑通全部样例
- 完成 B4415《排兵布阵》,跑通全部样例
- 完成 B4451《建造》,跑通全部样例
- 完成 B4501《山之谷》,跑通全部样例
- 完成 B4579《新汉诺塔》,跑通全部样例
- 完成 B3939《绝对素数》,跑通全部样例
- 对比题解里的参考代码,找出自己写法的差异
模拟与按规则推进
①本日知识点 · 模拟与按规则推进
把题目规则一步步翻译成代码,用变量记住当前状态。
本组 4 道题全部来自 GESP 真题,按「模拟与按规则推进」归在一起练。题面取洛谷原题(含公式与样例),题解取美力程 GESP 题解库(思路 + 参考代码 + 复杂度)。
例如,16347:第 1 位为 7,乘以 7 结果为 49,大于 9,各位数相加为 13,仍大于 9,继续各位数相加,最后结果为 4;第 3 位为 3,变换结果为 3;第 5 位为 1,变换结果为 7。最后变化结果为 76344,对于结果 76344 其各位数之和为 24,是 8 的倍数。因此 16347 是幸运数。
从第 2 行开始的 N 行,每行一个正整数,为待判断的正整数。约定这些正整数小于 10^{12}。
T,否则输出 F。提示:不需要等到所有输入结束再依次输出,可以输入一个数就判断一个数并输出,再输入下一个数。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 2 16347 76344 | T F |
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
一个正整数,偶数位不变(个位为第 1 位,十位为第 2 位……),奇数位做如下变换:把该位数字乘以 7,若结果不大于 9 就作为变换结果;否则把结果的各位数字相加,若仍大于 9 就继续相加,直到不大于 9 为止。
变换结束后,把变换结果的各位数相加,若得到的和是 8 的倍数,则原数是幸运数。
例:16347 → 变换后 76344,各位和 = 7+6+3+4+4 = 24,是 8 的倍数 → 幸运数。
💡人话翻译:把数字的每一位分开看。偶数位(从右数第 2、4、6…位)原样保留;奇数位(第 1、3、5…位)要做一个"乘 7 并反复求数位和"的变换。注意"奇数位"是从右边(个位)开始数的第 1 位!
🔍 关键词提取
数位分解数位和数字根倍数判断
已知条件
项目说明
输入第一行 N;随后 N 行每行一个正整数
输出每行 T(是幸运数)或 F(不是)
数据范围1 ≤ N ≤ 20
数值范围正整数 < 10¹²(最多 13 位)
位置编号个位是第 1 位(即从右往左数)
需要解决的问题
怎么取出每一位?反复 % 10 取末位、/= 10 去掉末位,从个位开始依次得到第 1、2、3…位
变换怎么算?d × 7 后反复求数位和,直到 ≤ 9——这其实就是"数字根"
数字根能查表吗?能!因为奇数位只有 0 ~ 9 十种取值,可以预先算好映射表
📥 读入
N ≤ 20
数值 用 long long
可以边读边判断
✂️ 数位分解
从个位开始
digit = x % 10
x /= 10
第 1 位是个位
🔄 变换
奇数位:d × 7 后求数字根
偶数位:原样保留
把变换后的各位相加
判断是否 8 的倍数
⚠️ 易错点
奇偶位从右往左数
数字根算错(尤其 d = 0)
用 int 存大数
变换后是求和而非再判断
从个位开始数,位置编号为 1、2、3、4、5。
位置原始数字奇/偶变换规则变换结果
第 1 位(个位)7奇7 × 7 = 49 → 4+9 = 13 → 1+3 = 44
第 2 位(十位)4偶原样保留4
第 3 位(百位)3奇3 × 7 = 21 → 2+1 = 33
第 4 位(千位)6偶原样保留6
第 5 位(万位)1奇1 × 7 = 7 ≤ 9 → 77
1
拼出变换结果
第 5 位到第 1 位依次是 7、6、3、4、4
所以变换后的数是 76344
与题面一致 ✅
变换结果 76344
2
判断是否为 lucky
各位数字之和 = 7 + 6 + 3 + 4 + 4 = 24
24 ÷ 8 = 3,整除!
所以 16347 是幸运数
✅ 输出 T
16347 → T ✓
🧮 变换规则其实就是"数字根"
"乘 7 后反复求数位和直到一位数",正是数学上的数字根(digital root)。对 0 ~ 9 这 10 个数字,我们可以把结果预先算好。
奇数位数字 dd × 7反复求数位和的结果
000
177
2141+4 = 5
3212+1 = 3
4282+8 = 10 → 1+0 = 1
5353+5 = 8
6424+2 = 6
7494+9 = 13 → 1+3 = 4
8565+6 = 11 → 1+1 = 2
9636+3 = 9
🔑映射表:0→0、1→7、2→5、3→3、4→1、5→8、6→6、7→4、8→2、9→9。写成数组就是 t[10] = {0, 7, 5, 3, 1, 8, 6, 4, 2, 9},查表比循环求数位和更快也更清晰。注意 d = 0 时结果是 0,不要漏掉这一项。
🟢 预打映射表(推荐) 推荐
把 0~9 的变换结果写成数组,直接查表
时间 O(位数)
每位 O(1)
代码最短
不会算错
💡实现:int t[10] = {0,7,5,3,1,8,6,4,2,9};if (pos % 2 == 1) sum += t[d]; else sum += d;——两行就完成了整道题的核心逻辑。
🟠 循环求数位和
每次对 d×7 反复做"取末位相加、除以 10"
功能等价
代码多 6 ~ 8 行
需要小心终止条件
没有本质区别
⚠️都能过:本题只有 13 位数字,循环求数位和也只多几次运算。但打表写法把"变换规则"显式记录下来了,更便于核对。
📈 性能对比
方案代码量出错概率
预打映射表约 12 行低
循环求数位和约 20 行中
每行输入一个正整数,程序会逐位展示变换过程并判断是否为幸运数。
输入正整数(每行一个)16347
76344
8
1
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
// 奇数位数字 d 乘 7 后反复求数位和的结果(数字根)
// 0->0, 1->7, 2->5, 3->3, 4->1, 5->8, 6->6, 7->4, 8->2, 9->9
int tbl[10] = {0, 7, 5, 3, 1, 8, 6, 4, 2, 9};
int main() {
int N;
scanf("%d", &N);
while (N--) {
long long x;
scanf("%lld", &x);
if (x == 0) { printf("F\n"); continue; }
int total = 0;
int pos = 1; // 位置编号:个位是第 1 位
while (x > 0) {
int d = x % 10; // 取当前最低位
x /= 10;
if (pos % 2 == 1) total += tbl[d]; // 奇数位:变换
else total += d; // 偶数位:不变
pos++;
}
printf("%s\n", (total % 8 == 0) ? "T" : "F");
}
return 0;
}
🔑为什么用 % 10 取位就天然从个位开始了?因为 x % 10 得到的正是最低位(个位),接着 x /= 10 去掉个位,下一轮的 x % 10 就是十位……所以 pos 从 1 开始计数,正好对应题目"个位是第 1 位"的定义。用 % 10 取位比转成字符串更省事。
📖 关键几行怎么看
代码作用为什么这样写
tbl[10] = {0,7,5,3,1,8,6,4,2,9}变换表把"乘 7 再求数字根"的结果预存
int d = x % 10; x /= 10;取最低位从个位开始依次取出各位
if (pos % 2 == 1)判断奇数位pos 从 1 开始,所以奇数位对应 1、3、5…
total % 8 == 0倍数判断% 8 为 0 即 8 的倍数
⚠️三个坑:① 奇偶位判反(题目是从个位开始数第 1 位)——如果从左往右数就错了;② tbl[0] 写成别的值(正确的数字根是 0);③ 用 int 读入(数值可达 10¹²,虽然 int 上限约 2.1 × 10⁹,但为稳妥用 long long)。
写完程序后,用这些数据自查一遍:
输入答案考察点
16347T题面样例(24 是 8 的倍数)
76344F题面样例
8F只有第 1 位(奇数位):8×7 = 56 → 5+6 = 11 → 1+1 = 2;2 不是 8 的倍数
1按规则计算一位数只涉及第 1 位(奇数位)
1000000000000按规则计算最大规模,考察 long long
✅自查清单:① 位置从个位开始数吗?② 变换表对吗?③ 用的是 long long 吗?
🚨 易错点清单
⚠️奇偶位判反:位置编号必须从个位开始数,个位是第 1 位(奇数位)。
⚠️数字根表漏项:d = 0 时乘 7 还是 0,数字根是 0。
⚠️用 int 读入:数值可达 10¹²,必须用 long long。
时间复杂度
O(N × 位数)
空间复杂度
O(1)
位数
≤ 13
N 最大
20
时间怎么算的?
每个数逐位处理一次
最多 13 位
N ≤ 20,总共不到 300 次操作
空间都用在哪?
一个长度为 10 的查表数组。
✅ 运算量极小,瞬间完成。难点在"位置从个位开始数"和"数字根"这两处细节。
// 数位分解的两种写法
// 写法一:取模除法(从低位开始)
while (x > 0) { int d = x % 10; x /= 10; /* 处理 d */ }
// 写法二:转字符串(从高位开始)
string s = to_string(x);
for (char c : s) { int d = c - '0'; /* 处理 d */ }
// 数字根的计算(通用做法)
int digitalRoot(int n) {
if (n == 0) return 0;
return (n - 1) % 9 + 1; // 数学公式
}
// 或者反复求数位和
int dr(int n) { while (n >= 10) { int s = 0; while (n) { s += n % 10; n /= 10; } n = s; } return n; }
// 判断是否为 8 的倍数
if (total % 8 == 0) { /* 是 */ }
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
数位分解% 10 + /= 10数位统计、数字拆分、回文数
数字根反复求数位和数论、模 9 性质、本题的变换
预打映射表把 0~9 的结果存数组变换规则有限的题目
🌟思考题:如果题目把"奇数位乘 7"改成"奇数位乘 k",代码要改哪里?(提示:只需重新生成变换表——对 d = 0 ~ 9 分别算 digitalRoot(d × k) 填入表即可,主循环完全不用动。这就是"打表"的好处:规则变了只改数据,不改逻辑。)
#include <bits/stdc++.h>

using namespace std;


// 奇数位数字 d 乘 7 后反复求数位和的结果(数字根)

// 0->0, 1->7, 2->5, 3->3, 4->1, 5->8, 6->6, 7->4, 8->2, 9->9

int tbl[10] = {0, 7, 5, 3, 1, 8, 6, 4, 2, 9};


int main() {

    int N;

    scanf("%d", &N);


    while (N--) {

        long long x;

        scanf("%lld", &x);


        if (x == 0) { printf("F\n"); continue; }


        int total = 0;

        int pos = 1;                      // 位置编号:个位是第 1 位

        while (x > 0) {

            int d = x % 10;               // 取当前最低位

            x /= 10;

            if (pos % 2 == 1) total += tbl[d];   // 奇数位:变换

            else              total += d;        // 偶数位:不变

            pos++;

        }


        printf("%s\n", (total % 8 == 0) ? "T" : "F");

    }

    return 0;

}// 数位分解的两种写法
// 写法一:取模除法(从低位开始)
while (x > 0) { int d = x % 10; x /= 10; /* 处理 d */ }
// 写法二:转字符串(从高位开始)
string s = to_string(x);
for (char c : s) { int d = c - '0'; /* 处理 d */ }
// 数字根的计算(通用做法)
int digitalRoot(int n) {
if (n == 0) return 0;
return (n - 1) % 9 + 1; // 数学公式
}
// 或者反复求数位和
int dr(int n) { while (n >= 10) { int s = 0; while (n) { s += n % 10; n /= 10; } n = s; } return n; }
// 判断是否为 8 的倍数
if (total % 8 == 0) { /* 是 */ }小杨想知道网格图中是否存在一个满足如下条件的子矩形:
- 子矩形由 4 行 4 列组成;
- 子矩形的第 1 行和第 4 行只包含白色格子;
- 对于子矩形的第 2 行和第 3 行,只有第 1 个和第 4 个格子是白色的,其余格子都是黑色的;
请你编写程序帮助小杨判断。
接下来是 t 组测试用例。对于每组测试用例,一共 n+1 行。
第一行包含两个正整数 n,m,含义如题面所示。
之后 n 行,每行一个长度为 m 的 01 串,代表网格图第 i 行格子的颜色,如果为 0,则对应格子为白色,否则为黑色。
Yes,否则输出 No。| # | 输入 | 输出 |
|---|---|---|
| 1 | 3 1 4 0110 5 5 00000 01100 01100 00001 01100 5 5 00000 01100 01110 00001 01100 | No Yes No |
0000
0110
0110
0000
数据规模与约定
对全部的测试数据,保证 1 ≤q t≤q 10,1 ≤q n,m ≤q 100。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
网格中每格是黑或白。请判断是否存在一个 4 行 4 列的子矩形,满足:
第 1 行和第 4 行只包含白色格子
第 2 行和第 3 行中,只有第 1 个和第 4 个格子是白色,其余都是黑色
输入中 0 表示白色、1 表示黑色。存在输出 Yes,否则输出 No。
💡人话翻译:要找一个长这样的 4 × 4 花纹:
0 0 0 0

0 1 1 0

0 1 1 0

0 0 0 0
做法很直接:枚举所有可能的左上角位置,然后逐格比对这 16 个格子。
🔍 关键词提取
模板匹配4×4 窗口字符比对多组测试
已知条件
项目说明
输入第一行 t;每组先一行 n、m,再 n 行 01 串
输出每组一行 Yes 或 No
数据范围t ≤ 10,1 ≤ n, m ≤ 100
编码0 = 白色,1 = 黑色
窗口尺寸固定 4 行 4 列
需要解决的问题
要枚举多少个位置?(n−3) × (m−3) 个左上角,最多约 10⁴ 个
怎么比对?把 4 × 4 的目标图案写死成常量,逐格比较
结果怎么给?只要找到一个就输出 Yes,可以立即 break 跳出
📥 读入
t 组测试
每组 n、m
n 行 01 串
注意多组要重置状态
📐 目标模板
第 1 行 0000
第 2 行 0110
第 3 行 0110
第 4 行 0000
🔍 枚举比对
左上角 (i, j) 从 0 到 n−4、m−4
逐格与模板比较
全部相同 → Yes
找到即可 break
⚠️ 易错点
循环上界写成 i < n−3(漏一个)
模板写错一位
多组数据忘记重置 found
n < 4 或 m < 4 时直接 No
样例答案依次是 No、Yes、No。
1
第 1 组:n = 1, m = 4
只有 1 行,而图案需要 4 行
根本没有 4 × 4 的子矩形
❌ No(尺寸不够)
2
第 2 组:5 × 5
网格中第 1~4 行、第 1~4 列恰好是:
0000(第 1 行)
0110(第 2 行)
0110(第 3 行)
0000(第 4 行)
与目标模板逐格一致
✅ Yes
3
第 3 组:5 × 5
网格为 00000 / 01100 / 01110 / 00001 / 01100
候选 1(第 1~4 行、第 1~4 列):
0000 / 0110 / 0111 / 0000
第 3 行是 0111,而模板要求 0110 ✗
候选 2(第 1~4 行、第 2~5 列):
0000 / 1100 / 1110 / 0001
第 2 行是 1100,而模板要求 0110 ✗
其余候选同样不匹配
❌ No
📐 目标模板(务必记牢)
行第 1 列第 2 列第 3 列第 4 列要求
第 1 行0000全白
第 2 行0110中间两格黑
第 3 行0110中间两格黑
第 4 行0000全白
🔑最稳妥的做法是把这个模板写成常量数组:string pat[4] = {"0000", "0110", "0110", "0000"};然后比对新窗口时直接用字符串逐行比较。比手写 16 个 if 条件可靠得多,也不容易写错某一位。
🧮 循环上界为什么要 − 4 + 1?
这是窗口枚举最容易出错的地方,我们把它讲清楚。
窗口尺寸左上角最大行下标循环写法
4 行n − 4i + 4 <= n 或 i <= n - 4
2 行n − 2i + 2 <= n
1 行n − 1i + 1 <= n(即 i < n)
1
直观理解
左上角在第 i 行时,窗口占 i、i+1、i+2、i+3 共 4 行
要求 i + 3 ≤ n − 1,即 i ≤ n − 4
所以写作 i + 4 <= n
2
常见错误
写成 i < n − 3,会让 i 最大取到 n − 4(看似对)
但写成 i < n − 4 就会漏掉最后一个位置
写成 i <= n 会越界访问
⚠️ 建议统一用 i + 4 <= n 的形式
💡推荐写法:for (int i = 0; i + 3 < n; i++)——因为窗口右下角行号是 i + 3,直接写 i + 3 < n 与访问形式对应,一眼就能看出不会越界。
🟢 模板数组逐格比对(推荐) 推荐
把 4 行图案写成字符串数组,逐行比较
时间 O(nm × 16)
代码 12 行
模板一目了然
改需求只需改模板
💡为什么推荐:代码里直接能看到目标长相,评审或自查时非常直观;也不容易发生"手写 16 个条件漏一个"的错误。
🟠 手写 16 个条件判断
直接写 if 判断每一格的颜色
代码冗长
容易写错某一位
可读性差
功能上等价
⚠️注意:如果题目给的花纹很复杂(比如 10 × 10),手写条件完全不可行,模板比对才是通用做法。
📈 性能对比
方案代码量出错概率
模板数组约 12 行低
手写条件约 30 行中高
第一行输入 t,随后每组先一行 n m,再 n 行 01 串。程序会搜索目标 4×4 花纹。
输入数据2
5 5
00000
01100
01100
00001
01100
3 4
0000
0110
0110
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
// 目标花纹(0 白 1 黑)
string pat[4] = {"0000", "0110", "0110", "0000"};
int main() {
int t;
scanf("%d", &t);
while (t--) {
int n, m;
scanf("%d %d", &n, &m);
vector<string> g(n);
for (int i = 0; i < n; i++) cin >> g[i];
bool found = false;
// 枚举 4×4 窗口的左上角
for (int i = 0; i + 3 < n && !found; i++) {
for (int j = 0; j + 3 < m && !found; j++) {
bool ok = true;
for (int r = 0; r < 4 && ok; r++) {
for (int c = 0; c < 4; c++) {
if (g[i + r][j + c] != pat[r][c]) { ok = false; break; }
}
}
if (ok) found = true;
}
}
printf("%s\n", found ? "Yes" : "No");
}
return 0;
}
🔑为什么把模板写成全局字符串数组?因为 g[i+r][j+c] != pat[r][c] 这种"行列对应"的比对非常直观,而且以后要改花纹(比如换成 5 × 5 图案)只需改 pat 的定义,循环结构完全不用动。
📖 关键几行怎么看
代码作用为什么这样写
i + 3 < n保证窗口不越界右下角行号是 i+3,与访问形式对应
for (r = 0; r < 4 && ok; r++)逐行比对加上 ok 条件可提前跳出
g[i+r][j+c] != pat[r][c]逐格比对统一用相对偏移,避免手写下标
found ? "Yes" : "No"输出三目运算符一行搞定
⚠️三个坑:① 循环上界写成 i < n - 4,漏掉最后一个候选位置;② 模板某一位写错(比如把第 2 行写成 1001);③ 多组测试时 found 没在每组开头重置。
写完程序后,用这些数据自查一遍:
输入答案考察点
1
1 4
0110No题面样例 1:行数不足 4
1
5 5
00000 / 01100 / 01100 / 00001 / 01100Yes题面样例 2
1
5 5
00000 / 01100 / 01110 / 00001 / 01100No题面样例 3
1
4 4
0000 / 0110 / 0110 / 0000Yes恰好是目标花纹
1
4 4
0110 / 0110 / 0110 / 0110No四行都是 0110,不满足
2
4 4
0000 / 0110 / 0110 / 0000
4 4
0110 / 0110 / 0110 / 0110Yes
No多组测试,考察状态重置
✅自查清单:① 循环上界对吗?② 模板四位都对吗?③ 每组都重置 found 了吗?
🚨 易错点清单
⚠️循环上界错:左上角行下标最大是 n − 4,写成 i <= n - 4 或 i + 4 <= n 才对。
⚠️模板写错一位:目标花纹的第 2、3 行是 0110,不是 1001 也不是 0111。
⚠️多组数据没重置 found:上一组找到过就会污染下一组的结果。
时间复杂度
O(t × n × m × 16)
空间复杂度
O(n × m)
n, m 最大
100
最坏运算
约 1.6 × 10⁶
时间怎么算的?
枚举窗口约 (n−3)(m−3) 个
每个比对 16 格
t = 10、n = m = 100 时约 1.6 × 10⁶ 次
空间都用在哪?
需要存每个测试用例的网格。
✅ 最多约 160 万次字符比较,瞬间完成。
// 固定尺寸窗口的通用枚举模板
int WH = 4, WW = 4; // 窗口高、宽
for (int i = 0; i + WH - 1 < n; i++) {
for (int j = 0; j + WW - 1 < m; j++) {
// 处理窗口 (i, j) 到 (i+WH-1, j+WW-1)
}
}
// 注意:i + WH - 1 < n 等价于 i + WH <= n 等价于 i <= n - WH
// 用 vector<string> 存网格,便于按字符访问
vector<string> g(n);
for (int i = 0; i < n; i++) cin >> g[i];
g[i][j] 就是第 i 行第 j 列的字符
// 模板匹配的通用写法
bool match(int i, int j, const vector<string> &pat) {
for (int r = 0; r < (int)pat.size(); r++)
for (int c = 0; c < (int)pat[0].size(); c++)
if (g[i+r][j+c] != pat[r][c]) return false;
return true;
}
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
固定窗口枚举上界写作 i + W − 1 < n所有模板匹配题
模板数组把图案写成常量图像识别、棋盘花纹、模式检测
多组测试重置每组开头重置状态变量所有含 t 组测试的题目
🌟思考题:如果题目把花纹改成"第 1 行全白、第 2 行中间两格黑、第 3 行可以任意",该怎么在模板比对里表达"任意"?(提示:用特殊字符 ? 表示通配,比对时遇到 pat[r][c] == '?' 就跳过。这是模式匹配中"通配符"的最朴素实现。)
0 0 0 0 0 1 1 0 0 1 1 0 0 0 0 0
#include <bits/stdc++.h>

using namespace std;


// 目标花纹(0 白 1 黑)

string pat[4] = {"0000", "0110", "0110", "0000"};


int main() {

    int t;

    scanf("%d", &t);

    while (t--) {

        int n, m;

        scanf("%d %d", &n, &m);


        vector<string> g(n);

        for (int i = 0; i < n; i++) cin >> g[i];


        bool found = false;


        // 枚举 4×4 窗口的左上角

        for (int i = 0; i + 3 < n && !found; i++) {

            for (int j = 0; j + 3 < m && !found; j++) {

                bool ok = true;

                for (int r = 0; r < 4 && ok; r++) {

                    for (int c = 0; c < 4; c++) {

                        if (g[i + r][j + c] != pat[r][c]) { ok = false; break; }

                    }

                }

                if (ok) found = true;

            }

        }


        printf("%s\n", found ? "Yes" : "No");

    }

    return 0;

}// 固定尺寸窗口的通用枚举模板
int WH = 4, WW = 4; // 窗口高、宽
for (int i = 0; i + WH - 1 < n; i++) {
for (int j = 0; j + WW - 1 < m; j++) {
// 处理窗口 (i, j) 到 (i+WH-1, j+WW-1)
}
}
// 注意:i + WH - 1 < n 等价于 i + WH <= n 等价于 i <= n - WH
// 用 vector<string> 存网格,便于按字符访问
vector<string> g(n);
for (int i = 0; i < n; i++) cin >> g[i];
g[i][j] 就是第 i 行第 j 列的字符
// 模板匹配的通用写法
bool match(int i, int j, const vector<string> &pat) {
for (int r = 0; r < (int)pat.size(); r++)
for (int c = 0; c < (int)pat[0].size(); c++)
if (g[i+r][j+c] != pat[r][c]) return false;
return true;
}小杨想要开垦这块荒地,但荒地中一些位置存在杂物,对于一块不存在杂物的荒地,该荒地可以开垦当且仅当其上下左右四个方向相邻的格子均不存在杂物。
小杨可以选择至多一个位置,清除该位置的杂物,移除杂物后该位置变为荒地。小杨想知道在清除至多一个位置的杂物的情况下,最多能够开垦多少块荒地。
之后 n 行,每行包含一个长度为 m 且仅包含字符 . 和 # 的字符串。如果为 .,代表该位置为荒地;如果为 #,代表该位置为杂物。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 3 5 ..... .#..# ..... | 11 |
移除第二行从左数第二块空地的杂物后:
.....
....#
.....
第一行从左数前 4 块荒地,第二行从左数前 3 块荒地,第三行从左数前 4 块荒地,均可开垦,4+3+4=11。
数据范围
对于全部数据,有 1≤q n,m≤q 1000。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
荒地是 n 行 m 列的网格,. 表示荒地、# 表示杂物。
一块无杂物的荒地可以开垦,当且仅当其上下左右四个方向相邻的格子均不存在杂物。
小杨可以选择至多一个位置清除杂物,清除后该位置变为荒地。求最多能开垦多少块荒地。
💡人话翻译:先数一遍现在能开垦多少块。然后考虑"挖掉哪个杂物最划算"——挖掉一个 # 后,只有它自己以及它上下左右 4 个邻居的开垦状态可能变化。所以我们只需对这 5 个格子重新判断,不用把整个网格重算一遍。
🔍 关键词提取
四邻判定局部影响范围预处理 - 增量计算网格
已知条件
项目说明
输入第一行 n、m;随后 n 行含 . 和 # 的字符串
输出清除至多一个杂物后,最多能开垦的块数
数据范围1 ≤ n, m ≤ 1000
开垦条件该格为 .,且四邻(上下左右)都无杂物
清除限制至多一个(也可以不清除)
需要解决的问题
初始能开垦多少?遍历一遍,对每个 . 检查四邻
挖掉一个 # 后谁会变?只有它自己和四个邻居——因为其他格子的邻域没有变化
要有序地避免重复统计吗?需要!被影响的 5 格里可能有格子原本就能开垦,只统计"由不能变能"的那些
📥 读入
n、m ≤ 1000
字符矩阵
10⁶ 个格子
用 char 数组存
🔢 预处理
定义 ok(i,j):该格可开垦
遍历全图求 baseline
O(nm)
同时把结果存进 bool 数组
🔄 枚举清除点
对每个 # 位置 p
临时把 p 变成 .
只重算 p 和它的 4 邻
增量 = 新可开垦 − 原有的
📤 取最优
ans = max(baseline, baseline + 各增量)
注意也允许不清除
复杂度 O(nm)
不要每题重算全图
.....

.#..#

.....
1
第 1 步:数清哪些格不能开垦
15 格中有 2 个杂物((2,2)、(2,5)),剩 13 个荒地候选
逐个检查四邻后,不能开垦的有 7 格:
(1,2)、(1,5)、(2,1)、(2,3)、(2,4)、(3,2)、(3,5)
其中 (1,2)、(2,1)、(2,3)、(3,2) 是被 (2,2) 挡住的
(1,5)、(2,4)、(3,5) 是被 (2,5) 挡住的
baseline = 13 − 7 = 6
2
第 2 步:试清除 (2,2)
受影响的 5 格:(2,2) 自己 + (1,2)、(2,1)、(2,3)、(3,2)
这 5 格原先都不能开垦
清除后 (2,2) 变成荒地,这 5 格的四邻都不再含杂物
于是 5 格全部变得可以开垦 → 增量 +5
6 + 5 = 11
3
第 3 步:试清除 (2,5)
受影响的格:(2,5) 自己 + (1,5)、(2,4)、(3,5)(右侧越界)
这 4 格原先都不能开垦,清除后全部可以 → 增量 +4
6 + 4 = 10
4
第 4 步:取最大值
清除 (2,2) 得 11 块;清除 (2,5) 得 10 块
不清除任何杂物得 6 块
三者取最大
✅ 输出 11
🔑这题最容易错的地方不是算法,而是"数错 baseline"。本样例中最容易被漏掉的是:(2,4) 虽然是 .,但它的邻居 (2,5) 是杂物,所以不能开垦;同理 (1,5)、(3,5) 也因 (2,5) 而不能开垦。光看出网格是 . 是不够的,必须逐格检查四邻。
🧮 增量算法的核心:为什么只需重算 5 格
这是本题的算法核心,务必理解。
1
一个格子的开垦状态取决于什么?
取决于"它自己是否是杂物"和"四邻是否有杂物"
也就是只与它自己和上下左右 4 格有关
影响范围 = 自己 + 上下左右
2
清除一个杂物会影响哪些格子?
设清除位置为 p
只有"其开垦状态的计算涉及 p"的格子才可能变化
满足条件的格子 = p 自己 + p 的上下左右 4 邻
共 5 格(边界处更少)
受影响的格子最多 5 个
3
所以算法是
对每个杂物位置 p:临时清除它
只重新判断这 5 格的开垦状态
增量 = (新可开垦数)−(原本可开垦数)
取所有 p 的最大增量,再与 baseline 取最大
总体 O(nm × 5),非常快
这比"每次重算整个网格"快了 n×m 倍
🟢 局部增量(推荐) 推荐
预处理 baseline,对每个杂物只重算 5 格
时间 O(n × m)
10⁶ 格 → 约 5 × 10⁶ 次
关键在于"影响范围只有 5 格"
代码稍长但可行
💡核心洞察:"一个格子的开垦状态只依赖它自己和四邻",所以清除一个杂物只会改变 5 个格子的状态。这是把 O(nm × nm) 降到 O(nm) 的关键。
🟠 对每个杂物重算全图
枚举杂物位置,每次都把整个网格的开垦数重算一遍
时间 O(n²m²)
n = m = 1000 时约 10¹² 次
必然超时
思路简单但不可行
⚠️注意:如果 n、m 很小(比如 ≤ 10),这种暴力写法完全没问题;但本题 n、m ≤ 1000,必须利用"影响范围有限"这一性质。
📈 性能对比
方案运算量(1000×1000)是否可行
局部增量约 5 × 10⁶✅ 可行
全图重算约 10¹²❌ 超时
第一行输入 n 和 m,随后 n 行由 . 和 # 组成的网格。程序会尝试清除每个杂物。
输入数据3 5
.....
.#..#
.....
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int n, m;
char g[1005][1005];
int dx[4] = {-1, 1, 0, 0};
int dy[4] = { 0, 0,-1, 1};
// 判断 (i, j) 是否可以开垦
bool canTill(int i, int j) {
if (i < 0 || i >= n || j < 0 || j >= m) return false;
if (g[i][j] != '.') return false;
for (int d = 0; d < 4; d++) {
int ni = i + dx[d], nj = j + dy[d];
if (ni < 0 || ni >= n || nj < 0 || nj >= m) continue;
if (g[ni][nj] != '.') return false; // 邻居有杂物
}
return true;
}
int main() {
scanf("%d %d", &n, &m);
for (int i = 0; i < n; i++) scanf("%s", g[i]);
// 1) 预处理:不清除任何杂物时的可开垦数
int base = 0;
for (int i = 0; i < n; i++)
for (int j = 0; j < m; j++)
if (canTill(i, j)) base++;
int ans = base; // 允许"不清除"
// 2) 枚举清除每个杂物,只重算它自己和四邻
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
if (g[i][j] != '#') continue;
// 记录受影响的 5 格原本的可开垦情况
int oldCnt = 0, newCnt = 0;
int pi[5], pj[5], cnt = 0;
pi[cnt] = i; pj[cnt] = j; cnt++;
for (int d = 0; d < 4; d++) {
int ni = i + dx[d], nj = j + dy[d];
if (ni < 0 || ni >= n || nj < 0 || nj >= m) continue;
pi[cnt] = ni; pj[cnt] = nj; cnt++;
}
for (int k = 0; k < cnt; k++) if (canTill(pi[k], pj[k])) oldCnt++;
// 清除杂物后重新计算这 5 格
g[i][j] = '.';
for (int k = 0; k < cnt; k++) if (canTill(pi[k], pj[k])) newCnt++;
g[i][j] = '#'; // 还原
if (base - oldCnt + newCnt > ans) ans = base - oldCnt + newCnt;
}
}
printf("%d\n", ans);
return 0;
}
🔑为什么用 base − oldCnt + newCnt?因为这 5 格里原本可能已经有一些是可开垦的,直接写 base + (newCnt − oldCnt) 更清楚。关键是要先统计"原本可开垦数",再统计"清除后可开垦数",两者之差才是净增量。
📖 关键几行怎么看
代码作用为什么这样写
canTill(i, j)判断单格可开垦把判定封装成函数,便于反复调用
int ans = base;允许不清除题目说"至多一个",所以不清除也是合法选择
pi[cnt] = i; pj[cnt] = j; cnt++;收集受影响格把 p 自己和四邻共 5 格(可能更少)存起来
g[i][j] = '#';还原尝试完必须恢复,否则影响后续枚举
⚠️三个坑:① 忘记"允许不清除"(ans 应初始化为 base);② 清除后忘记还原,导致后续枚举基于错误的网格;③ 忽略". 不代表一定能开垦"——必须检查四邻,本题最容易数错的就是这一点。
写完程序后,用这些数据自查一遍:
输入答案考察点
3 5
..... / .#..# / .....11题面样例
1 1
.1单格荒地,无邻居
1 1
1单格是杂物,清除后变成可开垦
1 3
.#.3清除中间杂物后三格全部可开垦
2 2
.. / ..4本身全部可开垦,不需要清除
✅自查清单:① 单格判定检查四邻了吗?② ans 初始化为 baseline 了吗?③ 只重算了受影响的 5 格吗?
🚨 易错点清单
⚠️把 . 都当成可开垦:必须检查它的四邻是否都是 .,本题最容易数错的就是这一步。
⚠️忘记"可以不清除":如果所有清除尝试都让结果变差,应输出 baseline(题目说"至多一个")。
⚠️对每个杂物重算全图:n, m ≤ 1000 时会超时,必须利用"影响范围只有 5 格"。
时间复杂度
O(n × m)
空间复杂度
O(n × m)
n, m 最大
1000
最坏运算
约 5 × 10⁶
时间怎么算的?
预处理遍历全图 O(nm)
枚举每个杂物(最多 nm 个),每个重算 5 格
合计 O(nm × 5) ≈ 5 × 10⁶
空间都用在哪?
需要存整个字符网格,10⁶ 字节。
✅ 约 500 万次判断,瞬间完成。如果对每个杂物都重算全图,会变成 10¹² 次,必然超时。
// 网格题的"影响范围"思维
// 问:修改一个格子的值,会影响周围多少个格子的状态?
// 答:取决于"状态的依赖范围"
// 本题:状态依赖"自己 + 四邻" -> 影响范围 = 自己 + 四邻 = 5 格
// 若是"自己 + 8 邻" -> 影响范围 = 9 格
// 通用模板:增量计算
int base = computeAll();
int ans = base;
for (每个可修改位置 p) {
applyChange(p);
int delta = recomputeLocally(p); // 只重算受影响的范围
ans = max(ans, base + delta);
revertChange(p);
}
// 4 邻与 8 邻方向数组
int dx4[4] = {-1, 1, 0, 0}, dy4[4] = { 0, 0,-1, 1};
int dx8[8] = {-1,-1,-1,0,0,1,1,1}, dy8[8] = {-1,0,1,-1,1,-1,0,1};
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
局部影响范围状态只依赖有限邻域扫雷、生命游戏、网格增量更新
预处理 + 增量先算基准值,再算增量所有"修改一次求最优"的题目
边界四邻越界就跳过所有网格题目的必备写法
🌟思考题:如果题目改成可以清除两个杂物,还能用"只重算 5 格"的技巧吗?(提示:会变复杂得多——两个杂物若相邻,影响范围会重叠;一种可行思路是枚举所有相邻的杂物对,对每对考虑"重叠部分只算一次",但更常见的是用"每个位置单独的最优增量 + 组合修正"来处理,难度会明显上升。)
..... .#..# .....
#include <bits/stdc++.h>

using namespace std;


int n, m;

char g[1005][1005];

int dx[4] = {-1, 1, 0, 0};

int dy[4] = { 0, 0,-1, 1};


// 判断 (i, j) 是否可以开垦

bool canTill(int i, int j) {

    if (i < 0 || i >= n || j < 0 || j >= m) return false;

    if (g[i][j] != '.') return false;

    for (int d = 0; d < 4; d++) {

        int ni = i + dx[d], nj = j + dy[d];

        if (ni < 0 || ni >= n || nj < 0 || nj >= m) continue;

        if (g[ni][nj] != '.') return false;   // 邻居有杂物

    }

    return true;

}


int main() {

    scanf("%d %d", &n, &m);

    for (int i = 0; i < n; i++) scanf("%s", g[i]);


    // 1) 预处理:不清除任何杂物时的可开垦数

    int base = 0;

    for (int i = 0; i < n; i++)

        for (int j = 0; j < m; j++)

            if (canTill(i, j)) base++;


    int ans = base;      // 允许"不清除"


    // 2) 枚举清除每个杂物,只重算它自己和四邻

    for (int i = 0; i < n; i++) {

        for (int j = 0; j < m; j++) {

            if (g[i][j] != '#') continue;


            // 记录受影响的 5 格原本的可开垦情况

            int oldCnt = 0, newCnt = 0;

            int pi[5], pj[5], cnt = 0;

            pi[cnt] = i; pj[cnt] = j; cnt++;

            for (int d = 0; d < 4; d++) {

                int ni = i + dx[d], nj = j + dy[d];

                if (ni < 0 || ni >= n || nj < 0 || nj >= m) continue;

                pi[cnt] = ni; pj[cnt] = nj; cnt++;

            }

            for (int k = 0; k < cnt; k++) if (canTill(pi[k], pj[k])) oldCnt++;


            // 清除杂物后重新计算这 5 格

            g[i][j] = '.';

            for (int k = 0; k < cnt; k++) if (canTill(pi[k], pj[k])) newCnt++;

            g[i][j] = '#';                       // 还原


            if (base - oldCnt + newCnt > ans) ans = base - oldCnt + newCnt;

        }

    }


    printf("%d\n", ans);

    return 0;

}// 网格题的"影响范围"思维
// 问:修改一个格子的值,会影响周围多少个格子的状态?
// 答:取决于"状态的依赖范围"
// 本题:状态依赖"自己 + 四邻" -> 影响范围 = 自己 + 四邻 = 5 格
// 若是"自己 + 8 邻" -> 影响范围 = 9 格
// 通用模板:增量计算
int base = computeAll();
int ans = base;
for (每个可修改位置 p) {
applyChange(p);
int delta = recomputeLocally(p); // 只重算受影响的范围
ans = max(ans, base + delta);
revertChange(p);
}
// 4 邻与 8 邻方向数组
int dx4[4] = {-1, 1, 0, 0}, dy4[4] = { 0, 0,-1, 1};
int dx8[8] = {-1,-1,-1,0,0,1,1,1}, dy8[8] = {-1,0,1,-1,1,-1,0,1};幻方看似神奇,但当 N 为奇数时有很方便的填法:
1. 一开始正方形中没有填任何数字。首先,在第一行的正中央填上 1。
2. 从上次填数字的位置向上移动一格,如果已经在第一行,则移到同一列的最后一行;再向右移动一格,如果已经在最右一列,则移动至同一行的第一列。如果移动后的位置没有填数字,则把上次填写的数字的下一个数字填到这个位置。
3. 如果第 2 步填写失败,则从上次填数字的位置向下移动一格,如果已经在最下一行,则移到同一列的第一行。这个位置一定是空的(这可太神奇了!)。把上次填写的数字的下一个数字填到这个位置。
4. 重复 2、3 步骤,直到所有格子都被填满,幻方就完成了!
快来编写一个程序,按上述规则,制作一个 N× N 的幻方吧。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 3 | 8 1 6 3 5 7 4 9 2 |
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
幻方是 N × N 的方阵,填入 1 ~ N² 使每行、每列、两条对角线上数字之和都相等。当 N 为奇数时有如下填法:
在第一行的正中央填 1
从上次填数的位置向上移动一格(已在第一行则移到同一列的最后一行);再向右移动一格(已在最右列则移到同一行的第一列)。若该位置为空,就填下一个数
若第 2 步的位置已被占,则改为从上次位置向下移动一格(已在最后一行则移到第一行),这个位置一定是空的,填下一个数
重复第 2、3 步直到填满
💡人话翻译:这是著名的"罗伯法"(Siamese method)。记忆口诀:「右上斜填,出上填下,出右填左,遇阻下移」。用取模运算就能优雅地实现"越界环绕"。
🔍 关键词提取
罗伯法取模环绕二维数组模拟奇数阶幻方
已知条件
项目说明
输入一个正奇数 N
输出N 行,每行 N 个空格分隔的正整数
数据范围3 ≤ N ≤ 21
阶数保证为奇数
填法从第 1 行中间开始,向右上斜填
需要解决的问题
怎么从 (r, c) 移到右上?nr = (r − 1 + N) % N、nc = (c + 1) % N
怎么判断位置被占?数组初始化为 0,a[nr][nc] != 0 表示已填
撞格后怎么下移?nr = (r + 1) % N,列不变
📥 初始化
N × N 数组置 0
从第 1 行中间开始
即 (0, N/2) 填 1
N 为奇数保证有正中央
➡️ 右上移动
nr = (r − 1 + N) % N
nc = (c + 1) % N
取模实现环绕
出上填下、出右填左
🚧 撞格处理
若 a[nr][nc] 非 0
改为 nr = (r + 1) % N
列不变
该位置必定为空
⚠️ 易错点
忘记取模导致越界
撞格时列也跟着变(应不变)
取模写成 (r-1)%N(负数)
循环次数写成 N 而非 N²
先初始化全 0,然后从 (0, 1) 开始填 1。
步骤填的数位置 (行, 列)说明
11(0, 1)第 1 行正中央
22(2, 2)右上越上界 → 环绕到最后一行
33(1, 0)右上越右界 → 环绕到第一列
44(2, 0)右上到 (0,1) 已被 1 占 → 下移到 (2,0)
55(1, 1)继续右上
66(0, 2)右上越上界 → 环绕
77(2, 1)右上到 (0,2) 已被 6 占 → 下移
88(1, 2)继续右上
99(0, 0)右上越上界 → 环绕
1
每次"右上"用取模实现
上移:(r − 1 + N) % N,加 N 是为了避免负数取模
右移:(c + 1) % N
例如 (0,1) 右上 → ((0−1+3)%3, (1+1)%3) = (2, 2) ✅
环绕逻辑用取模一次搞定
2
撞格时下移
例如准备填 4 时,从 (1,0) 右上到 (0,1)
(0,1) 已有数字 1 → 撞格
改为下移:(1+1)%3 = 2,列不变 → (2, 0) ✅
(2,0) 填 4
最终结果
8 1 6
3 5 7
4 9 2
验证:每行每列每条对角线之和都是 15 = N(N²+1)/2 ✓
🔑为什么撞格后"下移"的位置一定是空的?这是罗伯法最神奇的性质:因为上一格是刚填的数,而"右下"这个位置在斜向填法的路径上必然还没被占用。题目里也特意说明"这个位置一定是空的(这可太神奇了!)"。所以我们不需要额外判断,直接填即可。
🧮 取模的陷阱:负数取模
计算 r − 1 时如果 r = 0,结果是 −1,而 C++ 中 −1 % 3 = −1(不是 2!)。这就是必须写成 (r − 1 + N) % N 的原因。
表达式r = 0 时的结果是否正确
(r - 1) % N-1❌ 负数,导致数组越界
(r - 1 + N) % N2✅ 正确
(r + N - 1) % N2✅ 等价写法
⚠️这是本题最容易出错的地方。C++ 的取模运算对负数保留负号,所以 (r - 1) % N 在 r = 0 时会得到 −1,用它当下标会数组越界,程序可能崩溃或输出乱码。记牢:环形下标一定要先加 N 再取模。
🟢 取模环绕(推荐) 推荐
用 (r-1+N)%N 和 (c+1)%N 一次算出目标位置
时间 O(N²)
每步 O(1)
代码 15 行
不需要写边界 if
💡核心代码:int nr = (r - 1 + n) % n, nc = (c + 1) % n; if (a[nr][nc]) { nr = (r + 1) % n; nc = c; }——三行完成"右上 + 撞格下移"。
🟠 if 判断四个边界
分别判断"是否在第一行""是否在最右列"再决定移动
功能等价
代码多 10 行以上
四个分支容易漏或写错
不如取模简洁
⚠️注意:用 if 写法时,"上移 + 右移"两个方向都要单独判断边界,而且"撞格下移"时也要判断是否在最后一行——一共 3 处边界判断,出错的几率明显更高。
📈 性能对比
方案代码量边界出错风险
取模环绕约 15 行低
if 判断约 30 行中高
输入一个正奇数 N(3 ~ 11),程序会按罗伯法生成幻方。
输入 N
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int a[25][25];
int main() {
int n;
scanf("%d", &n);
int r = 0, c = n / 2; // 第 1 行正中央
a[r][c] = 1;
for (int k = 2; k <= n * n; k++) {
// 先尝试向右上移动(加 n 再取模,避免负数)
int nr = (r - 1 + n) % n;
int nc = (c + 1) % n;
if (a[nr][nc] != 0) {
// 目标位置已被占用 → 改为向下移动一格
nr = (r + 1) % n;
nc = c; // 列不变
}
a[nr][nc] = k;
r = nr;
c = nc;
}
for (int i = 0; i < n; i++) {
for (int j = 0; j < n; j++) {
if (j) printf(" ");
printf("%d", a[i][j]);
}
printf("\n");
}
return 0;
}
🔑(r - 1 + n) % n 里的 + n 能省吗?不能省。当 r = 0 时 r - 1 = -1,而 C++ 中 -1 % n = -1(保留负号),用它做下标会越界。先加 n 把被除数变成正数,取模结果自然就落在 [0, n) 里了。
📖 关键几行怎么看
代码作用为什么这样写
c = n / 2正中央N 为奇数,n/2 正好是中间列(0 基)
(r - 1 + n) % n向上环绕+n 是为了避免负数取模
(c + 1) % n向右环绕c+1 最大是 n,取模变回 0
nc = c;(撞格时)列不变下移只改变行,列保持
⚠️三个坑:① 写成 (r - 1) % n,负数下标导致越界;② 撞格时把列也改了(应该只改行);③ 起始位置写成 (0, n/2) 之外的地方(必须是第 1 行正中央)。
写完程序后,用这些数据自查一遍:
输入答案考察点
38 1 6 / 3 5 7 / 4 9 2题面样例
517 24 1 8 15 / 23 5 7 14 16 / 4 6 13 20 22 / 10 12 19 21 3 / 11 18 25 2 95 阶幻方(每行和 65)
1(题目保证 N ≥ 3)题目范围外
21每行和 = 21 × 442 / 2 = 4641最大规模
✅自查清单:① 取模前加 N 了吗?② 撞格时只改行吗?③ 起始位置对吗?
🚨 易错点清单
⚠️负数取模:(r - 1) % n 在 r = 0 时得 −1,必须写成 (r - 1 + n) % n。
⚠️撞格时列也变了:下移只改变行,列必须保持不变。
⚠️起始位置错:必须是第 1 行正中央,即 0 基的 (0, n/2)。
时间复杂度
O(N²)
空间复杂度
O(N²)
N 最大
21
格子数
441
时间怎么算的?
共填 N² 个数
每个数做常数次运算(取模、判断)
合计 O(N²)
空间都用在哪?
一个 N × N 的数组,最多 21 × 21 = 441 个位置。
✅ 441 次填写,瞬间完成。这题考的是"用取模优雅处理环形边界"这个技巧。
// 环形下标的正确写法(关键技巧)
int prevRow = (r - 1 + n) % n; // 上移,环绕
int nextRow = (r + 1) % n; // 下移,环绕
int nextCol = (c + 1) % n; // 右移,环绕
int prevCol = (c - 1 + n) % n; // 左移,环绕
// 通用公式:把 (i + delta) 折到 [0, n)
int wrap(int i, int delta, int n) { return ((i + delta) % n + n) % n; }
// 幻方的性质
// 每行/每列/对角线的和都等于 n(nn+1)/2
// 称为"幻和"
// 偶数阶幻方需要别的构造法(如"双偶""单偶"方法)
// 本题只要求奇数阶,所以罗伯法足够
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
取模环绕(i - 1 + n) % n矩阵环绕、循环数组、约瑟夫环
撞格下移罗伯法的关键分支所有"斜向填数"类构造题
负数取模陷阱C++ 保留负号所有环形下标计算
🌟思考题:你能验证"每行之和都等于 N(N²+1)/2"吗?(提示:1 + 2 + … + N² = N²(N²+1)/2,平均分到 N 行,每行就是 N(N²+1)/2。这说明了幻和必然是这个值,可以用来检查自己的输出是否正确——写程序时加一句断言就能快速定位错误。)
8 1 6

3 5 7

4 9 2
#include <bits/stdc++.h>

using namespace std;


int a[25][25];


int main() {

    int n;

    scanf("%d", &n);


    int r = 0, c = n / 2;      // 第 1 行正中央

    a[r][c] = 1;


    for (int k = 2; k <= n * n; k++) {

        // 先尝试向右上移动(加 n 再取模,避免负数)

        int nr = (r - 1 + n) % n;

        int nc = (c + 1) % n;


        if (a[nr][nc] != 0) {

            // 目标位置已被占用 → 改为向下移动一格

            nr = (r + 1) % n;

            nc = c;                    // 列不变

        }


        a[nr][nc] = k;

        r = nr;

        c = nc;

    }


    for (int i = 0; i < n; i++) {

        for (int j = 0; j < n; j++) {

            if (j) printf(" ");

            printf("%d", a[i][j]);

        }

        printf("\n");

    }

    return 0;

}// 环形下标的正确写法(关键技巧)
int prevRow = (r - 1 + n) % n; // 上移,环绕
int nextRow = (r + 1) % n; // 下移,环绕
int nextCol = (c + 1) % n; // 右移,环绕
int prevCol = (c - 1 + n) % n; // 左移,环绕
// 通用公式:把 (i + delta) 折到 [0, n)
int wrap(int i, int delta, int n) { return ((i + delta) % n + n) % n; }
// 幻方的性质
// 每行/每列/对角线的和都等于 n*(n*n+1)/2
// 称为"幻和"
// 偶数阶幻方需要别的构造法(如"双偶""单偶"方法)
// 本题只要求奇数阶,所以罗伯法足够②编程打卡 · 点一下就能勾选
- 完成 B3850《幸运数》,跑通全部样例
- 完成 B4040《黑白方块》,跑通全部样例
- 完成 B4263《荒地开垦》,跑通全部样例
- 完成 B3940《填幻方》,跑通全部样例
- 对比题解里的参考代码,找出自己写法的差异
数组与下标
①本日知识点 · 数组与下标
下标 0 起,先画下标与值的对应表,再写循环。
本组 2 道题全部来自 GESP 真题,按「数组与下标」归在一起练。题面取洛谷原题(含公式与样例),题解取美力程 GESP 题解库(思路 + 参考代码 + 复杂度)。
之后 n 行,每行一个长度为 m 的 01 串,代表网格图第 i 行格子的颜色,如果为 0,则对应格子为白色,否则为黑色。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 4 5 00000 01111 00011 00011 | 16 |
对于样例 1,假设 (i,j) 代表第 i 行第 j 列,最大的平衡子矩形的四个顶点分别为 (1,2),(1,5),(4,2),(4,5)。
【数据范围】
对于全部数据,保证有 1≤q n,m≤q 10。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
给定 n 行 m 列的 01 网格(0 白、1 黑)。若一个子矩形中黑色格子与白色格子数量相同,则称它是平衡的。
求最大的平衡子矩形包含多少个格子;若不存在则输出 0。
💡人话翻译:找一个子矩形,里面 0 和 1 一样多。关键技巧是把 0 换成 −1,这样"数量相同"就变成了"和为 0",然后就能用前缀和快速判断了。
🔍 关键词提取
0 / 1 转换二维前缀和和为 0四重循环枚举
已知条件
项目说明
输入第一行 n、m;随后 n 行 01 串
输出最大平衡子矩形的格子数,无解输出 0
数据范围1 ≤ n, m ≤ 10
编码0 = 白色,1 = 黑色
平衡条件黑格数 == 白格数
需要解决的问题
怎么把"数量相等"变简单?把 0 看成 −1、1 看成 +1,那么"黑白各半"等价于区间和为 0
要枚举多少矩形?n, m ≤ 10 时最多 55 × 55 = 3025 个,非常少
怎么快速求和?二维前缀和 O(1)
🧠 核心转化
0 记作 −1
1 记作 +1
黑白相等 ⇒ 总和为 0
把计数问题变成求和问题
📊 前缀和
二维前缀和 pre[][]
矩形和 O(1) 查询
只需判断是否为 0
n, m ≤ 10 甚至可暴力
🔍 枚举矩形
四重循环:上下左右边界
面积 = 行数 × 列数
和为 0 就更新答案
注意无解输出 0
⚠️ 易错点
忘了 0 要转 −1
答案记录的是格子数不是和
无解时输出 0
面积计算漏 +1
00000

01111

00011

00011
1
第 1 步:先把 0 换成 −1
原网格:00000 / 01111 / 00011 / 00011
转换后:−1 −1 −1 −1 −1
−1 +1 +1 +1 +1
−1 −1 −1 +1 +1
−1 −1 −1 +1 +1
转换完成
2
第 2 步:试整个网格(4×5 = 20 格)
总和 = −5 + 1 + 0 + 0 = −4
不为 0 → 不平衡
(也可以直接数:白 12 个、黑 8 个,确实不等)
❌ 20 格不行
3
第 3 步:试第 1~4 行、第 2~5 列(4×4 = 16 格)
取出的部分:0000 / 1111 / 0011 / 0011
白格数:4 + 0 + 2 + 2 = 8
黑格数:0 + 4 + 2 + 2 = 8
相等 → 平衡
✅ 16 格,是候选答案
4
第 4 步:还有更大的吗?
总格子数 20,比 16 大的只有 20(已排除)、18、17
18 格需要 3×6 或 6×3,但网格只有 4 行 5 列,不成立
17 格不是任何矩形的面积(矩形面积必为行数×列数)
所以 16 就是最大
✅ 输出 16
答案 16 ✓
🔑注意:答案是"格子数",不是"和"!前缀和在这里只用来判断是否平衡(和为 0),真正要输出的是矩形面积 = (r2−r1+1) × (c2−c1+1)。这两个概念千万不要混。
🧮 什么时候输出 0
如果整个网格中找不到任何平衡子矩形,就要输出 0。
数据分析答案
1 1 / 1只有一个黑格,但单个格子的面积是奇数,不可能黑白相等0
1 1 / 0只有一个白格,同理0
2 1 / 1 / 12 个黑格,白 0 个,不相等0
1 2 / 1 0一个黑一个白,相等 → 2 格2
2 2 / 0 1 / 1 0两个 0、两个 1 → 4 格4
⚠️一个重要观察:平衡要求黑格数 = 白格数,所以总面积一定是偶数。如果整个网格总格数是奇数,那就必须先排除"整个网格"这个候选,继续找更小的偶数面积矩形。没有任何候选时,按要求输出 0。
🟢 0→−1 + 前缀和(推荐) 推荐
把 0 记作 −1,用二维前缀和判断矩形和是否为 0
时间 O(n²m²)
每个矩形判定 O(1)
逻辑极简
n, m ≤ 10 更是随便过
💡为什么推荐:"两种元素数量相等"是极其常见的题设,把其中一种映射成 −1、另一种映射成 +1,就能用"和为 0"来统一判定,这是一维和二维问题的通用技巧。
🟠 每个矩形分别数黑白个数
对每个候选矩形遍历其内部格子,分别统计 0 和 1 的个数
时间 O(n²m² × nm)
本题 n, m ≤ 10 也够快
但代码更冗长
没有体现转化技巧
⚠️本题两者都能过:n, m ≤ 10 时最坏约 3000 × 100 = 30 万次,完全可行。但掌握 0→−1 技巧,在更大的数据范围下仍然是必需的。
📈 性能对比
方案单次判定代价可扩展性
0→−1 前缀和O(1)强(n, m 大也够)
逐格统计O(nm)弱
第一行输入 n 和 m,随后 n 行 01 串。程序会找出黑白数量相等的最大子矩形。
输入数据4 5
00000
01111
00011
00011
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int a[15][15];
int pre[15][15];
int main() {
int n, m;
scanf("%d %d", &n, &m);
for (int i = 1; i <= n; i++) {
string s;
cin >> s;
for (int j = 1; j <= m; j++) {
// 关键转换:0(白)记作 -1,1(黑)记作 +1
a[i][j] = (s[j - 1] == '0') ? -1 : 1;
}
}
// 二维前缀和(下标从 1 开始,省去边界特判)
for (int i = 1; i <= n; i++)
for (int j = 1; j <= m; j++)
pre[i][j] = pre[i-1][j] + pre[i][j-1] - pre[i-1][j-1] + a[i][j];
int ans = 0;
for (int r1 = 1; r1 <= n; r1++)
for (int r2 = r1; r2 <= n; r2++)
for (int c1 = 1; c1 <= m; c1++)
for (int c2 = c1; c2 <= m; c2++) {
// 矩形和,为 0 说明黑白数量相等
int sum = pre[r2][c2] - pre[r1-1][c2] - pre[r2][c1-1] + pre[r1-1][c1-1];
if (sum == 0) {
int cells = (r2 - r1 + 1) * (c2 - c1 + 1);
if (cells > ans) ans = cells; // 注意记录的是面积
}
}
printf("%d\n", ans); // 无解时 ans 保持 0,正好符合要求
return 0;
}
🔑为什么答案初始化为 0 就够了?因为题目要求"不存在则输出 0",而 ans 初始为 0,找不到任何平衡矩形时就自然输出 0,不需要任何额外的无解判断。这种"让初值恰好等于无解答案"的写法很省事。
📖 关键几行怎么看
代码作用为什么这样写
(s[j-1] == '0') ? -1 : 1关键转换把"数量相等"变成"和为 0"
pre[i][j] = pre[i-1][j] + pre[i][j-1] - pre[i-1][j-1] + a[i][j]二维前缀和容斥原理,下标从 1 开始可免特判
if (sum == 0)平衡判定和为 0 等价于黑白数量相等
int cells = (r2-r1+1) * (c2-c1+1);面积输出的是格子数,不是和
⚠️三个坑:① 忘了把 0 转成 −1(那样"和为 0"就不再代表平衡);② 把 sum 当成答案输出(应该输出面积);③ 面积漏掉 +1,行数是 r2 - r1 + 1。
写完程序后,用这些数据自查一遍:
输入答案考察点
4 5
00000 / 01111 / 00011 / 0001116题面样例
1 1
10单格无法平衡,输出 0
1 2
1 02一黑一白,恰好平衡
2 2
0 1 / 1 04两黑两白,整个网格平衡
2 2
0 0 / 0 00全是白格,不可能黑白相等
1 4
1 1 0 04两黑两白,整行平衡
✅自查清单:① 做了 0→−1 转换吗?② 输出的意思是格子数吗?③ 无解时输出 0 吗?
🚨 易错点清单
⚠️忘记 0→−1 转换:那样和 == 0就不代表黑白相等了,必须做映射。
⚠️把和当答案:是要输出格子数,而平衡时和恰好是 0,直接输出会全错。
⚠️面积漏 +1:行数 = r2 − r1 + 1,列数 = c2 − c1 + 1。
时间复杂度
O(n²m²)
空间复杂度
O(nm)
n, m 最大
10
最坏运算
约 3000 次判定
时间怎么算的?
枚举四个边界:约 n(n+1)/2 × m(m+1)/2 种组合
n = m = 10 时约 55 × 55 = 3025 次
每次用前缀和 O(1) 判定
空间都用在哪?
需要存网格和前缀和,各 10 × 10。
✅ 约 3000 次判定,任何语言瞬间完成。n, m ≤ 10 这个范围本身就在提示:暴力枚举即可。
// "数量相等" 类问题的通用转换技巧
// 两种状态 -> 分别映射为 +1 / -1
// "两者数量相等" <=> "区间和为 0"
// 例如:黑白相等、AB 数量相等、+/- 抵消、括号匹配
// 二维前缀和(下标从 1 开始)
long long pre[15][15];
for (int i = 1; i <= n; i++)
for (int j = 1; j <= m; j++)
pre[i][j] = pre[i-1][j] + pre[i][j-1] - pre[i-1][j-1] + a[i][j];
// 矩形和
long long rectSum(int r1, int c1, int r2, int c2) {
return pre[r2][c2] - pre[r1-1][c2] - pre[r2][c1-1] + pre[r1-1][c1-1];
}
// 一维版本:求最长的"0/1 数量相等"的子数组
// 也完全一样:把 1 记作 +1、0 记作 -1,找前缀和相等的最远两点
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
数量相等 → 和为 0+1 / −1 映射括号匹配、黑白平衡、抵消计分
二维前缀和O(1) 矩形求和子矩阵统计、图像分析
暴力枚举边界四重循环小规模网格的最优子矩形问题
🌟思考题:如果数据范围放大到 n, m ≤ 500,四重循环就不够了(O(n²m²) 会超时)。该怎么优化?(提示:固定上下两行 r1、r2,把每一列在这两行之间的和压成一个数,问题就变成一维的"找和为 0 的最长子数组",可以用前缀和 + 哈希表在线性时间内解决,整体降到 O(n²m)。这是"最大子矩阵"类问题的经典降维套路。)
00000 01111 00011 00011
#include <bits/stdc++.h>

using namespace std;


int a[15][15];

int pre[15][15];


int main() {

    int n, m;

    scanf("%d %d", &n, &m);


    for (int i = 1; i <= n; i++) {

        string s;

        cin >> s;

        for (int j = 1; j <= m; j++) {

            // 关键转换:0(白)记作 -1,1(黑)记作 +1

            a[i][j] = (s[j - 1] == '0') ? -1 : 1;

        }

    }


    // 二维前缀和(下标从 1 开始,省去边界特判)

    for (int i = 1; i <= n; i++)

        for (int j = 1; j <= m; j++)

            pre[i][j] = pre[i-1][j] + pre[i][j-1] - pre[i-1][j-1] + a[i][j];


    int ans = 0;

    for (int r1 = 1; r1 <= n; r1++)

        for (int r2 = r1; r2 <= n; r2++)

            for (int c1 = 1; c1 <= m; c1++)

                for (int c2 = c1; c2 <= m; c2++) {

                    // 矩形和,为 0 说明黑白数量相等

                    int sum = pre[r2][c2] - pre[r1-1][c2] - pre[r2][c1-1] + pre[r1-1][c1-1];

                    if (sum == 0) {

                        int cells = (r2 - r1 + 1) * (c2 - c1 + 1);

                        if (cells > ans) ans = cells;      // 注意记录的是面积

                    }

                }


    printf("%d\n", ans);      // 无解时 ans 保持 0,正好符合要求

    return 0;

}// "数量相等" 类问题的通用转换技巧
// 两种状态 -> 分别映射为 +1 / -1
// "两者数量相等" <=> "区间和为 0"
// 例如:黑白相等、AB 数量相等、+/- 抵消、括号匹配
// 二维前缀和(下标从 1 开始)
long long pre[15][15];
for (int i = 1; i <= n; i++)
for (int j = 1; j <= m; j++)
pre[i][j] = pre[i-1][j] + pre[i][j-1] - pre[i-1][j-1] + a[i][j];
// 矩形和
long long rectSum(int r1, int c1, int r2, int c2) {
return pre[r2][c2] - pre[r1-1][c2] - pre[r2][c1-1] + pre[r1-1][c1-1];
}
// 一维版本:求最长的"0/1 数量相等"的子数组
// 也完全一样:把 1 记作 +1、0 记作 -1,找前缀和相等的最远两点小杨同学希望生成的地图大小为 n 行 m 列,一共 n × m 个区块。区块行号为 1, 2, …, n,列号为 1, 2, …, m。其中一些区块为雷区,其它区块不为雷区。
小杨同学指定了 q 个区块为雷区,而其它区块均不为雷区。小杨同学希望你帮忙计算非雷区的区块,每个区块与多少个雷区相邻?
我们定义区块相邻,当且仅当两个区块至少有一个公共顶点(也就是说对于不在地图边缘的区块,周围 8 个区块均与其相邻)。
第一行,三个正整数 n, m 和 q,分别表示地图行数和列数,以及雷区数量。
接下来的 q 行,每行有 2 个整数,分别表示第 i 个雷区的行号和列号。
保证输入的雷区不重复。
1. 如果为雷区,输出 *;
2. 如果不是雷区,输出其相邻雷区数量(输出 0 到 8 中的一个数字)。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 3 4 4 1 1 1 3 2 4 3 2 | * 2 * 2 2 3 3 * 1 * 2 1 |
根据输入,在 3 × 4 的地图上有 4 个雷区,分别是 (1,1),(1,3),(2,4) 和 (3,2),如输出样例中
* 所示,其它非雷区区块的相邻雷区数量可以直观看出。数据范围
3 ≤ n, m ≤ 500, 1 ≤ q ≤ n · m。
输入的雷区必定在地图内且不重复,注意行号和列号均从 1 开始。
· 把规则一步步翻译成代码,用变量记住当前状态。
· 先把「初值 / 条件 / 更新」三件事写清,再数内层循环跑几次;输出题一定要在草稿上列表。
写完后可到洛谷
B4557 对照题解。②编程打卡 · 点一下就能勾选
- 完成 B4005《黑白方块》,跑通全部样例
- 完成 B4557《扫雷》,跑通全部样例
- 对比题解里的参考代码,找出自己写法的差异
图案输出 · 嵌套循环画图
①本日知识点 · 图案输出 · 嵌套循环画图
外层管行、内层管列;先数清「每行几个、前面几个空格」。
本组 1 道题全部来自 GESP 真题,按「图案输出 · 嵌套循环画图」归在一起练。题面取洛谷原题(含公式与样例),题解取美力程 GESP 题解库(思路 + 参考代码 + 复杂度)。
小 A 认为一个 2 × 2 的矩阵 D 是好的,当且仅当 D_{1,1} × D_{2,2} = D_{1,2} × D_{2,1}。其中 D_{i,j} 表示矩阵 D 的第 i 行第 j 列的元素。
小 A 想知道 A 中有多少个好的子矩阵。
接下来 n 行,每行 m 个整数 A_{i,1}, A_{i,2}, …, A_{i,m}。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 3 4 1 2 1 0 2 4 2 1 0 3 3 0 | 2 |
样例中好的子矩阵如下:
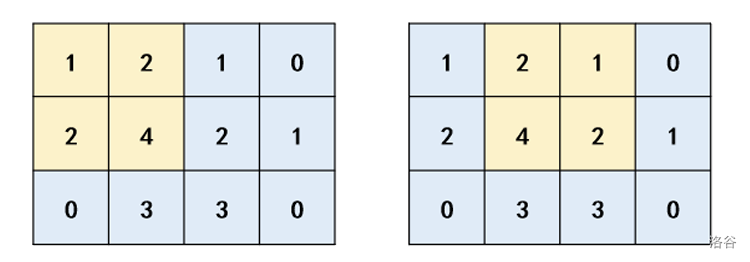
数据范围
对于所有测试点,保证 1≤q n≤q 500,1≤q m≤q 500,-100≤q A_{i,j}≤q 100
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
给定 n 行 m 列的矩阵 A。
一个 2 × 2 的矩阵 D 是好的,当且仅当 D₁,₁ × D₂,₂ = D₁,₂ × D₂,₁。
求 A 中有多少个好的子矩阵。
💡人话翻译:把每个 2 × 2 的小方块都取出来,算两条对角线的乘积是否相等——相等就计数。这个条件其实就是"二阶行列式为 0",在数学上表示"两行(或两列)成比例"。
🔍 关键词提取
2×2 子矩阵枚举左上角乘法比较行列式
已知条件
项目说明
输入第一行 n、m;随后 n 行每行 m 个整数
输出好的 2×2 子矩阵个数
数据范围1 ≤ n, m ≤ 500
数值范围−100 ≤ Aᵢⱼ ≤ 100
判定条件D₁₁ × D₂₂ == D₁₂ × D₂₁
需要解决的问题
有多少个 2×2 子矩阵?(n−1) × (m−1) 个,最多约 25 万个
怎么枚举?枚举左上角 (i, j),注意 i ≤ n−2、j ≤ m−2
乘积会溢出吗?不会。100 × 100 = 10⁴,int 完全够。
📥 读入
n、m ≤ 500
值域 −100 ~ 100
乘积最大 10⁴
int 足够
🔍 枚举
左上角 (i, j)
i 从 0 到 n−2
j 从 0 到 m−2
共 (n−1)(m−1) 个
✅ 判定
取四个元素
D₁₁=a[i][j]、D₂₂=a[i+1][j+1]
D₁₂=a[i][j+1]、D₂₁=a[i+1][j]
比乘积是否相等
⚠️ 易错点
循环上界写成 i < n
四个元素取错位置
用了除法代替乘法
负数情况
1 2 1 0
2 4 2 1
0 3 3 0
n = 3、m = 4,所以有 (3−1) × (4−1) = 6 个候选子矩阵。
左上角D 的四个元素(第一行 / 第二行)D₁₁×D₂₂D₁₂×D₂₁好的?
(1,1)1 2 / 2 41 × 4 = 42 × 2 = 4✅
(1,2)2 1 / 4 22 × 2 = 41 × 4 = 4✅
(1,3)1 0 / 2 11 × 1 = 10 × 2 = 0❌
(2,1)2 4 / 0 32 × 3 = 64 × 0 = 0❌
(2,2)4 2 / 3 34 × 3 = 122 × 3 = 6❌
(2,3)2 1 / 3 02 × 0 = 01 × 3 = 3❌
1
为什么前两个是"好的"?
(1,1) 的四个数是 1、2、2、4
两条对角乘积都是 4,相等 ✅
实际上第二行是第一行的 2 倍(成比例),所以行列式为 0
✅ 计数加 2
2
其余为什么不是?
如 (1,3):1 × 1 = 1,但 0 × 2 = 0,不相等
如 (2,1):2 × 3 = 6,但 4 × 0 = 0,不相等
❌ 不计数
答案 2 ✓
🔑为什么不能把等式改写成除法?因为 D₁₁ × D₂₂ = D₁₂ × D₂₁ 两边都可能为 0,一旦写成 D₁₁ / D₁₂ = D₂₁ / D₂₂ 就会出现除以 0。永远保持乘法形式,避免除零和浮点误差。
🟢 枚举左上角(推荐) 推荐
双层循环枚举左上角,直接取四个元素比较
时间 O(n × m)
代码 8 行
逻辑最直观
不需要额外空间
💡实现要点:for (i = 0; i + 1 < n; i++)、for (j = 0; j + 1 < m; j++),这样天然保证不会越界。
🟠 先固定两行再滑列
先枚举上下两行 i、i+1,再让列 j 滑动比较
复杂度完全一样
代码层次更多
好处是便于复用行数据
本题没必要
⚠️等价写法:两种枚举顺序结果相同。当窗口是"两行 + 多列"时,固定行的写法有时更方便,比如可以在列方向用前缀信息做优化。
📈 性能对比
方案时间复杂度代码量
枚举左上角O(n × m)约 8 行
固定两行滑列O(n × m)约 12 行
第一行输入 n 和 m,随后 n 行每行 m 个整数。程序会检查所有 2×2 子矩阵。
输入数据3 4
1 2 1 0
2 4 2 1
0 3 3 0
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int A[505][505];
int main() {
int n, m;
scanf("%d %d", &n, &m);
for (int i = 0; i < n; i++)
for (int j = 0; j < m; j++)
scanf("%d", &A[i][j]);
int ans = 0;
// 枚举 2×2 子矩阵的左上角
for (int i = 0; i + 1 < n; i++) {
for (int j = 0; j + 1 < m; j++) {
// 四个元素
int d11 = A[i][j], d12 = A[i][j + 1];
int d21 = A[i + 1][j], d22 = A[i + 1][j + 1];
if (d11 * d22 == d12 * d21) ans++;
}
}
printf("%d\n", ans);
return 0;
}
🔑循环条件写 i + 1 < n 而不是 i < n - 1 有什么好处?两种写法等价,但 i + 1 < n 直接表达"右下角的行 i+1 必须还在矩阵内",与访问 A[i+1][...] 的形式对应,更不容易写错边界。写二维网格的窗口题时,这是一个很好用的习惯。
📖 关键几行怎么看
代码作用为什么这样写
i + 1 < n保证右下角不越界与 A[i+1] 的访问形式对应
d11 = A[i][j]主对角左上行 i、列 j
d22 = A[i+1][j+1]主对角右下行 i+1、列 j+1
d11 * d22 == d12 * d21判定条件保持乘法形式,避免除零
⚠️三个坑:① 四个元素的位置取错(比如把 D₁₂ 写成 A[i+1][j]);② 把等式改写成除法,遇到 0 时崩溃或结果错误;③ 循环上界写成 i < n,访问 A[i+1] 越界。
写完程序后,用这些数据自查一遍:
输入答案考察点
3 4
1 2 1 0 / 2 4 2 1 / 0 3 3 02题面样例
2 2
1 2 / 2 41恰好只有一个子矩阵
2 2
1 2 / 3 401×4 = 4 ≠ 2×3 = 6
2 3
1 0 0 / 0 0 12含 0 时乘积可能都是 0,需逐个验证
2 2
0 0 / 0 01全 0 时两边乘积都是 0,成立
✅自查清单:① 四个元素取对了吗?② 用的是乘法比较吗?③ 循环上界对吗?
🚨 易错点清单
⚠️把等式改成除法:D11 / D12 == D21 / D22 在含 0 时会除零或出错,必须保持乘法。
⚠️四个元素位置取错:D₁₂ 是"第 1 行第 2 列",即 A[i][j+1],不要和 A[i+1][j] 混淆。
⚠️循环越界:左上角行下标最大是 n − 2,列下标最大是 m − 2。
时间复杂度
O(n × m)
空间复杂度
O(n × m)
n, m 最大
500
最坏运算
约 2.5 × 10⁵
时间怎么算的?
枚举 (n−1) × (m−1) 个左上角
每个做 2 次乘法和 1 次比较
n = m = 500 时约 25 万次
空间都用在哪?
需要存整个矩阵,500 × 500 = 25 万个 int。
✅ 25 万次判断,瞬间完成。
// 二阶行列式的几何意义
// det = D11D22 - D12D21
// det == 0 <=> 两行(或两列)线性相关(成比例)
// 例如 [1 2; 2 4] 的第二行是第一行的 2 倍 -> det = 0
// 判断是否成比例(用交叉相乘避免除法)
bool proportional(int a, int b, int c, int d) {
return a * d == b * c; // 不要写成 a/b == c/d
}
// 扩展到 3×3 行列式(Sarrus 法则)
// det = a11a22a33 + a12a23a31 + a13a21a32
// - a13a22a31 - a11a23a32 - a12a21a33
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
交叉相乘用乘法代替除法比较比例所有"判断成比例"的题目
行列式为 0几何上表示向量共线/降维线性代数、几何判定
窗口枚举固定窗口的左上角双层循环卷积、局部统计
🌟思考题:如果题目改成"有多少个 2 × 2 子矩阵的行列式绝对值等于 0",答案会变吗?(提示:完全一样——因为 a × d = b × c 等价于 a × d − b × c = 0,也就是行列式为 0;绝对值只是把"负数"也纳入,而 0 的绝对值还是 0。)
1 2 1 0 2 4 2 1 0 3 3 0
#include <bits/stdc++.h>
using namespace std;
int A[505][505];
int main() {
int n, m;
scanf("%d %d", &n, &m);
for (int i = 0; i < n; i++)
for (int j = 0; j < m; j++)
scanf("%d", &A[i][j]);
int ans = 0;
// 枚举 2×2 子矩阵的左上角
for (int i = 0; i + 1 < n; i++) {
for (int j = 0; j + 1 < m; j++) {
// 四个元素
int d11 = A[i][j], d12 = A[i][j + 1];
int d21 = A[i + 1][j], d22 = A[i + 1][j + 1];
if (d11 * d22 == d12 * d21) ans++;
}
}
printf("%d\n", ans);
return 0;
}// 二阶行列式的几何意义
// det = D11*D22 - D12*D21
// det == 0 <=> 两行(或两列)线性相关(成比例)
// 例如 [1 2; 2 4] 的第二行是第一行的 2 倍 -> det = 0
// 判断是否成比例(用交叉相乘避免除法)
bool proportional(int a, int b, int c, int d) {
return a * d == b * c; // 不要写成 a/b == c/d
}
// 扩展到 3×3 行列式(Sarrus 法则)
// det = a11*a22*a33 + a12*a23*a31 + a13*a21*a32
// - a13*a22*a31 - a11*a23*a32 - a12*a21*a33②编程打卡 · 点一下就能勾选
- 完成 B4264《二阶矩阵》,跑通全部样例
- 对比题解里的参考代码,找出自己写法的差异
字符串处理
①本日知识点 · 字符串处理
逐字符遍历;注意 strlen 不含 \0、位移要回绕。
本组 5 道题全部来自 GESP 真题,按「字符串处理」归在一起练。题面取洛谷原题(含公式与样例),题解取美力程 GESP 题解库(思路 + 参考代码 + 复杂度)。
小 A 将画布交给了你,你能帮他完成画布的裁剪吗?
第二行,四个正整数 x_1, x_2, y_1, y_2,表示保留的行列边界。
接下来 h 行,每行一个长度为 w 的字符串,表示画布内容。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 3 5 2 2 2 4 ..... .>_<. ..... | >_< |
| 2 | 5 5 1 2 3 4 AbCdE fGhIk LmNoP qRsTu VwXyZ | Cd hI |
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
画布是 h 行 w 列的字符矩阵,字符都是 ASCII 码 33 ~ 126 之间的可见字符。
给定 x₁, x₂, y₁, y₂,只保留第 x₁ 到 x₂ 行、第 y₁ 到 y₂ 列构成的子矩阵,输出裁剪后的画布。
💡人话翻译:这是一道"按坐标取子矩形"的模拟题。唯一的坑是题目用的是 1 基下标(第 1 行是第 1 行,不是第 0 行),而 C++ 的字符串下标从 0 开始,需要做一次转换。
🔍 关键词提取
子矩阵截取1 基下标转换字符串 substr
已知条件
项目说明
输入第一行 h、w;第二行 x₁ x₂ y₁ y₂;随后 h 行字符串
输出x₂ − x₁ + 1 行,每行 y₂ − y₁ + 1 个字符
数据范围1 ≤ h, w ≤ 100
下标范围1 ≤ x₁ ≤ x₂ ≤ h,1 ≤ y₁ ≤ y₂ ≤ w
字符集ASCII 33 ~ 126 的可见字符(不含空格)
需要解决的问题
要输出几行几列?行数是 x₂ − x₁ + 1,列数是 y₂ − y₁ + 1(注意 +1)
C++ 下标怎么转换?第 x 行 → 下标 x − 1;第 y 到 y₂ 列 → s.substr(y − 1, y₂ − y + 1)
要处理空格吗?不用,字符集不含空格,可以直接用 cin >> 读整行
📥 读入
h、w
x₁ x₂ y₁ y₂
h 行字符串
字符不含空格
🔢 下标转换
题目 1 基
C++ 0 基
行下标 = x − 1
列起点 = y₁ − 1
✂️ 截取
循环 x 从 x₁ 到 x₂
每行取 substr(y₁−1, 长度)
长度 = y₂ − y₁ + 1
逐行输出
⚠️ 易错点
长度忘记 +1
行下标未 −1
用 getline 引入了换行问题
输出多/少一行
3 5
2 2 2 4
.....
.>_<.
.....
1
确定输出尺寸
行数 = x₂ − x₁ + 1 = 2 − 2 + 1 = 1
列数 = y₂ − y₁ + 1 = 4 − 2 + 1 = 3
输出 1 行 3 列
2
定位到第 2 行
题目第 2 行 → C++ 下标 1
该行字符串是 ".>_<."
下标:0 = '.'、1 = '>'、2 = '_'、3 = '<'、4 = '.'
已定位到 ".>_<."
3
截取第 2 ~ 4 列
起点下标 = y₁ − 1 = 2 − 1 = 1
长度 = y₂ − y₁ + 1 = 3
substr(1, 3) → '>'、'_'、'<'
✅ 输出 ">_<"
输出:>_< ✓
🧮 样例 2:5 行 5 列,取第 1~2 行第 3~4 列
5 5
1 2 3 4
AbCdE
fGhIk
LmNoP
qRsTu
VwXyZ
题目行号C++ 下标原字符串取第 3~4 列(下标 2 起,长 2)
第 1 行0AbCdECd
第 2 行1fGhIkhI
第 3 行2LmNoP(不输出)
第 4 行3qRsTu(不输出)
第 5 行4VwXyZ(不输出)
输出:
Cd
hI ✓
🔑下标换算的统一公式:题目第 x 行 → 数组下标 x − 1;从第 y₁ 列开始取 y₂ − y₁ + 1 个字符 → substr(y₁ − 1, y₂ − y₁ + 1)。"起点减 1、长度是差值加 1"这两句记住,所有区间截取题都不会错。
🟢 substr 一次截取(推荐) 推荐
每行用 substr 取出指定列段,直接输出
时间 O(h × w)
每行只需一行代码
不需要内层循环
不易出错
💡为什么推荐:substr(pos, len) 正好表达"从 pos 开始取 len 个字符",与题目的区间描述一一对应。
🟠 逐字符输出
双重循环,逐格判断是否在范围内并输出
代码更长
需要额外判断列范围
容易多输出空格或换行
功能上等价
⚠️两种写法都能过:本题 h, w ≤ 100,规模极小。但 substr 写法更能体现"区间截取"的意图,更适合这类题。
📈 性能对比
方案代码量可读性
substr 截取约 5 行⭐⭐⭐⭐⭐
逐字符输出约 12 行⭐⭐⭐
第一行输入 h 和 w,第二行输入 x₁ x₂ y₁ y₂,随后 h 行画布内容。
输入数据5 5
1 2 3 4
AbCdE
fGhIk
LmNoP
qRsTu
VwXyZ
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int main() {
int h, w;
scanf("%d %d", &h, &w);
int x1, x2, y1, y2;
scanf("%d %d %d %d", &x1, &x2, &y1, &y2);
// 需要输出多少行
int rows = x2 - x1 + 1;
int len = y2 - y1 + 1; // 每行输出多少列
string line;
for (int i = 1; i <= h; i++) {
cin >> line; // 字符不含空格,直接用 >> 读
if (i >= x1 && i <= x2) {
// 题目第 i 行 → 数组下标 i-1;从第 y1 列起取 len 个
printf("%s\n", line.substr(y1 - 1, len).c_str());
}
}
return 0;
}
🔑为什么可以边读边输出?因为裁剪窗口的行范围是已知的,读到窗口内的行就直接输出,不需要把整个画布存下来。这样连二维数组都省了,代码更短。
📖 关键几行怎么看
代码作用为什么这样写
rows = x2 - x1 + 1输出行数两端都含,所以 +1
len = y2 - y1 + 1每行输出列数同样两端都含
if (i >= x1 && i <= x2)判断是否在窗口内题目下标与循环变量同为 1 基,可直接比较
line.substr(y1 - 1, len)截取列段起点减 1(转 0 基),长度用算好的 len
⚠️三个坑:① 长度写成 y2 - y1,漏掉 +1,会少输出一列;② 起点忘了减 1,会整体右移一列;③ 用 getline 读行时没处理第一行残留的换行符,导致第一行读到空串(本题字符不含空格,直接用 cin >> 最省事)。
写完程序后,用这些数据自查一遍:
输入答案考察点
3 5
2 2 2 4
..... / .>_<. / .....>_<题面样例 1
5 5
1 2 3 4
AbCdE / fGhIk / LmNoP / qRsTu / VwXyZCd
hI题面样例 2
1 1
1 1 1 1
XX单格画布
2 3
1 2 1 3
abc / defabc
def取整个画布
3 3
2 3 2 3
abc / def / ghief
hi取右下角 2 × 2
✅自查清单:① 行数列数都 +1 了吗?② 起点减 1 了吗?③ 输出的行数对吗?
🚨 易错点清单
⚠️长度忘加 1:列数必须是 y2 − y1 + 1,否则每行都会少输出一列。
⚠️起点没减 1:C++ 字符串下标从 0 开始,而题目坐标从 1 开始。
⚠️用 getline 读了空行:cin >> y2 后面残留的换行会被 getline 读走。
时间复杂度
O(h × w)
空间复杂度
O(w)
h, w 最大
100
运算量
10⁴ 字符
时间怎么算的?
读入 h 行,每行 w 个字符
截取窗口内的行,每行 O(w)
合计 O(h × w)
空间都用在哪?
只需保存当前行,不需要存整个画布。
✅ 最多 10⁴ 个字符,任何写法都瞬间完成。
// 1 基下标 → 0 基下标的统一换算
// 题目第 x 行 -> 数组下标 x - 1
// 题目第 y 列 -> 数组下标 y - 1
// 区间 [y1, y2] 长度 = y2 - y1 + 1
// 起点下标 = y1 - 1
s.substr(y1 - 1, y2 - y1 + 1);
// 读入字符串的两种方式
cin >> s; // 不含空格时最简单
getline(cin, s); // 含空格时需要;注意先 cin.ignore() 吃掉换行
// 逐字符输出的等价写法
for (int i = x1; i <= x2; i++) {
for (int j = y1; j <= y2; j++) putchar(ch[i-1][j-1]);
putchar('\n');
}
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
区间截取三要素起点(减 1)、长度(差加 1)所有子串/子矩阵截取题
1 基转 0 基统一减 1所有坐标从 1 开始的题目
边读边处理只要窗口范围已知就能省数组滑动窗口、筛选输出类题目
🌟思考题:如果题目改成"输出裁掉的部分"(即窗口之外的内容),该怎么改?(提示:把 if (i >= x1 && i <= x2) 改成输出"前缀 + 后缀",即 line.substr(0, y1-1) 和 line.substr(y2) 两段。)
3 5 2 2 2 4 ..... .>_<. .....
5 5 1 2 3 4 AbCdE fGhIk LmNoP qRsTu VwXyZ
#include <bits/stdc++.h>
using namespace std;
int main() {
int h, w;
scanf("%d %d", &h, &w);
int x1, x2, y1, y2;
scanf("%d %d %d %d", &x1, &x2, &y1, &y2);
// 需要输出多少行
int rows = x2 - x1 + 1;
int len = y2 - y1 + 1; // 每行输出多少列
string line;
for (int i = 1; i <= h; i++) {
cin >> line; // 字符不含空格,直接用 >> 读
if (i >= x1 && i <= x2) {
// 题目第 i 行 → 数组下标 i-1;从第 y1 列起取 len 个
printf("%s\n", line.substr(y1 - 1, len).c_str());
}
}
return 0;
}// 1 基下标 → 0 基下标的统一换算
// 题目第 x 行 -> 数组下标 x - 1
// 题目第 y 列 -> 数组下标 y - 1
// 区间 [y1, y2] 长度 = y2 - y1 + 1
// 起点下标 = y1 - 1
s.substr(y1 - 1, y2 - y1 + 1);
// 读入字符串的两种方式
cin >> s; // 不含空格时最简单
getline(cin, s); // 含空格时需要;注意先 cin.ignore() 吃掉换行
// 逐字符输出的等价写法
for (int i = x1; i <= x2; i++) {
for (int j = y1; j <= y2; j++) putchar(ch[i-1][j-1]);
putchar('\n');
}每次当她按下任何一个小写英文字母的键的时候,文本编辑器就会在当前编辑文本的末端添加对应的字母。
例如,假设当前文本是 luog,当她按下 u 键时,文本就会变成 luogu。
当她按下退格键的时候,文本编辑器就会删除当前文本的最后一个字母。如果当前文本是空的,则什么都不会发生。
例如,如果当前文本是 luogu,当她按下退格键后,文本就会变成 luog。
现在,给定小苏的按键情况,已知在初始时文本为空,请你求出小苏按完给定的所有键后的文本是什么。
第二行是 n 个用空格隔开的字符串,依次表示小苏按下的每个按键。
输入的每个字符串要么是一个小写字母,表示对应的按键,要么是字符串 <bs>,表示退格键。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 5 a b c d e | abcde |
| 2 | 3 a <bs> b | b |
· 逐字符遍历,注意大小写差 32、字符位移要回绕。
写完后可到洛谷
B3998 对照题解。为了顺利完成工作,小杨制作了一本字典,里面记录了 N 个 A 语言单词对应的 B 语言单词,巧合的是,这些单词都由地球上的 26 个小写英文字母组成。
小杨希望你写一个程序,帮助他根据这本字典翻译一段 A 语言文章。这段文章由标点符号 !()-[]{}\|;:'",./?<> 和一些 A 语言单词构成,每个单词之间必定由至少一个标点符号分割,你的程序需要把这段话中的所有 A 语言单词替换成它的 B 语言翻译。特别地,如果遇到不在字典中的单词,请使用大写 UNK 来替换它。
例如,小杨的字典中包含 2 个 A 语言单词 abc 和 d,它们的 B 语言翻译分别为 a 和 def,那么我们可以把 A 语言文章 abc.d.d.abc.abcd. 翻译成 B 语言文章 a.def.def.a.UNK. 其中,单词 abcd 不在词典内,因此我们需要使用 UNK 来替换它。
接下来 N 行,每行两个用单个空格隔开的字符串 A, B ,分别表示字典中的一个 A 语言单词以及它对应的 B 语言翻译。保证所有 A 不重复;保证 A 和 B 的长度不超过 10。
最后一行一个字符串 S ,表示需要翻译的 A 语言文章。保证字符串 S 的长度不超过 1000,保证字符串 S 只包含小写字母以及标点符号 !()-[]{}\|;:'",./?<> 。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 2 abc a d def abc.d.d.abc.abcd | a.def.def.a.UNK |
| 2 | 3 abc a d def abcd xxxx abc,(d)d!-abc?abcd | a,(def)def!-a?xxxx |
| 3 | 1
abcdefghij klmnopqrst
!()-[]{}\|;:'",./?<>abcdefghijklmnopqrstuvwxyz | !()-[]{}\|;:'",./?<>UNK |
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
文章由标点符号和单词组成,每个单词之间必定由至少一个标点符号分割。
请把文章中的所有 A 语言单词替换成字典中对应的 B 语言翻译;若单词不在字典中,替换成大写的 UNK。标点符号原样保留。
例:字典含 abc → a、d → def,则 abc.d.d.abc.abcd. 翻译为 a.def.def.a.UNK.
💡人话翻译:标点是"分隔符",夹在两个标点之间的连续字母就是一个"完整单词"。关键点:必须完整匹配整个单词——例子里的 abcd 虽然以 abc 开头,但它本身不在字典里,所以要换成 UNK。
🔍 关键词提取
逐字符扫描单词边界查表替换标点保留
已知条件
项目说明
输入第一行 N;随后 N 行每行 A、B 两个单词;最后一行文章 S
输出翻译后的文章(一行)
数据范围N ≤ 100,S 长度 ≤ 1000
字符集S 只含小写字母和标点(不含空格)
单词定义被标点分隔的连续小写字母序列
需要解决的问题
怎么切出单词?逐字符扫描,遇到字母就累积,遇到标点就把累积的单词"结算"掉
怎么判断标点?if (!(c >= 'a' && c <= 'z')) 就是标点(因为字符串只含字母和标点)
怎么处理开头/结尾?扫描完后如果还残留单词,要补一次结算
📥 读入
N 条词典
用 map 存 A→B
读入文章 S
用 getline 或 cin
🔍 扫描
cur 累积当前单词
遇字母 → 追加到 cur
遇标点 → 先结算 cur,再输出该标点
标点原样输出
✅ 结算
cur 为空 → 什么都不做
cur 在字典中 → 输出译文
cur 不在字典中 → 输出 UNK
然后清空 cur
⚠️ 易错点
结尾残留单词未结算
把 abcd 误用 abc 的前缀匹配
标点被吞掉
连续标点处理错误
字典:abc → a、d → def。我们对文章逐字符扫描。
1
第 1 段:abc
读到 a、b、c → cur = "abc"
读到 '.' → 结算 cur:"abc" 在字典中 → 输出 "a",再输出 '.'
cur 清空
已输出 "a."
2
第 2 段:d
读到 d → cur = "d"
读到 '.' → 结算:"d" 在字典中 → 输出 "def",再输出 '.'
已输出 "a.def."
3
第 3 段:d
同上 → 输出 "def."
已输出 "a.def.def."
4
第 4 段:abc
读出 "abc" → 在字典中 → 输出 "a" 和 '.'
已输出 "a.def.def.a."
5
第 5 段:abcd
读出 完整的 "abcd"(四个字母)
查字典:没有 "abcd" 这个条目
⚠️ 注意不能因为"以 abc 开头"就用 abc 的译文
正确做法:输出 "UNK",再输出 '.'
✅ 最终 "a.def.def.a.UNK."
📊 逐段对照表
原文单词是否在字典中译文
abc✅ 在(→ a)a
d✅ 在(→ def)def
d✅ 在(→ def)def
abc✅ 在(→ a)a
abcd❌ 不在UNK
🔑本题最核心的坑:必须"完整匹配整个单词"。很多同学会想"abcd 以 abc 开头,查得到就用 abc 的译文"——这是前缀匹配,本题要求的是完全相等。所以扫描时要把连续的字母全部累积完,遇到标点再整体查表。
🧮 连续标点怎么处理
题目说"每个单词之间至少一个标点",所以可能出现连续多个标点。
原文片段处理过程输出
abc..d结算 abc → a;遇到两个 '.' 都原样输出;再结算 da..def
.abc开头就是 '.',此时 cur 为空 → 只输出 '.';再结算 abc.a
abc.结算 abc → a,输出 '.';扫描结束,cur 已空a.
⚠️注意 cur 为空时不要输出任何东西:遇到标点时如果 cur 是空的,说明这之前已经有标点(或文章开头就是标点),此时只能输出标点本身,不能输出 UNK。否则连续标点会被翻译成一堆 UNK。
🟢 逐字符扫描(推荐) 推荐
用一个游标累积单词,遇标点就结算并输出标点
时间 O(文章长度)
一趟扫描完成
标点自动原样保留
代码 20 行
💡实现结构:for (每个字符 c) { if (是字母) cur += c; else { 结算 cur; 输出 c; } }最后务必再结算一次,处理结尾残留的单词。
🟠 用 stringstream 按标点切分
把标点统一替换成空格,再用流提取单词
需要额外保存标点位置
标点顺序容易错乱
实现更绕
不推荐
⚠️为什么不好:本题要求标点原样保留且位置不变,用流切分会丢掉标点信息,还得另外记住它们在哪儿——不如逐字符扫描直接、可靠。
📈 性能对比
方案代码量标点处理
逐字符扫描约 20 行自然保留
流式切分约 35 行需要额外记录位置
第一行输入词典条目数 N,随后 N 行 A B,最后一行输入文章。
输入数据2
abc a
d def
abc.d.d.abc.abcd.
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int main() {
int n;
scanf("%d", &n);
map<string, string> dict;
for (int i = 0; i < n; i++) {
string a, b;
cin >> a >> b;
dict[a] = b;
}
string s;
cin >> s; // 文章不含空格,可直接读
string cur = "", ans = "";
// 结算当前单词
auto settle = [&]() {
if (cur.empty()) return;
auto it = dict.find(cur);
ans += (it != dict.end() ? it->second : string("UNK"));
cur = "";
};
for (char c : s) {
if (c >= 'a' && c <= 'z') {
cur += c; // 累积单词
} else {
settle(); // 先结算单词
ans += c; // 标点原样输出
}
}
settle(); // 别忘了结尾可能还有单词
printf("%s\n", ans.c_str());
return 0;
}
🔑为什么末尾必须再 settle() 一次?如果文章以单词结尾(例如 abc.d),那么最后那个 d 会被累积到 cur,但后面没有标点来触发结算——循环结束后必须补一次,否则最后一个单词会被丢掉。
📖 关键几行怎么看
代码作用为什么这样写
if (c >= 'a' && c <= 'z')判断字母文章只含字母和标点,非字母即标点
cur += c累积单词把连续字母拼成完整单词
settle(); ans += c;遇标点先结算单词,再输出标点,顺序不能反
dict.find(cur)查字典用 find 判断是否存在,避免误插
⚠️三个坑:① 循环结束忘记 settle(),丢掉末尾单词;② 用前缀匹配(如把 abcd 用 abc 翻译),必须完整相等;③ cur 为空时也输出 UNK,导致连续标点被错误替换。
写完程序后,用这些数据自查一遍:
输入答案考察点
2 / abc a / d def / abc.d.d.abc.abcd.a.def.def.a.UNK.题面样例
1 / a x / ax文章只有一个单词
1 / a x / ..a..x开头连续标点原样保留
1 / a x / a..x..结尾连续标点原样保留
1 / a x / a 且 a.ax.x中间单标点
1 / abc y / abcdUNK完整匹配:abcd 不在字典中
✅自查清单:① 末尾结算了吗?② 用的是完整匹配吗?③ cur 为空时没输出东西吧?
🚨 易错点清单
⚠️循环结束忘记结算:文章以单词结尾时,最后那个单词会丢失。
⚠️前缀匹配:abcd 必须以整个单词去查字典,不能因为以 abc 开头就用 abc 的译文。
⚠️cur 为空时输出 UNK:遇到标点时若 cur 为空,只输出标点本身。
时间复杂度
O(S + 单词数 × log N)
空间复杂度
O(N + S)
S 长度
≤ 1000
N 最大
100
时间怎么算的?
逐字符扫描 O(S)
每个单词查一次 map:O(log N)
单词数不超过 S,所以总复杂度约 O(S log N)
空间都用在哪?
需要存词典(N 条)和结果字符串。
✅ S ≤ 1000,规模极小,任何实现都瞬间完成。这题考的是"单词边界"的处理是否周全。
// 用 lambda 封装"结算"逻辑(C++11 起)
auto settle = [&]() {
if (cur.empty()) return;
auto it = dict.find(cur);
ans += (it != dict.end() ? it->second : string("UNK"));
cur = "";
};
// 判断字符类别
bool isLetter(char c) { return c >= 'a' && c <= 'z'; }
// 若标点集合已知,也可以显式列出
// 本题文章中只有字母和标点,所以"非字母即标点"最省事
// 读入文章:不含空格用 cin >> s;含空格用 getline(cin, s)
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
单词边界遇分隔符才结算文本分词、tokenizer、词法分析
完整匹配用 map/哈希表精确查所有需要精确查找的场景
末尾补结算循环外再处理一次所有"分隔符驱动"的扫描算法
🌟思考题:如果题目改成"标点符号也要翻译"(比如 . 翻译成 。),代码要改哪里?(提示:只需在遇到标点那个分支里,先查一次"标点字典"再输出。这说明当前的骨架——"遇字母累积、遇分隔符结算"——可以很容易地扩展。)
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
scanf("%d", &n);
map<string, string> dict;
for (int i = 0; i < n; i++) {
string a, b;
cin >> a >> b;
dict[a] = b;
}
string s;
cin >> s; // 文章不含空格,可直接读
string cur = "", ans = "";
// 结算当前单词
auto settle = [&]() {
if (cur.empty()) return;
auto it = dict.find(cur);
ans += (it != dict.end() ? it->second : string("UNK"));
cur = "";
};
for (char c : s) {
if (c >= 'a' && c <= 'z') {
cur += c; // 累积单词
} else {
settle(); // 先结算单词
ans += c; // 标点原样输出
}
}
settle(); // 别忘了结尾可能还有单词
printf("%s\n", ans.c_str());
return 0;
}// 用 lambda 封装"结算"逻辑(C++11 起)
auto settle = [&]() {
if (cur.empty()) return;
auto it = dict.find(cur);
ans += (it != dict.end() ? it->second : string("UNK"));
cur = "";
};
// 判断字符类别
bool isLetter(char c) { return c >= 'a' && c <= 'z'; }
// 若标点集合已知,也可以显式列出
// 本题文章中只有字母和标点,所以"非字母即标点"最省事
// 读入文章:不含空格用 cin >> s;含空格用 getline(cin, s)对于两个字符串 A 和 B,如果 A 可以通过删除一个字符,或插入一个字符,或修改一个字符变成 B,那么我们说 A 和 B 是相似的。
比如 \texttt{apple} 可以通过插入一个字符变成 \texttt{applee},可以通过删除一个字符变成 \texttt{appe},也可以通过修改一个字符变成 \texttt{bpple}。因此 \texttt{apple} 和 \texttt{applee}、\texttt{appe}、\texttt{bpple} 都是相似的。但 \texttt{applee} 并不能 通过任意一个操作变成 \texttt{bpple},因此它们并不相似。
特别地,两个完全相同的字符串也是相似的。
给定 T 组 A,B,请你分别判断它们是否相似。
接下来 T 行,每行两个用空格隔开的字符串 A 和 B。
similar,否则输出 not similar`。| # | 输入 | 输出 |
|---|---|---|
| 1 | 5 apple applee apple appe apple bpple applee bpple apple apple | similar similar similar not similar similar |
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
如果 A 能通过删除一个字符、插入一个字符或修改一个字符变成 B,则称 A 和 B 是相似的。两个完全相同的字符串也是相似的。
给定 T 组 A、B,分别判断是否相似。相似输出 similar,否则输出 not similar。
💡人话翻译:这是经典的"编辑距离 ≤ 1"问题。核心思路是按长度差分三种情况讨论:
① 长度差 > 1 → 一定不相似;
② 长度差 = 1 → 看长串删掉一个字符能否变成短串;
③ 长度相等 → 数一数有几个位置不同(≤ 1 才相似)。
🔍 关键词提取
编辑距离分类讨论双指针长度差
已知条件
项目说明
输入第一行 T;随后 T 行每行两个字符串 A、B
输出每行 similar 或 not similar
数据范围T ≤ 100
长度A、B 长度不超过 50,仅含小写字母
允许操作删 1 个、插 1 个、改 1 个(任选其一),或什么都不做
需要解决的问题
三种操作对应什么长度关系?删除让长度 −1、插入让长度 +1、修改让长度不变
怎么统一处理?用双指针从左往右找第一个不同的位置,然后根据长度关系决定"跳过谁的字符"
完全相同怎么办?题目特别说明也属于相似
📏 先看长度差
差 > 1 → 直接 not similar
差 = 0 → 数不同位置
差 = 1 → 短串须是长串删一个
只有这三种情况
🔍 双指针
i、j 从 0 开始同步前进
跳过所有相同字符
停在第一个不同处
统计不同个数或跳过一格
✅ 判定
差 0:不同位置 ≤ 1
差 1:跳过长串一格后余下全同
完全相同:similar
任一不满足 → not similar
⚠️ 易错点
忘了"完全相同也相似"
只看长度不看内容
差 1 时跳错串
多个不同位置只跳一次
样例答案:similar / similar / similar / not similar / similar。
1
第 1 组:apple 与 applee
长度:5 与 6,差为 1 → 属于"插入/删除"情况
短的是 apple,长的是 applee
检查:长串 applee 删掉最后一个 e → apple ✅
(也可以用双指针:前 5 个字符全同,长串多出 1 个字符)
✅ similar
2
第 2 组:apple 与 appe
长度:5 与 4,差为 1
长串 apple 删掉 'l' → appe ✅
✅ similar
3
第 3 组:apple 与 bpple
长度都是 5,差为 0 → 属于"修改"情况
逐位比较:a/b 不同,其余 p、p、l、e 全同
只有 1 个位置不同 → 修改 1 个字符即可 ✅
✅ similar
4
第 4 组:applee 与 bpple
长度:6 与 5,差为 1 → "插入/删除"情况
短串 bpple,长串 applee
检查长串删一个字符能否变短串:
删 a → pplee ✗;删第一个 p → aplee ✗;删第二个 p → aplee ✗
删 l → appe e→ appee ✗;删 e → apple ✗;删最后的 e → apple ✗
没有任何一种删除能得到 bpple ✗
❌ not similar
5
第 5 组:apple 与 apple
完全相同 → 题目特别说明也属于相似
✅ similar
📊 判定规则速查
长度关系对应操作判定方法
差 > 1不可能直接 not similar
差 = 0修改(或不变)不同位置个数 ≤ 1
差 = 1插入 / 删除长串删一格后余下与短串完全相同
🔑第 4 组为什么失败?因为长度差虽然是 1,但差别不只是"多一个字符"——开头 a 和 b 就完全不同。所以判定"长度差 = 1"时,还要验证去掉那一个字符后,剩下的部分逐位相同,不能只靠长度差下结论。
🧮 双指针的统一处理法
用双指针可以把三种情况写得很统一,我们看它的原理。
1
指针同步前进
i、j 分别指向 A、B 的开头
只要 A[i] == B[j] 就让两个指针都前进
停下来时,i、j 就指向第一个不同的位置
定位到第一个差异点
2
根据长度差决定"跳过谁"
长度相等:两边都跳过这一格,继续比较剩余部分
A 更长:只让 i 前进一格(相当于在 A 里删掉这个字符)
B 更长:只让 j 前进一格
统一成"跳过一格后必须完全一致"
3
特殊情况
如果一路比到最后都没遇到不同:
长度相等 → 完全相同 → similar
长度差 1 → 长串末尾多一个 → similar
长度差 > 1 → not similar
✅ 所有情况都覆盖了
双指针写法只有 15 行左右,且不易漏情况
🟢 双指针统一处理(推荐) 推荐
找第一个不同位置,再按长度关系跳一格后验证
时间 O(|A| + |B|)
代码 15 行
三种情况合并处理
不易漏边界
💡实现要点:先各自跳过相同前缀,然后"按长度差跳一格"(相等时两边都跳),最后检查剩余部分是否完全相同。
🟠 分三种情况分别写
if 长度差 > 1 / == 0 / == 1 各写一段逻辑
代码更长(约 40 行)
每段都要单独处理边界
三种情况容易漏
但思路更贴近题面
⚠️两种都能过:本题长度 ≤ 50、T ≤ 100,规模极小。分类讨论的写法更好理解,双指针的写法更简洁——建议两种都掌握,考场上选顺手的。
📈 性能对比
方案代码量覆盖情况
双指针约 15 行统一处理
分类讨论约 40 行三段各管一类
每行输入两个字符串(空格分隔),程序会判断它们是否"编辑距离 ≤ 1"。
输入(每行一组 A B)apple applee
apple appe
apple bpple
applee bpple
apple apple
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
bool similar(const string &a, const string &b) {
int la = a.size(), lb = b.size();
// 长度差超过 1,任何单次操作都做不到
if (abs(la - lb) > 1) return false;
// 双指针跳过相同的前缀
int i = 0, j = 0;
while (i < la && j < lb && a[i] == b[j]) { i++; j++; }
// 一路相同到底
if (i == la && j == lb) return true; // 完全相同
if (la == lb) {
// 长度相等:两边各跳过一个字符,再比较剩余部分
return a.substr(i + 1) == b.substr(j + 1);
} else if (la > lb) {
// A 更长:在 A 中删掉当前这个字符
return a.substr(i + 1) == b.substr(j);
} else {
// B 更长:在 B 中删掉当前这个字符
return a.substr(i) == b.substr(j + 1);
}
}
int main() {
int T;
scanf("%d", &T);
while (T--) {
string a, b;
cin >> a >> b;
printf("%s\n", similar(a, b) ? "similar" : "not similar");
}
return 0;
}
🔑为什么用 substr 比继续移动指针更简单?因为我们只需要验证"跳过一个字符之后,剩余部分是否完全相同"。substr(i+1) 直接取出后缀,用 == 一次比较完——比自己写循环比较更短、更不容易出错。
📖 关键几行怎么看
代码作用为什么这样写
if (abs(la - lb) > 1) return false;长度粗判一次操作最多改变 1 个字符长度
while (i < la && j < lb && a[i] == b[j])跳过相同前缀定位到第一个不同位置
if (i == la && j == lb) return true;完全相同题目说明这种情况也属于相似
a.substr(i + 1) == b.substr(j + 1)长度相等时验证各跳一格后剩余必须完全一致
⚠️三个坑:① 忘了"完全相同也算相似"(会漏掉最后一组样例);② 长度差 = 1 时不验证剩余部分,只看长度就判 similar(第 4 组样例会错);③ 长度相等时只跳一边的字符(应该两边都跳)。
写完程序后,用这些数据自查一遍:
输入答案考察点
apple appleesimilar长度差 1,插入/删除即可
apple appesimilar长度差 1,删掉 l
apple bpplesimilar同长度,只差 1 个字符
applee bpplenot similar题面样例:长度差 1 但内容差异不止一个字符
apple applesimilar完全相同也相似
a bsimilar长度相等且都只差 1 个字符
ab abcdenot similar长度差 3 > 1
✅自查清单:① 长度差 > 1 直接返回了吗?② 完全相同的情况处理了吗?③ 长度相等时两边都跳了吗?
🚨 易错点清单
⚠️忘记"完全相同":题目明确说"两个完全相同的字符串也是相似的"。
⚠️只判长度差不验证内容:长度差为 1 还必须验证"删掉一个字符后剩余完全相同"。
⚠️长度相等时跳错边:应该两边各跳一格,然后比较剩余部分。
时间复杂度
O(|A| + |B|)
空间复杂度
O(|A| + |B|)
长度最大
50
T 最大
100
时间怎么算的?
双指针扫一遍两个字符串 O(|A| + |B|)
末尾的 substr 比较也是线性
每组 O(50),总共 100 组也才几千次操作
空间都用在哪?
substr 会产生临时字符串,但长度极小。
✅ 规模极小,任何写法都瞬间完成。这题考的是"分类是否想全",不是效率。
// "编辑距离 <= 1" 的三种等价描述
// 1) 能通过删除/插入/修改 一个字符变成对方
// 2) 长度差 <= 1 且最多有一处"错位"
// 3) 最长公共前缀 + 最长公共后缀 覆盖了较短的整个串
// 用前缀/后缀描述(另一角度,也很好写)
bool similar2(const string &a, const string &b) {
int la = a.size(), lb = b.size();
if (abs(la - lb) > 1) return false;
// 最长公共前缀
int pre = 0;
while (pre < la && pre < lb && a[pre] == b[pre]) pre++;
// 最长公共后缀
int suf = 0;
while (suf < la - pre && suf < lb - pre
&& a[la - 1 - suf] == b[lb - 1 - suf]) suf++;
// 中间剩下的差异长度必须 <= 1(长度相等时 <= 2,对应修改一个字符)
int midA = la - pre - suf, midB = lb - pre - suf;
return midA <= 1 && midB <= 1;
}
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
编辑距离最少操作次数拼写纠错、模糊匹配、DNA 比对
分类讨论按长度差分支所有"最多改一处"的判定题
最长公共前缀/后缀前后夹逼描述差异字符串相似度、diff 算法
🌟思考题:如果题目把"一个字符"放宽到"k 个字符",该怎么改?(提示:这就不再是简单的分类讨论了,需要用动态规划求编辑距离(Levenshtein 距离),状态 dp[i][j] 表示 A 的前 i 个字符变成 B 的前 j 个字符所需的最少操作数,最终判断 dp[|A|][|B|] ≤ k。本题是 k = 1 的特例,所以可以走捷径。)
#include <bits/stdc++.h>
using namespace std;
bool similar(const string &a, const string &b) {
int la = a.size(), lb = b.size();
// 长度差超过 1,任何单次操作都做不到
if (abs(la - lb) > 1) return false;
// 双指针跳过相同的前缀
int i = 0, j = 0;
while (i < la && j < lb && a[i] == b[j]) { i++; j++; }
// 一路相同到底
if (i == la && j == lb) return true; // 完全相同
if (la == lb) {
// 长度相等:两边各跳过一个字符,再比较剩余部分
return a.substr(i + 1) == b.substr(j + 1);
} else if (la > lb) {
// A 更长:在 A 中删掉当前这个字符
return a.substr(i + 1) == b.substr(j);
} else {
// B 更长:在 B 中删掉当前这个字符
return a.substr(i) == b.substr(j + 1);
}
}
int main() {
int T;
scanf("%d", &T);
while (T--) {
string a, b;
cin >> a >> b;
printf("%s\n", similar(a, b) ? "similar" : "not similar");
}
return 0;
}// "编辑距离 <= 1" 的三种等价描述
// 1) 能通过删除/插入/修改 一个字符变成对方
// 2) 长度差 <= 1 且最多有一处"错位"
// 3) 最长公共前缀 + 最长公共后缀 覆盖了较短的整个串
// 用前缀/后缀描述(另一角度,也很好写)
bool similar2(const string &a, const string &b) {
int la = a.size(), lb = b.size();
if (abs(la - lb) > 1) return false;
// 最长公共前缀
int pre = 0;
while (pre < la && pre < lb && a[pre] == b[pre]) pre++;
// 最长公共后缀
int suf = 0;
while (suf < la - pre && suf < lb - pre
&& a[la - 1 - suf] == b[lb - 1 - suf]) suf++;
// 中间剩下的差异长度必须 <= 1(长度相等时 <= 2,对应修改一个字符)
int midA = la - pre - suf, midB = lb - pre - suf;
return midA <= 1 && midB <= 1;
}0-255、十六进制 00-FF)。这样的像素组成的图像,称为 256 级灰阶的灰度图像。现在希望将 256 级灰阶的灰度图像压缩为 16 级灰阶,即每个像素的取值范围为十进制 0-15、十六进制 0-F。压缩规则为:统计出每种灰阶的数量,取数量最多的前 16 种灰阶(如某种灰阶的数量与另外一种灰阶的数量相同,则以灰阶值从小到大为序),分别编号 0-F(最多的编号为 0,以此类推)。其他灰阶转换到最近的 16 种灰阶之一,将某个点的灰阶值(灰度,而非次数)与 16 种灰阶中的一种相减,绝对值最小即为最近,如果绝对值相等,则编号较小的灰阶更近。
第 2 行开始的 n 行,每行为长度相等且为偶数的字符串,每两个字符用十六进制表示一个像素。约定输入的灰度图像至少有 16 种灰阶。约定每行最多 20 个像素。
第二行开始的 n 行,输出压缩后的图像,每个像素一位十六进制数表示压缩后的灰阶值。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 10 00FFCFAB00FFAC09071B5CCFAB76 00AFCBAB11FFAB09981D34CFAF56 01BFCEAB00FFAC0907F25FCFBA65 10FBCBAB11FFAB09981DF4CFCA67 00FFCBFB00FFAC0907A25CCFFC76 00FFCBAB1CFFCB09FC1AC4CFCF67 01FCCBAB00FFAC0F071A54CFBA65 10EFCBAB11FFAB09981B34CFCF67 01FFCBAB00FFAC0F071054CFAC76 1000CBAB11FFAB0A981B84CFCF66 | ABCFFF00CB09AC07101198011B6776FC 321032657CD10E 36409205ACC16D B41032657FD16D 8F409205ACF14D 324F326570D1FE 3240C245FC411D BF4032687CD16D 8F409205ACC11D B240326878D16E 83409205ACE11D |
灰阶 AB、CF 和 FF 出现 14 次,00 出现 10 次,CB 出现
9 次,09 出现 7 次,AC 出现 6 次,07 出现 5 次,10、11
和 98 出现 4 次,01、1B、67、76 和 FC 出现 3 次。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
256 级灰阶图像中,每个像素取值为 00 ~ FF(0 ~ 255)。现要压缩为 16 级(0 ~ 15)。规则:
统计每种灰阶出现的数量,取数量最多的前 16 种(数量相同时,灰阶值小的优先)
这 16 种灰阶分别编号 0 ~ F,最多的编号为 0,依次类推
其他灰阶转换到最近的那 16 种之一(灰阶值之差的绝对值最小;若相同则取编号较小的那一种)
输出第一行为 16 种选定灰阶的十六进制编码(共 32 个字符);之后 n 行输出压缩后的图像,每个像素用一位十六进制表示。
💡人话翻译:分三步走:① 统计频次 → ② 按规则选出 16 种代表灰阶并编号 → ③ 把每个像素映射到最近的编号。最容易错的是第二步的排序规则(次数降序,次数相同则灰阶值升序)和第三步的并列取小。
🔍 关键词提取
频次统计多关键字排序最近邻映射十六进制格式化
已知条件
项目说明
输入第一行 n(10 ~ 20);随后 n 行等长偶数字符串,每 2 字符一个像素
输出第一行 32 个十六进制字符;随后 n 行每个像素一位十六进制
数据范围10 ≤ n ≤ 20,每行最多 20 个像素
保证输入至少含 16 种不同灰阶
灰阶值0 ~ 255(十六进制 00 ~ FF)
需要解决的问题
怎么统计频次?开一个长度 256 的计数数组即可
怎么选前 16 种?按 (次数降序, 灰阶值升序) 排序,取前 16
怎么映射?对每个灰阶值 v,在 16 种里找 |v − g| 最小的;并列时取编号小的(即先出现的那一种)
📊 统计
开 count[256] 数组
每读一个像素计数加 1
按十六进制解析
共 n × 每行像素数
🔝 选前16
按 (次数降序, 灰阶升序) 排序
取前 16 种
依次编号 0~F
记录它们的灰阶值
🔁 映射
对每个像素值 v
在 16 种里找 |v−g| 最小
并列取编号小的
输出对应编号的十六进制
⚠️ 易错点
并列规则搞反
第一行要 32 字符(含补 0)
像素解析按两位十六进制
输出每像素一位
假设图像只有 5 种灰阶(真实题目至少 16 种,这里只为演示流程):
第 1 步:统计频次
灰阶值出现次数
0x105 次
0x203 次
0x303 次
0x401 次
0x501 次
第 2 步:按 (次数降序, 灰阶值升序) 排序
排序后灰阶值次数编号
第 1 位0x1050
第 2 位0x2031
第 3 位0x3032
第 4 位0x4013
第 5 位0x5014
第 3 步:映射
原灰阶与各代表的最短距离映射到编号
0x10与 0x10 距离 00
0x20与 0x20 距离 01
0x28与 0x20 差 8、与 0x30 差 8 → 并列取编号小的1
0x48与 0x40 差 8、与 0x50 差 8 → 并列取编号小的3
🔑两个关键规则必须记清:① 选前 16 种时,若次数相同,灰阶值小的排前面(对应编号更小);② 映射时若距离并列,取编号小的那一种。因为代表灰阶本身是按"次数降序"排的,"编号小的"通常也是"出现得更多的",这样映射更合理。
🧮 输出格式要看清
输出的第一行是 32 个字符,把这 16 种灰阶的十六进制依次写出、中间不加空格。
格式正确写法错误写法
第一行10203040...(32 字符连写)10 20 30 40(有空格)
压缩后的像素每个像素一位十六进制,如 A写成两位如 0A
⚠️为什么第一行要补 0?因为灰阶值最小可能是 0x00,如果不补 0,输出会变成 0 一位,导致总长度不是 32,格式判错。所以必须用 %02X 保证每项两位。
🟢 枚举 16 种求最近(推荐) 推荐
对每个像素,在 16 个代表灰阶里线性找最近的
时间 O(n × 像素 × 16)
每行最多 20 像素、n ≤ 20
总共约 6400 次比较
代码 10 行
💡为什么够用:图像最多个 20 × 20 = 400 个像素,每个只在 16 个候选里比一遍,总运算量不到 1 万次,完全没必要优化。
🟠 预处理映射表
预先算好 256 个灰阶值各自的映射编号,之后 O(1) 查询
预处理 O(256 × 16)
查询 O(1)
代码稍长
对本题是过度设计
⚠️什么时候值得:如果像素数量极大(比如 1000 × 1000 = 10⁶),预处理映射表能把每次查询降到 O(1),能省下约 15 倍的常数。本题规模小,直接算即可。
📈 性能对比
方案本题运算量代码量
枚举 16 种约 6400 次约 10 行
预处理映射表约 4000 + 400 次约 18 行
输入若干灰阶值(0~255,空格分隔),程序会选出 16 种代表灰阶并给出映射表。
输入灰阶值(十进制)
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int cntv[256]; // 各灰阶出现次数
int main() {
int n;
scanf("%d", &n);
vector<string> img(n);
for (int i = 0; i < n; i++) {
cin >> img[i];
// 每 2 个字符是一个像素(十六进制)
for (size_t j = 0; j + 1 < img[i].size(); j += 2) {
int v = stoi(img[i].substr(j, 2), nullptr, 16);
cntv[v]++;
}
}
// 收集出现过的灰阶,按 (次数降序, 灰阶值升序) 排序
vector<int> vals;
for (int v = 0; v < 256; v++) if (cntv[v] > 0) vals.push_back(v);
sort(vals.begin(), vals.end(), [](int a, int b) {
if (cntv[a] != cntv[b]) return cntv[a] > cntv[b];
return a < b;
});
// 取前 16 种作为代表
vector<int> rep(vals.begin(), vals.begin() + 16);
// 第一行:32 个十六进制字符
for (int k = 0; k < 16; k++) printf("%02X", rep[k]);
printf("\n");
// 输出压缩后的图像
for (int i = 0; i < n; i++) {
for (size_t j = 0; j + 1 < img[i].size(); j += 2) {
int v = stoi(img[i].substr(j, 2), nullptr, 16);
// 在 16 种代表里找距离最小的;并列时保留更小的编号
int bestK = 0, bestD = INT_MAX;
for (int k = 0; k < 16; k++) {
int d = abs(v - rep[k]);
if (d < bestD) { bestD = d; bestK = k; } // 严格小于 -> 并列取小编号
}
printf("%X", bestK);
}
printf("\n");
}
return 0;
}
🔑为什么用 d < bestD 而不是 d <= bestD?题目要求"绝对差相同时,编号较小的更近"。用严格小于更新时,只有"更近"才会替换当前答案——遇到相同距离时保留原来的(也就是编号更小的),恰好符合题意。这类"并列取最优"的题都用这个技巧。
📖 关键几行怎么看
代码作用为什么这样写
stoi(s.substr(j,2), nullptr, 16)解析十六进制像素每 2 个字符一个像素
排序 lambda选前 16 种次数降序、灰阶值升序
printf("%02X", rep[k])第一行%02X 保证两位,总长恰好 32
if (d < bestD)最近邻严格小于 → 并列自动取小编号
⚠️三个坑:① 第一行漏掉补 0(比如灰阶 5 输出成 "5" 而不是 "05");② 排序时次数相同的没有按灰阶值升序;③ 压缩后的像素输出成两位(应该一位)。
写完程序后,用这些数据自查一遍:
输入答案考察点
16 个不同灰阶各出现 1 次按灰阶值升序取前 16 种次数全相同 → 灰阶值小的优先
某灰阶出现次数最多该灰阶编号为 0次数最多者编号 0
距离并列的灰阶映射到编号较小的那一种第 0 种 0x10、第 1 种 0x20,则 0x18 映射到 0
第一行长度必须是 32 个字符每项两位十六进制
压缩后像素每个像素一位十六进制如编号 10 输出 A
✅自查清单:① 排序键对了吗?② 第一行是 32 字符吗?③ 并列取小编号了吗?
🚨 易错点清单
⚠️并列规则搞反:题目要求并列时取编号较小的,用严格小于更新即可自动满足。
⚠️第一行长度不对:必须每项两位(%02X),总长恰好 32。
⚠️像素解析方式错:输入每 2 个字符是一个像素(十六进制),不是每 1 个字符。
时间复杂度
O(n × 像素 × 16)
空间复杂度
O(1)
n 最大
20
像素总数
≤ 400
时间怎么算的?
统计频次:O(像素总数)
排序 0 ~ 255:O(256 log 256)
映射:每个像素在 16 种里找最近
合计不到 1 万次运算
空间都用在哪?
一个 256 长度的计数数组和若干小数组。
✅ 规模极小,任何实现都瞬间完成。这题的难点在于把三条规则都实现正确,而不是效率。
// 十六进制解析与输出
int v = stoi("AF", nullptr, 16); // 175
printf("%02X", 175); // "AF"(两位大写)
printf("%X", 10); // "A"(一位)
// 多关键字排序(次数降序,值升序)
sort(vals.begin(), vals.end(), [](int a, int b) {
if (cntv[a] != cntv[b]) return cntv[a] > cntv[b];
return a < b;
});
// 并列取最优(保留最先遇到的)
int best = 0, bestD = INT_MAX;
for (int k = 0; k < 16; k++) {
int d = abs(v - rep[k]);
if (d < bestD) { bestD = d; best = k; } // 严格小于
}
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
多关键字排序主键降序、次键升序排行榜、Top-K 统计
并列取最优严格小于更新最近邻、最小值多个并列的题目
十六进制格式化%02X / %X所有需要固定/可变宽度十六进制输出的题
🌟思考题:如果量化规则改成"按区间均分"(即 0~15 映射到 0、16~31 映射到 1,以此类推),压缩会有什么不同?(提示:等分量化不依赖图像内容,实现简单但效果差——如果图像大部分像素集中在某个窄区间(比如 100~120),等分量化会把这些像素压到同一级,丢失大量细节。本题的"按频次选代表"正是自适应量化的关键思想。)
#include <bits/stdc++.h>
using namespace std;
int cntv[256]; // 各灰阶出现次数
int main() {
int n;
scanf("%d", &n);
vector<string> img(n);
for (int i = 0; i < n; i++) {
cin >> img[i];
// 每 2 个字符是一个像素(十六进制)
for (size_t j = 0; j + 1 < img[i].size(); j += 2) {
int v = stoi(img[i].substr(j, 2), nullptr, 16);
cntv[v]++;
}
}
// 收集出现过的灰阶,按 (次数降序, 灰阶值升序) 排序
vector<int> vals;
for (int v = 0; v < 256; v++) if (cntv[v] > 0) vals.push_back(v);
sort(vals.begin(), vals.end(), [](int a, int b) {
if (cntv[a] != cntv[b]) return cntv[a] > cntv[b];
return a < b;
});
// 取前 16 种作为代表
vector<int> rep(vals.begin(), vals.begin() + 16);
// 第一行:32 个十六进制字符
for (int k = 0; k < 16; k++) printf("%02X", rep[k]);
printf("\n");
// 输出压缩后的图像
for (int i = 0; i < n; i++) {
for (size_t j = 0; j + 1 < img[i].size(); j += 2) {
int v = stoi(img[i].substr(j, 2), nullptr, 16);
// 在 16 种代表里找距离最小的;并列时保留更小的编号
int bestK = 0, bestD = INT_MAX;
for (int k = 0; k < 16; k++) {
int d = abs(v - rep[k]);
if (d < bestD) { bestD = d; bestK = k; } // 严格小于 -> 并列取小编号
}
printf("%X", bestK);
}
printf("\n");
}
return 0;
}// 十六进制解析与输出
int v = stoi("AF", nullptr, 16); // 175
printf("%02X", 175); // "AF"(两位大写)
printf("%X", 10); // "A"(一位)
// 多关键字排序(次数降序,值升序)
sort(vals.begin(), vals.end(), [](int a, int b) {
if (cntv[a] != cntv[b]) return cntv[a] > cntv[b];
return a < b;
});
// 并列取最优(保留最先遇到的)
int best = 0, bestD = INT_MAX;
for (int k = 0; k < 16; k++) {
int d = abs(v - rep[k]);
if (d < bestD) { bestD = d; best = k; } // 严格小于
}②编程打卡 · 点一下就能勾选
- 完成 B4360《画布裁剪》,跑通全部样例
- 完成 B3998《小苏的键盘》,跑通全部样例
- 完成 B3927《小杨的字典》,跑通全部样例
- 完成 B3958《相似字符串》,跑通全部样例
- 完成 B3851《图像压缩》,跑通全部样例
- 对比题解里的参考代码,找出自己写法的差异
排序与比较
①本日知识点 · 排序与比较
cmp 返回 true 表示「a 排前面」;多关键字先判不等再比次。
本组 9 道题全部来自 GESP 真题,按「排序与比较」归在一起练。题面取洛谷原题(含公式与样例),题解取美力程 GESP 题解库(思路 + 参考代码 + 复杂度)。
你的马匹的速度分别为 u_1,u_2,…,u_n,田忌的马匹的速度分别为 v_1,v_2,…,v_n。田忌会按顺序派出他的马匹,请问你要如何排兵布阵,才能赢得最多轮次的比赛?巧合的是,你和田忌的所有马匹的速度两两不同,因此不可能出现平局。
接下来一行 N 个用空格隔开的整数,依次为 u_1,u_2,…,u_n,表示你的马匹们的速度。保证 1≤ u_i≤ 2N。
接下来一行 N 个用空格隔开的整数,依次为 v_1,v_2,…,v_n,表示田忌的马匹们的速度。保证 1≤ v_i≤ 2N。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 3 1 3 5 2 4 6 | 2 |
| 2 | 5 10 3 5 8 7 4 6 1 2 9 | 5 |
第 1 轮,田忌派出速度为 2 的马匹,你可以派出速度为 3 的马匹迎战,本轮你获胜。
第 2 轮,田忌派出速度为 4 的马匹,你可以派出速度为 5 的马匹迎战,本轮你获胜。
第 3 轮,田忌派出速度为 6 的马匹,你可以派出速度为 1 的马匹迎战,本轮田忌获胜。
如此,你可以赢得 2 轮比赛。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
你和田忌各有 N 匹马,进行 N 轮比赛,每轮各出一匹决胜负。你的马速度是 u₁…u_N,田忌的马速度是 v₁…v_N。田忌会按给定顺序出马,而你可以自由安排自己马匹的出场顺序。
所有马的速度两两不同,不会出现平局。求最多能赢几轮。
💡人话翻译:虽然题目强调"田忌按顺序出马",但你可以自由安排自己的出场顺序,所以顺序其实不重要——本质是"最多能凑出多少对 (你的马, 对手的马) 使得你的更快",也就是一个最大匹配问题。经典解法:双方都排序,然后用双指针贪心。
🔍 关键词提取
贪心双指针最大匹配排序
已知条件
项目说明
输入第一行 N;第二行你的 N 匹马速度;第三行田忌的 N 匹马速度
输出最多获胜轮数
数据范围1 ≤ N ≤ 5 × 10⁴
速度范围1 ≤ uᵢ, vᵢ ≤ 2N
关键前提所有速度两两不同(保证无平局)
需要解决的问题
出场顺序重要吗?不重要——因为我们可以自由安排,只关心"能不能赢"
贪心策略是什么?把双方都升序排序。用指针 i 扫自己的马、j 扫对手的马:若 u[i] > v[j] 就赢一轮(i、j 都前进);否则这匹马赢不了任何对手,直接放弃(i 前进)
为什么"赢不了就放弃"是对的?因为 v[j] 是当前对手最慢的马,连它都赢不了,说明这匹马打不过任何对手
📥 读入
N ≤ 5 × 10⁴
你的马 u[]
对手的马 v[]
速度两两不同
🔢 排序
u 升序
v 升序
排序后贪心才有效
O(N log N)
🎯 双指针
i 扫自己的马,j 扫对手
u[i] > v[j] → 赢,i、j 都加 1
否则 i 加 1(放弃这匹马)
赢不了最慢的必然全输
⚠️ 易错点
忘记排序
比较写成 ≥(速度不同无需考虑)
指针越界
误以为要考虑田忌的出马顺序
双方排序后(本来就有序)开始双指针。
步骤i(你的马)j(对手的马)比较结果已赢轮数
初始u[0] = 1v[0] = 21 > 2?否放弃 1,i 右移0
第 1 次u[1] = 3v[0] = 23 > 2?是赢!i、j 都右移1
第 2 次u[2] = 5v[1] = 45 > 4?是赢!i、j 都右移2
第 3 次i 越界——结束2
1
为什么放弃速度 1 的马?
对手最慢的马速度是 2
我们的 1 连它都跑不过,说明打不过任何对手
所以直接放弃,不浪费和它对位的机会
❌ 放弃
2
配对结果
3 对 2 → 赢;5 对 4 → 赢;1 对 6 → 输
共赢 2 轮,与题面解释一致
✅ 答案 2
最多赢 2 轮 ✓
🧮 样例 2:答案 5(全胜)
你的马:10 3 5 8 7 → 排序后 3 5 7 8 10
对手的马:4 6 1 2 9 → 排序后 1 2 4 6 9
步骤你的马对手的马比较结果已赢轮数
1313 > 1 ✅赢1
2525 > 2 ✅赢2
3747 > 4 ✅赢3
4868 > 6 ✅赢4
510910 > 9 ✅赢5
五轮全胜 ✓
🔑注意"排序后逐位比较"就够了:把双方升序排好后,只要我们的第 k 小马比对手的第 k 小马快,就能一路对位获胜。双指针的写法本质上就是在做这件事——用我们的"最小能赢的马"去击败对手的"最慢的马",把强的马留到后面。
🟢 排序 + 双指针(推荐) 推荐
双方升序排序,用两个指针扫一遍统计胜利数
时间 O(N log N)
N = 5 × 10⁴ 轻松通过
代码 8 行
不需要建图
💡核心代码:for (i = 0, j = 0; i < N && j < N; ) if (u[i] > v[j]) { win++; i++; j++; } else i++;——只有一行循环体。
🟠 二分图最大匹配
把每匹你的马能赢的对手马连边,求最大匹配
时间 O(N × E) 或更复杂
N = 5 × 10⁴ 时不可行
严重超时
完全没必要
⚠️为什么不用:这个问题有一个很好的结构——胜负关系满足"传递性"(若 A 能赢 B,B 能赢 C,则 A 能赢 C),所以贪心最优,不需要通用匹配算法。
📈 性能对比
方案时间复杂度N = 5 × 10⁴ 时
排序 + 双指针O(N log N)约 8 × 10⁵(可行)
二分图匹配O(N × E)约 10⁹ 以上(超时)
第一行输入你的马(空格分隔),第二行输入田忌的马。程序会给出最优配对阵。
输入数据1 3 5
2 4 6
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int u[50005], v[50005];
int main() {
int n;
scanf("%d", &n);
for (int i = 0; i < n; i++) scanf("%d", &u[i]);
for (int i = 0; i < n; i++) scanf("%d", &v[i]);
sort(u, u + n); // 双方升序排序
sort(v, v + n);
int i = 0, j = 0, win = 0;
while (i < n && j < n) {
if (u[i] > v[j]) { // 能赢对手最慢的马
win++;
i++;
j++; // 两匹马都用掉了
} else {
i++; // 连最慢的都赢不了,这匹马放弃
}
}
printf("%d\n", win);
return 0;
}
🔑贪心的正确性怎么理解?对手最慢的马 v[j] 迟早要有人去对位。如果我们有一匹马能赢它,用"刚好能赢它的那匹"(即当前最小的能赢它的马)去对位最划算,因为更强的马可以用来对付对手更强的马。如果连最小的都不能赢它,那这匹马赢不了任何对手,直接放弃即可。
📖 关键几行怎么看
代码作用为什么这样写
sort(u, u + n); sort(v, v + n);双方排序排序后才能用双指针贪心
if (u[i] > v[j])判断能否获胜速度两两不同,不会相等,用 > 即可
win++; i++; j++;赢一轮两匹马都消耗掉了
else i++;放弃当前马连对手最慢的都赢不了,留着也没用
⚠️三个坑:① 忘记排序(双指针贪心必须建立在有序基础上);② 把放弃的分支写成 j++(应该是 i++,因为我们放弃的是自己的马);③ 误以为要考虑田忌的出马顺序(因为我们可以自由排自己的马,顺序不影响答案)。
写完程序后,用这些数据自查一遍:
输入答案考察点
3
1 3 5
2 4 62题面样例 1
5
10 3 5 8 7
4 6 1 2 95题面样例 2(全胜)
1
5
31一匹马,赢了
1
3
50一匹马,输了
3
1 2 3
4 5 60全部弱于对手,一场都赢不了
4
10 20 30 40
1 2 3 44全面强于对手,全胜
✅自查清单:① 双方都排序了吗?② 放弃时移动的是 i 吗?③ 循环条件是 i、j 都未越界吗?
🚨 易错点清单
⚠️忘记排序:不排序就双指针会得到错误答案。
⚠️放弃时写成 j++:放弃的应该是自己的马(i++),因为对手那匹马还要留给后面的强马去对位。
⚠️以为要考虑田忌的顺序:题目允许我们自由安排出场,所以顺序无关,只需求最大获胜匹配数。
时间复杂度
O(N log N)
空间复杂度
O(N)
N 最大
5 × 10⁴
运算量
约 8 × 10⁵
时间怎么算的?
排序两个数组:O(N log N)
双指针扫描:O(N)
合计 O(N log N),N = 5 × 10⁴ 时约 80 万次操作
空间都用在哪?
需要存两个数组。
✅ 80 万次操作,瞬间完成。如果硬套二分图匹配,会超时——识别问题的特殊结构很重要。
// 双指针贪心的通用模板(两个有序序列找最大匹配)
sort(a, a + n); sort(b, a + n);
int i = 0, j = 0, cnt = 0;
while (i < n && j < m) {
if (a[i] > b[j]) { cnt++; i++; j++; } // 匹配成功
else i++; // 当前 a[i] 太小,放弃
}
// 变体 1:若要"最多平局或胜利",把 > 改为 >=
// 变体 2:若要"最小化损失",可用类似思路反向扫描
// 另一经典写法(从大到小对位)
// 用最大的马打对手最大的马:能赢就赢,不能赢就用自己的最弱马去"送"
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
双指针贪心两个有序序列配对赛马、任务分配、区间匹配
识别特殊结构胜负关系有传递性 → 贪心最优避免不必要的通用算法
最大匹配二分图通用解法一般图/二分图匹配问题
🌟思考题:如果题目改成"求最小可能的获胜轮数"(即最差情况下你只能赢几场),该怎么算?(提示:这等价于"求对手的最大获胜匹配",把角色互换、用同样的双指针算法算出对手最多赢多少,再用 N 减去它即可。)
#include <bits/stdc++.h>
using namespace std;
int u[50005], v[50005];
int main() {
int n;
scanf("%d", &n);
for (int i = 0; i < n; i++) scanf("%d", &u[i]);
for (int i = 0; i < n; i++) scanf("%d", &v[i]);
sort(u, u + n); // 双方升序排序
sort(v, v + n);
int i = 0, j = 0, win = 0;
while (i < n && j < n) {
if (u[i] > v[j]) { // 能赢对手最慢的马
win++;
i++;
j++; // 两匹马都用掉了
} else {
i++; // 连最慢的都赢不了,这匹马放弃
}
}
printf("%d\n", win);
return 0;
}// 双指针贪心的通用模板(两个有序序列找最大匹配)
sort(a, a + n); sort(b, a + n);
int i = 0, j = 0, cnt = 0;
while (i < n && j < m) {
if (a[i] > b[j]) { cnt++; i++; j++; } // 匹配成功
else i++; // 当前 a[i] 太小,放弃
}
// 变体 1:若要"最多平局或胜利",把 > 改为 >=
// 变体 2:若要"最小化损失",可用类似思路反向扫描
// 另一经典写法(从大到小对位)
// 用最大的马打对手最大的马:能赢就赢,不能赢就用自己的最弱马去"送"小杨同学现在找到了一个题库,一共有 n 套题单,每一套题单中有一定数量的题目。但是他十分挑剔,每套题单他只会使用一次,每一天也只能使用一套题单里的题目,之后那套题单就会弃之不用。对于每套题单,他不必完成题单内所有的题。
那么问题来了,小杨同学最多做题几天才偷懒呢?
第二行 n 个整数 a_1, a_2, … a_n,分别表示每套题单有多少道题。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 4 3 1 4 1 | 3 |
对全部的测试数据,保证 1 ≤q n ≤q 10^6,1 ≤q a_i ≤q 10^9。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
小杨第 k 天必须完成 k 道题,否则就会偷懒。他有一个题库,含 n 套题单,第 i 套有 aᵢ 道题。
规则:每套题单只能用一次,每天也只能用一套题单,而且不必做完题单里的所有题。
问小杨最多能坚持做题多少天不偷懒。
💡人话翻译:第 k 天需要从一套题单里挑出至少 k 道题来做。所以一套有 aᵢ 道题的题单,可以用来满足"第 k 天"当且仅当 aᵢ ≥ k。把题单从小到大排序,然后贪心地依次分配即可。
🔍 关键词提取
排序贪心资源分配可用性条件
已知条件
项目说明
输入第一行 n;第二行 n 个整数 aᵢ
输出最多能坚持的天数
数据范围1 ≤ n ≤ 10⁶
数值范围1 ≤ aᵢ ≤ 10⁹
规则第 k 天需 k 道题;每套题单只用一次;每天只用一套
需要解决的问题
一套题单能满足第几天?aᵢ ≥ k 就能满足第 k 天(因为不必做完)
贪心策略是什么?把题单升序排序,依次处理:如果当前题单够满足"下一个待完成的天数",就用它,天数 +1
为什么这样最优?因为天数需求是 1, 2, 3, … 递增的,用最小的够用题单去满足最小的需求,把大的留到后面——这就是"越早越省"的贪心
📥 读入
n ≤ 10⁶
aᵢ 可达 10⁹
用 long long
读入要快(scanf)
🔢 排序
升序排序题单
O(n log n)
n = 10⁶ 也可接受
小题单优先匹配
🎯 贪心分配
cnt = 已满足天数
遍历题单:若 aᵢ ≥ cnt+1
则 cnt 加 1(用它满足第 cnt+1 天)
不够用就跳过该题单
📤 输出
输出 cnt
不需要真的分配哪套给哪天
只需计数
注意边界
先排序,再依次判断。
步骤当前题单 aᵢ待满足的天数aᵢ ≥ 待满足天数?已满足天数
初始—第 1 天—0
排序后1, 1, 3, 4
第 1 套1第 1 天1 ≥ 1 ✅1
第 2 套1第 2 天1 ≥ 2 ❌ 跳过1
第 3 套3第 2 天3 ≥ 2 ✅2
第 4 套4第 3 天4 ≥ 3 ✅3
1
为什么第 2 套(只有 1 道题)被跳过?
因为此时待满足的是"第 2 天"
第 2 天需要 2 道题,而这套只有 1 道
而且后面每天需求只增不减,所以这套题单永远都用不上了
❌ 直接跳过
2
为什么答案是 3 而不是 4?
4 套题单理论上能撑 4 天(如果题目数都够)
但要坚持第 4 天需要一套 ≥ 4 的题单
我们已经把 4 用在了第 3 天
而且第 2 天必须用 3(因为 1 不够),所以第 4 天没题单可用了
✅ 最多 3 天
答案 3 ✓
🔑贪心的直觉:天数需求是 1, 2, 3, 4, … 递增的。一套有 aᵢ 道题的题单可以用来满足任何 ≤ aᵢ 的天数需求。所以我们从最小的需求(第 1 天)开始,能用最小的题单就用它,把"容量大"的题单留给后面需求更大的日子。
🧮 几个边界
数据分析答案
1
1第 1 天需要 1 道,这套正好 1 道1
1
0题目说 aᵢ ≥ 1,0 不会出现—
2
1 1第 1 天用一套,第 2 天需要 2 道但只剩 1 道1
3
5 5 5每天都能满足(1、2、3 都 ≤ 5)3
3
1 2 3第 1 天用 1、第 2 天用 2、第 3 天用 33
2
2 2第 1 天用 2(或第 2 天用 2),最多2
⚠️注意"不必做完"这个条件:很多同学会误以为"题单必须刚好用完才能用",其实题目明确说"不必完成题单内所有的题",所以只要 aᵢ ≥ k 就能满足第 k 天。读题时这类"不必……"的说明往往是解题的关键。
🟢 排序 + 贪心(推荐) 推荐
题单升序排序,用"下一个待满足的天数"依次匹配
时间 O(n log n)
一遍扫描即得答案
代码 10 行
n = 10⁶ 也轻松
💡核心实现:int cnt = 0; for (每个题单 a) if (a >= cnt + 1) cnt++;——只有三行,因为升序遍历保证了"先用小题单"的贪心选择。
🟠 二分答案 + 可行性检查
二分天数 L,判断能否满足前 L 天
时间 O(n log n)
额外一个 log 因子
代码更长
不如贪心直接
⚠️两种思路都对:"判断能否满足前 L 天"这件事也可以用贪心做,于是二分答案也成立。但既然直接贪心一次就能求出最大的 L,没必要再套一层二分。
📈 性能对比
方案时间复杂度代码量
排序 + 贪心O(n log n)约 10 行
二分答案O(n log n)约 25 行
输入每套题单的题目数,程序会排序后依次匹配天数需求。
输入
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
long long a[1000005];
int main() {
int n;
scanf("%d", &n);
for (int i = 0; i < n; i++) scanf("%lld", &a[i]);
sort(a, a + n); // 升序:小的题单优先满足小的天数需求
int cnt = 0; // 已能坚持的天数
for (int i = 0; i < n; i++) {
// 下一个待满足的是第 cnt+1 天,需要 cnt+1 道题
if (a[i] >= cnt + 1) cnt++;
}
printf("%d\n", cnt);
return 0;
}
🔑为什么三行就够?因为"升序遍历 + 够用就拿来用"这套动作,恰好实现了"用尽可能小的题单满足尽可能小的需求"这一贪心。如果某个题单 a[i] < cnt + 1,它连当前最小的需求都满足不了,后面需求只会更大,所以它永远没用,直接跳过是对的。
📖 关键几行怎么看
代码作用为什么这样写
sort(a, a + n)升序排序保证"先用小题单"的贪心顺序
cnt + 1下一个待满足的天数cnt 是已满足的天数,下一天就是 cnt+1
if (a[i] >= cnt + 1) cnt++;贪心匹配够用就用,把大的留给后面
long long a[]类型aᵢ 可达 10⁹,用 long long 更稳
⚠️三个坑:① 排序顺序搞反(降序排列会让贪心失效);② 判断写成 a[i] >= cnt(应该是 cnt + 1,因为 cnt 是已满足的天数);③ 用 int 读入 aᵢ(1 ≤ aᵢ ≤ 10⁹,int 边界附近要小心)。
写完程序后,用这些数据自查一遍:
输入答案考察点
4
3 1 4 13题面样例
1
11只有一套 1 道题
2
1 11第 2 天需要 2 道,但两套都只有 1 道
3
5 5 53每天需求 1、2、3 都不超过 5
3
1 2 33恰好一一对应
2
1000000000 10000000002极大值,考察 long long
✅自查清单:① 升序排序了吗?② 判断用的是 cnt + 1 吗?③ 读入用 long long 了吗?
🚨 易错点清单
⚠️排序方向错:必须升序。降序时会把大容量题单浪费在小需求上。
⚠️需求量算错:cnt 表示"已满足天数",所以下一个需求是 cnt + 1。
⚠️误以为题单必须用完:题目明确说"不必完成题单内所有的题",所以 aᵢ ≥ k 就够了。
时间复杂度
O(n log n)
空间复杂度
O(n)
n 最大
10⁶
运算量
约 2 × 10⁷
时间怎么算的?
排序 O(n log n),n = 10⁶ 时约 2 × 10⁷ 次比较
扫描一遍 O(n)
合计 O(n log n)
空间都用在哪?
需要存 n 个题单的题目数。
✅ n = 10⁶ 时排序约 2000 万次操作,C++ 可以轻松通过。
// 贪心匹配的"需求递增"结构
// 第 k 天需求 k,所以需求序列是 1, 2, 3, ...
// 资源 aᵢ 能覆盖需求 k 当且仅当 aᵢ >= k
// 排序后用最小的够用资源去满足最小的需求
int cnt = 0;
for (int i = 0; i < n; i++)
if (a[i] >= cnt + 1) cnt++;
// 等价的二分答案写法
bool canDo(int L) { // 能否坚持 L 天
int used = 0;
for (int i = 0; i < n && used < L; i++)
if (a[i] >= used + 1) used++;
return used >= L;
}
// 然后二分 L 即可(但直接贪心更快)
// 这类"需求递增 + 资源可复用一次"的题非常常见
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
递增需求贪心小资源配小需求任务调度、晋升机制、累计型关卡
可用性条件aᵢ ≥ need所有"够不够用"的判断
二分答案把"求最大"变成"判断能否达到"单调性问题的通用套路
🌟思考题:如果规则改成"必须做完整份题单才算完成当天的任务",贪心该怎么改?(提示:那就要求 aᵢ 完全等于当天需求,或者允许当天完成"多份题单"——题意会完全不同。这说明"不必做完"这个细节对解法影响极大,读题务必抓准。)
#include <bits/stdc++.h>
using namespace std;
long long a[1000005];
int main() {
int n;
scanf("%d", &n);
for (int i = 0; i < n; i++) scanf("%lld", &a[i]);
sort(a, a + n); // 升序:小的题单优先满足小的天数需求
int cnt = 0; // 已能坚持的天数
for (int i = 0; i < n; i++) {
// 下一个待满足的是第 cnt+1 天,需要 cnt+1 道题
if (a[i] >= cnt + 1) cnt++;
}
printf("%d\n", cnt);
return 0;
}// 贪心匹配的"需求递增"结构
// 第 k 天需求 k,所以需求序列是 1, 2, 3, ...
// 资源 aᵢ 能覆盖需求 k 当且仅当 aᵢ >= k
// 排序后用最小的够用资源去满足最小的需求
int cnt = 0;
for (int i = 0; i < n; i++)
if (a[i] >= cnt + 1) cnt++;
// 等价的二分答案写法
bool canDo(int L) { // 能否坚持 L 天
int used = 0;
for (int i = 0; i < n && used < L; i++)
if (a[i] >= used + 1) used++;
return used >= L;
}
// 然后二分 L 即可(但直接贪心更快)
// 这类"需求递增 + 资源可复用一次"的题非常常见小杨可以选择一些宝箱放入背包并带走,但是小杨的背包比较特殊,假设小杨选择的宝箱中最大价值为 x,最小价值为 y,小杨需要保证 x-y≤q k,否则小杨的背包会损坏。
小杨想知道背包不损坏的情况下,自己能够带走宝箱的总价值最大是多少。
第二行包含 n 个正整数 a_1,a_2,…,a_n,代表宝箱的价值。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 5 1 1 2 3 1 2 | 7 |
在背包不损坏的情况下,小杨可以拿走两个价值为 2 的宝箱和一个价值为 3 的宝箱。
【数据范围】
对于全部数据,保证有 1≤q n≤q 1000,0≤q k≤q 1000,1≤q a_i≤q 1000。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
有 n 个宝箱,第 i 个价值 aᵢ。小杨可以选一些带走,但背包要求:所选宝箱中最大价值 x 与最小价值 y 满足 x − y ≤ k,否则背包会损坏。
求背包不损坏的情况下,能带走宝箱的最大总价值。
💡人话翻译:所选宝箱的"价值跨度"不能超过 k。关键洞察:把价值排序后,如果某个集合满足"跨度 ≤ k",那么把它补齐成一段连续区间(在排序数组上)只会让总和更大、跨度不变。所以问题变成:排序后,枚举所有跨度 ≤ k 的连续区间,取最大和。
🔍 关键词提取
排序连续区间枚举前缀和极差约束
已知条件
项目说明
输入第一行 n、k;第二行 n 个正整数
输出最大总价值
数据范围1 ≤ n ≤ 1000
数值范围0 ≤ k ≤ 1000,1 ≤ aᵢ ≤ 1000
约束所选集合的 max − min ≤ k
需要解决的问题
为什么可以只考虑连续区间?设最优集合的最小值是 a[l]、最大值是 a[r],那么把它换成排序后的区间 [l, r](把中间的数都选上)跨度仍是 a[r] − a[l] ≤ k,但总和变大了——所以最优解一定对应某个连续区间
怎么枚举?排序后枚举左右端点 l、r,要求 a[r] − a[l] ≤ k
怎么快速求和?用前缀和 O(1) 求区间和
🧠 核心转化
所选集合跨度 ≤ k
补齐中间的数不会让跨度变大
但会让总和变大
⇒ 最优解必是连续区间
📥 排序
升序排序
跨度 = a[r] − a[l]
重复值可以全选
n ≤ 1000 可 O(n²)
🔍 枚举区间
l 从 0 到 n−1
r 从 l 往后扩
直到 a[r] − a[l] > k 停止
用前缀和求区间和
⚠️ 易错点
忘记"可以只选一部分"
跨度写成 < k 而非 ≤ k
未排序导致枚举无效
前缀和下标偏移
先排序,再枚举所有跨度 ≤ 1 的区间。
步骤内容
原数组1, 2, 3, 1, 2
排序后1, 1, 2, 2, 3
下标0, 1, 2, 3, 4
枚举所有跨度 ≤ 1 的区间
区间元素跨度是否 ≤ 1区间和
[0,0]10✅1
[0,1]1, 10✅2
[0,2]1, 1, 22 − 1 = 1✅4
[0,3]1, 1, 2, 22 − 1 = 1✅6
[0,4]1, 1, 2, 2, 33 − 1 = 2❌—
[1,2]1, 21✅3
[1,3]1, 2, 21✅5
[2,3]2, 20✅4
[2,4]2, 2, 33 − 2 = 1✅7
[3,4]2, 31✅5
[4,4]30✅3
1
最大区间和是 7
区间 [2,4] = {2, 2, 3},跨度 3 − 2 = 1 ≤ 1
总和 = 2 + 2 + 3 = 7
另一个候选 [0,3] = {1, 1, 2, 2} 总和 6,更小
✅ 答案 7
2
与题面解释对照
题面说"拿走两个价值为 2 的宝箱和一个价值为 3 的宝箱"
正是 {2, 2, 3},总和 7 ✓
注意 aᵢ = 1 的两个宝箱没被选中——因为一旦选它们,跨度就变成 3 − 1 = 2 > k
✅ 完全吻合
🔑注意"1 和 3 不能同时选":本文样例中 k = 1,所以跨度最多为 1。价值 1 和 3 跨度为 2,超出限制,因此只能在"低位区"(1 和 2)或"高位区"(2 和 3)中选一段。最终 {2, 2, 3} 的和更大。
🧮 边界情形
情形数据分析答案
k = 0a = [5, 5, 3]跨度必须为 0 → 只能选全部相同的值10(两个 5)
只有一个宝箱a = [7]必选7
全部相同a = [4, 4, 4]跨度 0,全选12
k 足够大a = [1, 100], k = 99跨度 99 ≤ 99,可以全选101
⚠️注意 k 可能为 0:此时只能选完全相同的价值,答案就是"出现次数最多的那个值的出现次数 × 该值"。写代码时不要假设 k > 0。
🟢 排序 + 枚举区间(推荐) 推荐
排序后双层循环枚举左右端点,用前缀和求和
时间 O(n²)
n = 1000 时约 5 × 10⁵ 次
代码 12 行
直观好写
💡实现要点:固定左端点 l,让 r 向右扩展,一旦 a[r] - a[l] > k 就停止(再往右只会更大)。
🟠 双指针 O(n)
随着 l 右移,r 也单调右移,用滑动窗口维护区间和
时间 O(n)
代码稍复杂
需要处理窗口和的增减
本题属于锦上添花
⚠️为什么单调:l 增大时 a[l] 变大,窗口右端 r 的最远位置只会更远或不变,所以 r 可以继承上一轮的位置不回头,整体是 O(n)。
📈 性能对比
方案本题运算量n = 10⁵ 时
排序 + 枚举约 5 × 10⁵约 5 × 10⁹(超时)
双指针约 10³约 1.7 × 10⁶(可行)
第一行输入价值和 k(用 | 分隔),程序会排序并枚举所有跨度 ≤ k 的区间。
输入
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int a[1005];
long long pre[1005];
int main() {
int n, k;
scanf("%d %d", &n, &k);
for (int i = 0; i < n; i++) scanf("%d", &a[i]);
sort(a, a + n); // 排序后,最优解对应一段连续区间
// 前缀和:pre[i] = a[0] + ... + a[i-1]
pre[0] = 0;
for (int i = 0; i < n; i++) pre[i + 1] = pre[i] + a[i];
long long ans = 0;
for (int l = 0; l < n; l++) {
for (int r = l; r < n; r++) {
if (a[r] - a[l] > k) break; // 跨度超标,再往右只会更大
long long sum = pre[r + 1] - pre[l]; // 区间 [l, r] 的和
if (sum > ans) ans = sum;
}
}
printf("%lld\n", ans);
return 0;
}
🔑为什么内层循环能 break?因为数组已经升序,随着 r 增大 a[r] 只增不减,所以 a[r] - a[l] 也会单调增大。一旦超标,后面全部超标,直接 break 就能省掉大量无用检查。
📖 关键几行怎么看
代码作用为什么这样写
sort(a, a + n)排序让"跨度"对应连续区间的端点差
pre[i+1] = pre[i] + a[i]前缀和使区间和查询变成一次减法
if (a[r] - a[l] > k) break;跨度检查超标就停,因为后面更大
pre[r+1] - pre[l]区间和注意上界是 r+1 而不是 r
⚠️三个坑:① 不排序就枚举(那样"跨度 ≤ k 的最优集合"无法用连续区间表示);② 跨度判断写成 < k(题目是 ≤ k);③ 前缀和下标写错:区间 [l, r] 的和是 pre[r+1] - pre[l]。
写完程序后,用这些数据自查一遍:
输入答案考察点
5 1
1 2 3 1 27题面样例
1 0
77单个宝箱,必选
3 0
5 5 310k = 0 只能选相同的值,两个 5 得 10
3 100
1 2 36k 很大,全部可以选
4 2
10 20 30 4040相邻两数相差 10 > k = 2,任何两个都不能同选,最大为 40
3 5
1 4 6116 − 1 = 5 ≤ 5,三个都选得 11
✅自查清单:① 排序了吗?② 跨度用的是 ≤ 吗?③ 前缀和下标对吗?
🚨 易错点清单
⚠️不排序就枚举:必须排序,否则"最优集合是连续区间"这个性质不成立。
⚠️跨度写成严格小于:题目要求 max − min ≤ k,包含等于的情况。
⚠️前缀和下标错位:区间 [l, r] 的和是 pre[r+1] − pre[l]。
时间复杂度
O(n²)
空间复杂度
O(n)
n 最大
1000
最坏运算
约 5 × 10⁵
时间怎么算的?
排序 O(n log n)
枚举区间 O(n²),n = 1000 时约 50 万次
每次用前缀和 O(1) 求和
空间都用在哪?
需要存数组与前缀和数组。
✅ 约 50 万次操作,瞬间完成。如果 n 达到 10⁵,就要改用双指针滑动窗口。
// 核心结论:排序后,满足"极差 ≤ k"的最优子集一定对应一段连续区间
// 证明直觉:若最优集合的最小值在位置 l、最大值在位置 r,
// 则把 [l, r] 中所有元素都选上,极差不变(仍是 a[r]-a[l]),
// 但总和变大 -> 所以连续区间必然不劣于原集合。
// 前缀和求区间和
long long rangeSum(int l, int r) { return pre[r+1] - pre[l]; }
// 双指针 O(n) 版本(n 很大时用)
long long best = 0, cur = 0;
int r = 0;
for (int l = 0; l < n; l++) {
while (r < n && a[r] - a[l] <= k) { cur += a[r]; r++; }
best = max(best, cur);
cur -= a[l]; // 左端点右移,去掉 a[l]
}
// 类似的"极差约束"题目都可以用这个套路
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
排序 + 连续区间极差约束 → 排序后枚举区间选数最大化、预算分配、区间最值
前缀和求区间和O(1) 查询所有需要反复求区间和的题
单调性 break差值单调 → 可提前终止优化枚举的常用技巧
🌟思考题:如果题目改成"所选个数最多"(而不是总价值最大),策略会变吗?(提示:策略不变——同样是排序后枚举跨度 ≤ k 的最长连续区间,只是把"求最大和"换成"求最大长度"。这也说明"排序 + 连续区间"是这类极差约束问题的通用框架。)
#include <bits/stdc++.h>
using namespace std;
int a[1005];
long long pre[1005];
int main() {
int n, k;
scanf("%d %d", &n, &k);
for (int i = 0; i < n; i++) scanf("%d", &a[i]);
sort(a, a + n); // 排序后,最优解对应一段连续区间
// 前缀和:pre[i] = a[0] + ... + a[i-1]
pre[0] = 0;
for (int i = 0; i < n; i++) pre[i + 1] = pre[i] + a[i];
long long ans = 0;
for (int l = 0; l < n; l++) {
for (int r = l; r < n; r++) {
if (a[r] - a[l] > k) break; // 跨度超标,再往右只会更大
long long sum = pre[r + 1] - pre[l]; // 区间 [l, r] 的和
if (sum > ans) ans = sum;
}
}
printf("%lld\n", ans);
return 0;
}// 核心结论:排序后,满足"极差 ≤ k"的最优子集一定对应一段连续区间
// 证明直觉:若最优集合的最小值在位置 l、最大值在位置 r,
// 则把 [l, r] 中所有元素都选上,极差不变(仍是 a[r]-a[l]),
// 但总和变大 -> 所以连续区间必然不劣于原集合。
// 前缀和求区间和
long long rangeSum(int l, int r) { return pre[r+1] - pre[l]; }
// 双指针 O(n) 版本(n 很大时用)
long long best = 0, cur = 0;
int r = 0;
for (int l = 0; l < n; l++) {
while (r < n && a[r] - a[l] <= k) { cur += a[r]; r++; }
best = max(best, cur);
cur -= a[l]; // 左端点右移,去掉 a[l]
}
// 类似的"极差约束"题目都可以用这个套路小杨计划对序列进行多次升序排序,每次升序排序小杨会选择一个区间 [l,r](l ≤q r)并对区间内所有数字,即进行升序 a_l, a_{l + 1}, … a_r 排序。每次升序排序会在上一次升序排序的结果上进行。
小杨想请你计算出多次升序排序后的序列。
第二行包含 n 个正整数 a_1, a_2, … a_n,代表序列 a。
第三行包含一个正整数 q,代表排序次数。
之后 q 行,每行包含两个正整数 l, r,代表将区间 [l_i, r_i] 内所有数字进行升序排序。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 5 3 4 5 2 1 3 4 5 3 4 1 3 | 1 3 4 5 2 |
- 第一次升序排序后,序列为 [3,4,5,1,2];
- 第二次升序排序后,序列为 [3,4,1,5,2];
- 第三次升序排序后,序列为 [1,3,4,5,2];
数据规模与约定
对于全部的测试数据,保证 1 ≤q n, a_i, q ≤q 100,1 ≤q l_i ≤q r_i ≤q n。
· 把规则一步步翻译成代码,用变量记住当前状态。
· 先把数据读进结构体数组,再按题意写 cmp。
写完后可到洛谷
B4041 对照题解。- 数列的第一项 a_1 是 1;
- 如果 a_{k-1}-k 是正整数并且没有在数列中出现过,那么数列的第 k 项 a_k 为 a_{k-1}-k,否则为 a_{k-1}+k。
小杨想知道 Recamán 数列的前 n 项从小到大排序后的结果。手动计算非常困难,小杨希望你能帮他解决这个问题。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 5 | 1 2 3 6 7 |
| 2 | 8 | 1 2 3 6 7 12 13 20 |
对于样例 1,n=5:
- a_1=1;
- a_1-2=-1,不是正整数,因此 a_2=a_1+2=3;
- a_2-3=0,不是正整数,因此 a_3=a_2+3=6;
- a_3-4=2,是正整数,且没有在数列中出现过,因此 a_4=a_3-4=2;
- a_4-5=-3,不是正整数,因此 a_5=a_4+5=7。
a_1,a_2,a_3,a_4,a_5 从小到大排序的结果为 1,2,3,6,7。
数据范围
对于所有数据点,保证 1≤ n≤ 3 000。
· 先手算前 5 项,找出递推关系再写循环。
· 先把数据读进结构体数组,再按题意写 cmp。
写完后可到洛谷
B4068 对照题解。- 假设 t_i 为字符串 t 的第 i 个字符,对于所有的 j\lt i 均有 t_j≤ t_i。两个字符的大小关系与其在字母表中的顺序一致,例如 \texttt{e}\lt \texttt{g}\lt \texttt{p} \lt \texttt{s}。
小杨想知道是否存在满足条件的字符串排列顺序。
对于每组测试数据,第一行包含一个正整数 n,含义如题面所示。
之后 n 行,每行包含一个字符串 s_i。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 3 3 aa ac de 2 aac bc 1 gesp | 1 0 0 |
对于第一组测试数据,一种可行的排列顺序为 \texttt{aa}+\texttt{ac}+\texttt{de},构成的字符串 t 为 \texttt{aaacde},满足条件。
对于全部数据,保证有 1≤ T,n≤ 100,每个字符串的长度不超过 10。
· 逐字符处理,注意空串与越界。
· 先排序,再按「每步取最优」推一遍,验证有没有反例。
写完后可到洛谷
B4069 对照题解。给定由 n 个整数构成的数组 [a_1, a_2, …, a_n],你可以任意重排数组 a 中元素顺序。请问在重排顺序之后,a 所有是连续段的子数组中,最长的子数组长度是多少?
例如,对于数组 [1, 0, 2, 4],可以将其重排为 [4, 0, 1, 2],有以下 10 个子数组:
$[4], [0], [1], [2], [4, 0], [0, 1], [1, 2], [4, 0, 1], [0, 1, 2], [4, 0, 1, 2]
其中除 [4, 0], [4, 0, 1], [4, 0, 1, 2]$ 以外的子数组均是连续段,因此是连续段的子数组中,最长子数组长度为 3。
第二行,n 个整数 a_1, a_2, …, a_n,表示数组中的整数。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 4 1 0 2 4 | 3 |
| 2 | 9 9 9 8 2 4 4 3 5 3 | 4 |
对于所有测试点,保证 1 ≤q n ≤q 10^5,-10^9 ≤q a_i ≤q 10^9。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
对于 k 个整数构成的数组 [b₁, b₂, …, b_k],如果对任意 1 ≤ i < k 都有 b(i+1) = b(i) + 1,则称它是一个连续段。
给定数组 a,你可以任意重排它的元素顺序。问重排后,所有是连续段的子数组中,最长的长度是多少。
💡人话翻译:连续段要求"后一个恰好比前一个大 1",所以段内元素必须互不相同且恰好连成一段(比如 3、4、5、6)。重排能让我们把这些数排到一起,所以问题就变成了:数组里最长的一段"连续整数"有多长。
🔍 关键词提取
重排去重连续整数区间排序
已知条件
项目说明
输入第一行 n;第二行 n 个整数
输出重排后最长连续段的长度
数据范围n ≤ 10⁵
数值范围−10⁹ ≤ aᵢ ≤ 10⁹,可能为负
子数组必须下标连续;重排指的是先重排整个数组再取子数组
需要解决的问题
"重排"意味着什么?我们可以自由决定元素顺序,所以只要数组里有 {x, x+1, …, y},就能把它们排成连续段
重复元素怎么办?重复的数字无法放进同一个连续段(因为段内不能相等),所以要先去重
怎么找最长区间?排序去重后,扫一遍统计"相邻差 1"的最长链
🧠 核心转化
连续段要求相邻差 1
所以段内元素互不相同
重排可自由安排顺序
等价于"找最长连续整数区间"
📥 处理数组
排序(去重更简单)
或排序后用 unique
也用 set 去重
aᵢ 可能为负
🔍 扫描统计
维护当前链长 cur
若 a[i] == a[i−1] → 跳过
若 == a[i−1]+1 → cur++
否则 cur 重置为 1
⚠️ 易错点
忘记去重
把"差 1"写成"差不大于 1"
没处理负数
n = 1 的边界
先看"重排"能带来什么,再把它转化成找连续区间。
1
观察:重排能改变什么
原数组里 0、1、2 是连续的,但 4 插在中间
重排成 [4, 0, 1, 2] 后,后半段 0、1、2 就成了连续段
所以答案是 3
✅ 3
2
转化成"最长连续整数区间"
数组里的数去重后是 {0, 1, 2, 4}
其中 0、1、2 是连续的一段(长度 3)
4 单独一个,不接前面(2 和 4 之间缺了 3)
✅ 最长连续区间长度 = 3
排序去重后相邻差是否连续
0—起点
11✅ 连续
21✅ 连续
42❌ 断了
最长链:0 → 1 → 2,长度 3 ✓
🧮 样例 2:数组 [9, 9, 8, 2, 4, 4, 3, 5, 3]
这组数据里有很多重复(9 出现 2 次、4 出现 2 次、3 出现 2 次),正好考察"去重"。
步骤内容说明
原数组9, 9, 8, 2, 4, 4, 3, 5, 3有重复元素
排序2, 3, 3, 4, 4, 5, 8, 9, 9相同元素相邻
去重2, 3, 4, 5, 8, 9重复的只保留一个
找最长连续区间2 → 3 → 4 → 5(长度 4)8、9 是另一段(长度 2)
答案 4 ✓
🔑为什么必须去重?假设数组是 [3, 3, 4],如果不做去重,排序后是 3, 3, 4,扫描时会看到"3 到 3 差 0"和"3 到 4 差 1",容易误算成长度 3。但连续段要求严格递增 1,两个 3 不可能同时出现在同一个连续段里,所以正确答案是 2(3, 4)。
🟢 排序 + 去重 + 扫描(推荐) 推荐
排序后扫一遍,跳过重复元素,统计相邻差 1 的最长链
时间 O(n log n)
代码 10 行
不需要额外容器
负数也能正确处理
💡扫描规则:如果 a[i] == a[i-1] 就跳过(去重);如果 a[i] == a[i-1] + 1 就让链长加一;否则链长重置为 1。
🟠 用 set 判断"是否是新链的起点"
把数放进 set,只从"x−1 不在 set 中"的数开始往后数
平均时间 O(n)
需要哈希容器
思路巧妙但边界多
处理负数/大值要注意
⚠️优点:省掉排序的 log 因子;缺点:需要额外 set 空间,而且"从每个链的起点出发"这个逻辑不如扫描法直观。本题 n ≤ 10⁵,排序完全够快。
📈 性能对比
方案时间复杂度代码量
排序 + 扫描O(n log n)约 10 行
set 起点法期望 O(n)约 18 行
输入一组整数,程序会排序去重并找出最长的连续整数区间。
输入
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
long long a[100005];
int main() {
int n;
scanf("%d", &n);
for (int i = 0; i < n; i++) scanf("%lld", &a[i]);
sort(a, a + n); // 排序后相同元素相邻,便于去重
int best = 1, cur = 1;
for (int i = 1; i < n; i++) {
if (a[i] == a[i - 1]) continue; // 重复元素跳过(相当于去重)
if (a[i] == a[i - 1] + 1) cur++; // 恰好差 1,链延长
else cur = 1; // 断了,重新开始
if (cur > best) best = cur;
}
printf("%d\n", best);
return 0;
}
🔑为什么"重复跳过"就够了?排序后相同元素一定相邻,遇到 a[i] == a[i-1] 时直接 continue,既不重置链长、也不延长,效果等同于"把重复元素删掉"。这比先手动 unique 再扫描更简洁。
📖 关键几行怎么看
代码作用为什么这样写
sort(a, a + n)排序让相同元素相邻,也让连续数相邻
if (a[i] == a[i-1]) continue;去重跳过重复,不影响当前链长
if (a[i] == a[i-1] + 1) cur++;链延长必须是恰好差 1
else cur = 1;链重置新的一段从这里开始
⚠️三个坑:① 没做去重:[3, 3, 4] 会被误算成 3;② 把"差恰好 1"写成"差不大于 1",那样 [3, 3] 也会被算成长度 2;③ best 初始化为 0:当 n = 1 时会输出 0,应该是 1。
写完程序后,用这些数据自查一遍:
输入答案考察点
4
1 0 2 43题面样例 1
9
9 9 8 2 4 4 3 5 34题面样例 2(含大量重复)
1
71单元素,长度为 1
3
3 3 42必须去重:答案是 3、4 长度 2
3
3 3 31全相同,去重后只剩 1 个
5
5 4 3 2 15排序后恰好是 1~5,答案 5
4
-3 -2 -1 -53负数同样适用,−3、−2、−1 连续
✅自查清单:① 去重了吗?② 判定是"恰好差 1"吗?③ 负数能处理吗(用 long long)?
🚨 易错点清单
⚠️忘记去重:[3, 3, 4] 会被误判为 3。连续段要求严格递增 1,重复元素不可能在同一段内。
⚠️把"差 1"写成"差不大于 1":那样相等的元素也会被并入,答案偏大。
⚠️best 初始化为 0:n = 1 时会输出 0,正确的最小答案是 1。
时间复杂度
O(n log n)
空间复杂度
O(n)
n 最大
10⁵
运算量
约 1.7 × 10⁶
时间怎么算的?
排序:O(n log n)
扫描一遍:O(n)
合计 O(n log n),n = 10⁵ 时约 1.7 × 10⁶ 次操作
空间都用在哪?
需要存下整个数组。
✅ 10⁵ 规模排序加扫描,瞬间完成。
// 去重的三种写法
// 1) 排序 + 扫描时跳过(本题用法,最省事)
// 2) 排序 + unique
sort(a, a + n);
int m = unique(a, a + n) - a; // m 是去重后的长度
// 3) 用 set 自动去重(值域大或稀疏时用)
set<long long> s(a, a + n);
for (long long x : s) { /* 已升序且无重复 */ }
// 找最长连续整数区间的"起点法"(不排序)
set<long long> st(a, a + n);
int best = 1;
for (long long x : st) {
if (st.count(x - 1)) continue; // 不是链起点,跳过
long long y = x;
while (st.count(y + 1)) y++;
best = max(best, (int)(y - x + 1));
}
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
重排问题转化把"可重排"理解为"自由挑子集"所有"可重排后求最优"的题目
去重必要性连续段内不能有重复严格递增/递减序列类问题
排序 + 扫描相邻元素比较求最长连续、最长递增子序列(简化版)
🌟思考题:如果题目改成"子序列(可以不连续)中最长的连续段",答案会变吗?(提示:不会变——因为我们可以重排整个数组,所以能不能连成一段只取决于"这些值是否都存在",与它们在原数组中的位置无关。这也是本题可以"先重排再取子数组"的原因。)
#include <bits/stdc++.h>
using namespace std;
long long a[100005];
int main() {
int n;
scanf("%d", &n);
for (int i = 0; i < n; i++) scanf("%lld", &a[i]);
sort(a, a + n); // 排序后相同元素相邻,便于去重
int best = 1, cur = 1;
for (int i = 1; i < n; i++) {
if (a[i] == a[i - 1]) continue; // 重复元素跳过(相当于去重)
if (a[i] == a[i - 1] + 1) cur++; // 恰好差 1,链延长
else cur = 1; // 断了,重新开始
if (cur > best) best = cur;
}
printf("%d\n", best);
return 0;
}// 去重的三种写法
// 1) 排序 + 扫描时跳过(本题用法,最省事)
// 2) 排序 + unique
sort(a, a + n);
int m = unique(a, a + n) - a; // m 是去重后的长度
// 3) 用 set 自动去重(值域大或稀疏时用)
set<long long> s(a, a + n);
for (long long x : s) { /* 已升序且无重复 */ }
// 找最长连续整数区间的"起点法"(不排序)
set<long long> st(a, a + n);
int best = 1;
for (long long x : st) {
if (st.count(x - 1)) continue; // 不是链起点,跳过
long long y = x;
while (st.count(y + 1)) y++;
best = max(best, (int)(y - x + 1));
}小 A 想让二维网格变得有序,因此他先对每一行从左到右按升序排序,再对每一列从上到下按升序排序。以下是一个先完成行排序再完成列排序的例子:
$
\begin{array}{|c|c|c|c|}\hline 1&3&2&5\\\hline 6&2&4&4\\\hline 5&4&1&3\\\hline\end{array}\xrightarrow{每行升序排序}\begin{array}{|c|c|c|c|}\hline 1&2&3&5\\\hline 2&4&4&6\\\hline 1&3&4&5\\\hline\end{array}\xrightarrow{每列升序排序}\begin{array}{|c|c|c|c|}\hline 1&2&3&5\\\hline 1&3&4&5\\\hline 2&4&4&6\\\hline\end{array}
$
小 A 想知道二维网格经过以上排序后的结果。你能编写程序帮助他吗?
接下来 n 行,每行 m 个整数 a_{i,1},…,a_{i,m},表示二维网格中的数字。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 3 2 6 5 4 3 2 1 | 1 2 3 4 5 6 |
| 2 | 3 4 1 3 2 5 6 2 4 4 5 4 1 3 | 1 2 3 5 1 3 4 5 2 4 4 6 |
对于所有测试点,保证 2 ≤ n ≤ 10,2 ≤ m ≤ 10,1 ≤ a_{i,j} ≤ 100。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
给定 n 行 m 列的网格。请先对每一行从左到右按升序排序,再对每一列从上到下按升序排序,输出最终结果。
例如:
1 3 2 5 行排序后 1 2 3 5 列排序后 1 2 3 5
6 2 4 4 ────→ 2 4 4 6 ────→ 1 3 4 5
5 4 1 3 1 3 4 5 2 4 4 6
💡人话翻译:分两步,先横后竖。第一步对每行内部排序;第二步把每一列的 m 个数收集起来排序,再写回该列。注意顺序不能颠倒,也不能"边排边修"——必须严格按题面的两步走。
🔍 关键词提取
行排序列排序两阶段处理排序模拟
已知条件
项目说明
输入第一行 n、m;随后 n 行每行 m 个整数
输出n 行,每行 m 个整数
数据范围1 ≤ n, m ≤ 1000
数值范围整数(用 int 即可)
处理顺序先每行升序,再每列升序
需要解决的问题
行排序怎么做?对每一行调用一次 sort
列排序怎么做?把第 j 列的 n 个数复制到一个临时数组,排序后再写回
能"边排边覆盖"吗?不能!必须先把整列取出来,排序完成后整体写回
📥 读入
n、m ≤ 1000
每行 m 个整数
用二维数组存
int 足够
➡️ 第一步:行排序
对每一行 sort
行内从左到右升序
n 次排序
每次 O(m log m)
⬇️ 第二步:列排序
对每一列:取出到临时数组
对临时数组 sort
再写回该列
m 次排序,每次 O(n log n)
⚠️ 易错点
边排边写导致数据被覆盖
顺序颠倒(先列后行)
只排了一半
临时数组未清空
6 5
4 3
2 1
1
第 1 步:对每行排序
第 1 行 6 5 → 5 6
第 2 行 4 3 → 3 4
第 3 行 2 1 → 1 2
此时网格:5 6 / 3 4 / 1 2
行排序完成
2
第 2 步:对每列排序
第 1 列:5、3、1 → 排序后 1、3、5
第 2 列:6、4、2 → 排序后 2、4、6
写回后网格:1 2 / 3 4 / 5 6
✅ 输出 1 2 / 3 4 / 5 6
1 2
3 4
5 6
与样例输出一致 ✓
🧮 题面 3 × 4 例子的完整演示
1 3 2 5
6 2 4 4
5 4 1 3
1
第 1 步:三行分别排序
第 1 行 1 3 2 5 → 1 2 3 5
第 2 行 6 2 4 4 → 2 4 4 6
第 3 行 5 4 1 3 → 1 3 4 5
1 2 3 5 / 2 4 4 6 / 1 3 4 5
2
第 2 步:四列分别排序
第 1 列 1、2、1 → 1、1、2
第 2 列 2、4、3 → 2、3、4
第 3 列 3、4、4 → 3、4、4
第 4 列 5、6、5 → 5、5、6
✅ 1 2 3 5 / 1 3 4 5 / 2 4 4 6
1 2 3 5
1 3 4 5
2 4 4 6
🔑注意列排序不是"列内相邻交换",而是整列重新排序。例如第 1 列原本是 1、2、1,排序后变成 1、1、2——这说明元素可以在列内"跨越移动"。实现时最稳妥的做法是:把整列复制到临时数组 → 排序 → 整列写回。
🟢 整列取出再写回(推荐) 推荐
对每列复制到临时数组,排序后整体写回
时间 O(nm log m + nm log n)
逻辑清晰
不会覆盖未处理的数据
代码 20 行
💡实现:for (j = 0; j < m; j++) { vector<int> col; for (i = 0; i < n; i++) col.push_back(a[i][j]); sort(col.begin(), col.end()); for (i = 0; i < n; i++) a[i][j] = col[i]; }。
🟠 原地冒泡/选择排序
在列内用相邻交换完成排序
时间 O(n²m),n = 1000 时约 10⁹
可能超时
代码更啰嗦
且容易写错
⚠️为什么不用:本题 n, m ≤ 1000,O(n²m) 最坏约 10⁹ 次交换,很可能超时。直接用标准 sort 是 O(nm log n),快得多。
📈 性能对比
方案复杂度(1000×1000)是否可行
整列 sort约 2 × 10⁷✅ 可行
原地冒泡约 10⁹❌ 可能超时
第一行输入 n 和 m,随后 n 行每行 m 个数。程序会先排行、再排列。
输入数据3 4
1 3 2 5
6 2 4 4
5 4 1 3
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int a[1005][1005];
int main() {
int n, m;
scanf("%d %d", &n, &m);
for (int i = 0; i < n; i++)
for (int j = 0; j < m; j++)
scanf("%d", &a[i][j]);
// 第一步:每一行升序排序
for (int i = 0; i < n; i++) {
sort(a[i], a[i] + m);
}
// 第二步:每一列升序排序
for (int j = 0; j < m; j++) {
vector<int> col;
for (int i = 0; i < n; i++) col.push_back(a[i][j]); // 取出整列
sort(col.begin(), col.end()); // 排序
for (int i = 0; i < n; i++) a[i][j] = col[i]; // 写回整列
}
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
if (j) printf(" ");
printf("%d", a[i][j]);
}
printf("\n");
}
return 0;
}
🔑为什么 sort(a[i], a[i] + m) 就能排一行?因为二维数组 a[i] 本质上是"第 i 行的首地址",a[i] + m 是行末的下一个位置,正好构成一个长度为 m 的一维区间。这种写法比手写内层循环更简洁。
📖 关键几行怎么看
代码作用为什么这样写
sort(a[i], a[i] + m)行排序二维数组的一行就是一维区间
col.push_back(a[i][j])取出整列先把整列复制出来,避免边排边覆盖
sort(col.begin(), col.end())列排序对临时数组排序
a[i][j] = col[i]写回整列排序完成后整体写回
⚠️三个坑:① 边排边写(比如找到最小值就直接写到 a[0][j]),会把还没比较的元素覆盖掉——必须先把整列取出来;② 顺序颠倒(先列后行),结果会完全不同;③ 用冒泡排序处理列,n = 1000 时可能超时。
写完程序后,用这些数据自查一遍:
输入答案考察点
3 2
6 5 / 4 3 / 2 11 2 / 3 4 / 5 6题面样例
3 4
1 3 2 5 / 6 2 4 4 / 5 4 1 31 2 3 5 / 1 3 4 5 / 2 4 4 6题面中的演示例子
1 1
77单格
1 3
3 1 21 2 3单行时只有行排序发生作用
3 1
3 / 1 / 21 / 2 / 3单列时行排序不改变任何值,列排序完成升序
✅自查清单:① 先排行再排列了吗?② 列是整列取出排序的吗?③ 输出格式对吗?
🚨 易错点清单
⚠️边排边写:必须先把整列取出到临时数组,排序后再整体写回,否则会覆盖未处理的数据。
⚠️顺序颠倒:必须"先全部行排序、再全部列排序",不能交替进行。
⚠️用冒泡排序处理列:n = 1000 时 O(n²m) 约 10⁹,可能超时,应使用标准 sort。
时间复杂度
O(nm log m + nm log n)
空间复杂度
O(nm)
n, m 最大
1000
运算量
约 2 × 10⁷
时间怎么算的?
行排序:n 次,每次 O(m log m)
列排序:m 次,每次 O(n log n)
合计约 O(nm(log n + log m))
n = m = 1000 时约 2000 万次操作
空间都用在哪?
二维数组本身占 n × m,列排序时额外需要一个长度为 n 的临时数组。
✅ 约 2000 万次操作,C++ 瞬间完成。如果列排序用 O(n²),会到 10⁹ 量级,就有超时风险了。
// 二维数组的一行作为一维区间排序
for (int i = 0; i < n; i++) sort(a[i], a[i] + m);
// 对每一列排序(先取出,再写回)
for (int j = 0; j < m; j++) {
vector<int> col(n);
for (int i = 0; i < n; i++) col[i] = a[i][j];
sort(col.begin(), col.end());
for (int i = 0; i < n; i++) a[i][j] = col[i];
}
// 用 vector<vector<int>> 的等价写法
vector<vector<int>> g(n, vector<int>(m));
for (auto &row : g) sort(row.begin(), row.end());
for (int j = 0; j < m; j++) {
vector<int> col;
for (int i = 0; i < n; i++) col.push_back(g[i][j]);
sort(col.begin(), col.end());
for (int i = 0; i < n; i++) g[i][j] = col[i];
}
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
行/列排序二维数组的行是一维区间矩阵处理、表格排序
先取出再写回避免覆盖未处理数据所有原地变换类操作
复杂度估算排序 O(k log k)选择算法时先估算运算量
🌟思考题:如果题目改成"先列排序、再行排序",结果会和现在一样吗?(提示:一般不一样。可以自己用样例数据试试:先列后行得到的结果通常与先行后列不同。这说明"排序顺序"是不可交换的——所以读题时务必确认清楚处理顺序。)
1 3 2 5 行排序后 1 2 3 5 列排序后 1 2 3 5 6 2 4 4 ────→ 2 4 4 6 ────→ 1 3 4 5 5 4 1 3 1 3 4 5 2 4 4 6
6 5 4 3 2 1
1 2 3 4 5 6
1 3 2 5 6 2 4 4 5 4 1 3
同时,小苏接到了 n 笔订单,第 i 笔订单要求交付 b_i 个锣鼓。小苏同学想知道,是否存在一种合理安排机器使用和交付订单的顺序,使得她在接下来的 n 天里,每天都能交付一个订单?
每组数据第一行是一个整数 n(1 ≤q n ≤q 10^3),表示机器数和订单数。
第二行有 n 个整数 a_1, a_2, … a_n(1 ≤q a_i ≤q 10^4),依次表示每台机器工作一天可以生产的锣鼓数量。
第三行有 n 个整数 b_1, b_2, … b_n(1 ≤q b_i ≤q 10^4),依次表示每个订单要求交付的锣鼓数量。
- 如果不存在一种方案使得她在接下来的 n 天里,每天都能交付一个订单,输出一行一个字符串 No。
- 否则输出三行:
+ 第一行输出 Yes。
+ 第二行输出 n 个整数,x_1, x_2, … x_n,其中 x_i 表示在第 i 天使用的机器的编号。
+ 第三行输出 n 个整数,y_1, y_2, … y_n,其中 y_i 表示在第 i 天交付的订单的编号。
x_i 和 y_i 必须是 1 \sim n 范围内的整数,且每个数字在 x_i, y_i 中恰好出现一次。
对于输出 Yes 的情况,可能有多种合理的方案,你可以输出任意一种。只要你输出的方案是正确且合理的即可得分。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 1 3 3 2 1 1 2 3 | Yes 1 2 3 3 2 1 |
| 2 | 2 5 1 2 3 4 5 2 3 4 5 6 3 10 20 30 15 15 15 | No Yes 2 1 3 1 2 3 |
- 在第一天使用编号为 1 的机器生产了 3 个锣鼓,交付编号为 3 的订单 3 个锣鼓。
- 在第二天使用编号为 2 的机器生产了 2 个锣鼓,交付编号为 2 的订单 2 个锣鼓。
- 在第三天使用编号为 3 的机器生产了 1 个锣鼓,交付编号为 1 的订单 1 个锣鼓。
样例 2 解释
我们解释第二组数据:
- 在第一天使用编号为 2 的机器,生产了 20 个锣鼓。交付编号为 1 的订单 15 个,剩余 5 个;
- 在第二天使用编号为 1 的机器,生产了 10 个锣鼓,加上上一天的 5 个,共 15 个锣鼓,交付编号为 2 的订单 15 个,剩余 0 个。
- 在第三天使用编号为 3 的机器,生产了 30 个锣鼓,共 30 个锣鼓,交付编号为 2 的订单 15 个,剩余 15 个。
提示
样例输出不唯一,仅供参考。
· 先排序,再按「每步取最优」推一遍,验证有没有反例。
· 先把数据读进结构体数组,再按题意写 cmp。
写完后可到洛谷
B3999 对照题解。②编程打卡 · 点一下就能勾选
- 完成 B3928《田忌赛马》,跑通全部样例
- 完成 B3959《做题》,跑通全部样例
- 完成 B4006《宝箱》,跑通全部样例
- 完成 B4041《区间排序》,跑通全部样例
- 完成 B4068《Recamán》,跑通全部样例
- 完成 B4069《字符排序》,跑通全部样例
- 完成 B4416《最长连续段》,跑通全部样例
- 完成 B4580《有序网格》,跑通全部样例
- 完成 B3999《锣鼓工厂》,跑通全部样例
- 对比题解里的参考代码,找出自己写法的差异
结构体与多关键字 · 综合
①本日知识点 · 结构体与多关键字 · 综合
本组 5 道题全部来自 GESP 真题,按「结构体与多关键字 · 综合」归在一起练。题面取洛谷原题(含公式与样例),题解取美力程 GESP 题解库(思路 + 参考代码 + 复杂度)。
热爱学习的小明通过搜索,发现了一种正整数的变长编码方式。这种编码方式的规则如下:
1. 对于给定的非负整数,首先将其表达为二进制形式。例如,(0)_{{10}}=(0)_{{2}},(926)_{{10}}=(1110011110)_{{2}}。
2. 将二进制数从低位到高位切分成每组 7 bit,不足 7bit 的在高位用 0 填补。例如,(0)_{{2}} 变为0000000 的一组,(1110011110)_{{2}} 变为 0011110 和 0000111 的两组。
3. 由代表低位的组开始,为其加入最高位。如果这组是最后一组,则在最高位填上 0,否则在最高位填上 1。于是,0 的变长编码为 00000000 一个字节, 926 的变长编码为 10011110 和 00000111 两个字节。
这种编码方式可以用更少的字节表达比较小的数,也可以用很多的字节表达非常大的数。例如,987654321012345678 的二进制为 (0001101 1011010 0110110 1001011 1110100 0100110 1001000 0010110 1001110)_{{2}},于是它的变长编码为(十六进制表示) CE 96 C8 A6 F4 CB B6 DA 0D,共 9 个字节。
你能通过编写程序,找到一个正整数的变长编码吗?
A-F 使用大写字母表示),两个字节间以空格分隔。| # | 输入 | 输出 |
|---|---|---|
| 1 | 0 | 00 |
| 2 | 926 | 9E 07 |
| 3 | 987654321012345678 | CE 96 C8 A6 F4 CB B6 DA 0D |
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
一种正整数的变长编码方式,规则如下:
把非负整数写成二进制形式,例如 (926)₁₀ = (1110011110)₂
从低位到高位每 7 bit 切一组,不足 7 bit 的高位补 0
由代表低位的组开始,给每组加一个最高位:最后一组(最高位组)补 0,其余组补 1
例:0 编码为 00000000(1 字节);926 编码为 10011110 和 00000111(2 字节)。
输出用两位大写十六进制表示每个字节,空格分隔。
💡人话翻译:核心就是"按 7 位切块"。每个字节留出最高位当作"还有下一块吗"的标志位:还有就写 1,是最后一块就写 0。这样做的好处是:小数字只需 1 个字节,大数字可以扩展到多个字节。
🔍 关键词提取
位运算7 bit 分组续位标志十六进制输出
已知条件
项目说明
输入第一行 N;随后 N 行每行一个非负整数
输出每行一个变长编码,两位大写十六进制、空格分隔
数据范围N ≤ 100
数值范围非负整数(示例含 9 × 10¹⁷ 量级)
分组低位在前,每组 7 bit
需要解决的问题
怎么切出 7 bit 一组?x & 0x7F 取低 7 位,x >>= 7 右移 7 位继续
什么时候是最后一组?右移后 x 变成 0 时,当前的组就是最高位组
续位怎么加?非最后一组 | 0x80,最后一组不加
📥 读入
N 个非负整数
0 也要处理
大数用 long long
N ≤ 100
✂️ 切块
x & 0x7F 取低 7 位
x >>= 7 继续
每轮得一个组
x 变 0 时结束
🏷️ 加标志
先得到的组是低位组
非最后一组 | 0x80
最后一组不加标志
输出顺序:低位组在前
🖨️ 输出
每字节两位大写十六进制
字节间用空格分隔
0 输出 00
注意换行
926 的二进制是 1110011110(共 10 位)。
1
第 1 组:取低 7 位
926 & 0x7F = 926 mod 128
926 = 7 × 128 + 30,所以低 7 位是 30
30 的二进制是 0011110
这不是最后一组(因为右移后还不为 0)→ 补 1 → 10011110 = 0x9E
第 1 个字节:9E(低位组)
2
第 2 组:右移 7 位
926 >> 7 = 7
7 的二进制是 0000111(补足 7 位)
右移后 x = 7 >> 7 = 0 → 这是最后一组 → 补 0 → 00000111 = 0x07
第 2 个字节:07(最高位组)
3
拼接输出
低位组在前 → 输出顺序为 9E 然后 07
✅ 结果 "9E 07"
步骤x 的值x & 0x7F是否最后一组加标志后十六进制
第 1 组92630(0011110)否(右移后为 7 ≠ 0)100111109E
第 2 组77(0000111)是(右移后为 0)0000011107
输出:9E 07 ✓
🧮 几个特殊值
输入二进制分组情况编码结果
00只有一组(全 0)00
11一组 000000101
1271111111一组 1111111,是最后一组 → 011111117F
12810000000低 7 位 = 0,高位 = 1 → 两组80 01
9261110011110两组9E 07
1
重点看 0 和 127
0:切不出任何组(x 一开始就是 0)
按规则要输出一个全 0 字节 → 00
127:正好 7 位全是 1
它是唯一一组(也是最后一组)→ 最高位补 0 → 01111111 = 0x7F
✅ 特判 0 很关键
2
重点看 128
128 = 10000000(8 位)
低 7 位 = 0000000 = 0,不是最后一组 → 10000000 = 0x80
右移 7 位后 x = 1 → 是最后一组 → 0000001 = 0x01
✅ 输出 "80 01"
⚠️0 必须特判:如果直接写 while (x > 0) 循环,x = 0 时一次都不执行,会输出空行。正确做法是先塞入一个 0 组,或者单独判断"若 x == 0 则输出 00"。
🟢 位运算直接切分(推荐) 推荐
用 &0x7F 和 >>7 循环取出各组
时间 O(组数)
代码 10 行
不需要字符串转换
处理大数也轻松
💡核心循环:while (true) { int g = x & 0x7F; x >>= 7; if (x) push(g | 0x80); else { push(g); break; } }——先取低位、再看是否还有,顺序天然正确。
🟠 先转二进制字符串再切
把数转成 01 串,按 7 位切分后加标志
需要手写进制转换
字符串拼接容易出错
代码长一倍
大数处理更麻烦
⚠️结论:位运算直接表达了"取低 7 位"这个意图,是这类题的正解思路。转成字符串再切反而绕远路。
📈 性能对比
方案代码量大数友好度
位运算约 10 行高
字符串约 25 行中
每行输入一个非负整数,程序会展示 7 bit 分组过程与编码结果。
输入整数(每行一个)0
1
127
128
926
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
int main() {
int n;
scanf("%d", &n);
while (n--) {
unsigned long long x;
scanf("%llu", &x);
vector<int> bytes; // 存放各字节(低位组在前)
if (x == 0) {
bytes.push_back(0); // 0 特判:输出一个全 0 字节
} else {
while (true) {
int g = x & 0x7F; // 取低 7 位
x >>= 7; // 右移 7 位
if (x != 0) {
bytes.push_back(g | 0x80); // 不是最后一组,最高位补 1
} else {
bytes.push_back(g); // 是最后一组,最高位补 0
break;
}
}
}
// 输出:两位大写十六进制,空格分隔
for (int i = 0; i < (int)bytes.size(); i++) {
if (i) printf(" ");
printf("%02X", bytes[i]);
}
printf("\n");
}
return 0;
}
🔑为什么用 while (true) 而不是 while (x > 0)?因为我们需要在取完最后一组之后再判断一次(用来决定最高位补 0 还是补 1)。如果写成 while (x > 0),就无法区分"当前组是不是最后一组"。while (true) + 内部 break 的写法让判断位置更自然。
📖 关键几行怎么看
代码作用为什么这样写
x & 0x7F取低 7 位0x7F = 0b1111111
x >>= 7右移 7 位把已处理的 7 位丢掉
g | 0x80补续位 10x80 = 0b10000000,置最高位
printf("%02X", ...)输出十六进制%02X 表示至少两位、不足补 0、大写
⚠️三个坑:① 忘记特判 x == 0(会输出空行);② 输出顺序搞反(应该是低位组先输出);③ 用 %02x 小写输出(题目要求大写,用 %02X)。
写完程序后,用这些数据自查一遍:
输入答案考察点
000零值特判
101最小正整数
1277F恰好 7 位全 1,最高位补 0
12880 01刚好多出一位,需要两组
9269E 07题面样例
255FF 01八位全 1
✅自查清单:① 0 处理了吗?② 低位组在前吗?③ 十六进制是大写吗?
🚨 易错点清单
⚠️忘记特判 0:while (x > 0) 会让 0 输出空行,应输出 00。
⚠️输出顺序错:应从低位组开始输出(先输出 9E 再输出 07)。
⚠️大小写错:题目要求大写十六进制,C++ 用 %02X(大写的 X)。
时间复杂度
O(组数)
空间复杂度
O(组数)
每组
7 bit
组数
约 位数 / 7
时间怎么算的?
每次循环处理 7 位
一个 64 位整数最多 10 组
N ≤ 100 时总共至多 1000 次循环
空间都用在哪?
需要保存各字节(最多 10 个)。
✅ 运算量极小,瞬间完成。这题考的是"位运算 + 续位标志"的编码思路,不是效率。
// 位运算常用掩码
// 0x7F = 0b01111111 取低 7 位
// 0x80 = 0b10000000 置最高位为 1
// 0xFF = 0b11111111 一个字节
// 十六进制输出格式
printf("%02X", v); // 至少 2 位、大写、不足补 0
printf("%02x", v); // 小写版本
printf("%X", v); // 不补 0
// 类似的"变长/前缀"编码思想
// - UTF-8:用字节高位的连续 1 的个数表示"这个字符占几个字节"
// - 7-bit 变长整数(protobuf varint):每字节低 7 位是数据、最高位是续位标志
// 本题就是 varint 编码!
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
掩码取位& 0x7F、>>= 7位运算、编码解码、状态压缩
续位标志最高位表示"还有下一块"varint、UTF-8 等变长编码
十六进制格式化%02X所有需要固定宽度十六进制输出的题
🌟思考题:本题的编码其实就是工业界广泛使用的 varint(变长整数)编码(protobuf 就用它压缩整数)。如果给你一串编码后的字节,你能解码回原来的整数吗?(提示:从第一个字节开始,若最高位是 1 就继续读下一个字节,每读完一个字节就把它的低 7 位拼到结果的低位方向,直到遇到最高位为 0 的字节为止。这就是"编码的逆运算"。)
#include <bits/stdc++.h>
using namespace std;
int main() {
int n;
scanf("%d", &n);
while (n--) {
unsigned long long x;
scanf("%llu", &x);
vector<int> bytes; // 存放各字节(低位组在前)
if (x == 0) {
bytes.push_back(0); // 0 特判:输出一个全 0 字节
} else {
while (true) {
int g = x & 0x7F; // 取低 7 位
x >>= 7; // 右移 7 位
if (x != 0) {
bytes.push_back(g | 0x80); // 不是最后一组,最高位补 1
} else {
bytes.push_back(g); // 是最后一组,最高位补 0
break;
}
}
}
// 输出:两位大写十六进制,空格分隔
for (int i = 0; i < (int)bytes.size(); i++) {
if (i) printf(" ");
printf("%02X", bytes[i]);
}
printf("\n");
}
return 0;
}// 位运算常用掩码 // 0x7F = 0b01111111 取低 7 位 // 0x80 = 0b10000000 置最高位为 1 // 0xFF = 0b11111111 一个字节 // 十六进制输出格式 printf("%02X", v); // 至少 2 位、大写、不足补 0 printf("%02x", v); // 小写版本 printf("%X", v); // 不补 0 // 类似的"变长/前缀"编码思想 // - UTF-8:用字节高位的连续 1 的个数表示"这个字符占几个字节" // - 7-bit 变长整数(protobuf varint):每字节低 7 位是数据、最高位是续位标志 // 本题就是 varint 编码!
接下来 n 行,每行两个正整数 h_i 和 w_i,分别表示第 i 位同学的身高和体重。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 5 1 60 3 70 2 80 4 55 4 50 | 8 |
| 2 | 5 4 0 4 0 2 0 3 0 1 0 | 1 |
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
体育课上有 n 名同学排成一队,第 i 位同学身高 hᵢ、体重 wᵢ。老师希望同学们按身高从高到低排队,身高相同则按体重从重到轻排序。
调整时每次只能交换相邻两位同学的位置。求最少需要多少次交换操作。
💡人话翻译:这是一个经典结论题——"只允许交换相邻元素,把序列变成目标顺序所需的最少次数"恰好等于逆序对的个数。所以我们要做两件事:① 确定每个人的目标位置;② 数出原序列相对目标顺序的逆序对。
🔍 关键词提取
相邻交换逆序对稳定排序目标位置映射
已知条件
项目说明
输入第一行 n;随后 n 行每行 hᵢ、wᵢ
输出最少相邻交换次数
数据范围1 ≤ n ≤ 3000
数值范围0 ≤ hᵢ, wᵢ ≤ 10⁹
目标顺序身高降序 → 体重降序
需要解决的问题
为什么是逆序对?每交换一次相邻元素,恰好消除一个逆序对;每次交换最多消除一个——所以最少次数 = 逆序对数
目标位置怎么定?对 (h, w) 按降序稳定排序,每个人就得到了唯一的目标位次
同身高同体重怎么办?必须按原顺序排(稳定排序),这样才能得到最少交换次数
🧠 核心结论
相邻交换一次消除一个逆序对
最少交换次数 = 逆序对数
这是本题的理论依据
必须能自己说明
🎯 定目标位次
按 (h 降序, w 降序) 排序
相同则按原下标升序(稳定)
rank[id] = 目标位次
保证得到最小解
🔍 数逆序对
把原序映射成 rank 序列
统计 i < j 且 B[i] > B[j] 的对数
n ≤ 3000 → O(n²) 可行
9 × 10⁶ 次比较
⚠️ 易错点
排序不稳定导致答案偏大
h、w 用 int 存(会溢出)
位次数组下标搞错
相等元素的处理
原队伍(按输入顺序):
原下标身高 h体重 w
1160
2370
3280
4455
5450
1
第 1 步:按 (h 降序, w 降序) 排序
h 最大的是 4(两人):4 号 w = 55、5 号 w = 50
w 降序 → 4 号在前、5 号在后
接着是 h = 3 的 2 号、h = 2 的 3 号、h = 1 的 1 号
目标顺序:4号、5号、2号、3号、1号
目标队伍已确定
2
第 2 步:给每人标目标位次
4 号 → 第 1 位;5 号 → 第 2 位
2 号 → 第 3 位;3 号 → 第 4 位;1 号 → 第 5 位
所以 rank[1] = 5、rank[2] = 3、rank[3] = 4、rank[4] = 1、rank[5] = 2
位次数组已建好
3
第 3 步:按原顺序写出位次序列
原序 1、2、3、4、5 对应位次:5、3、4、1、2
序列 B = [5, 3, 4, 1, 2]
B = [5, 3, 4, 1, 2]
4
第 4 步:数逆序对
5 > 3、4、1、2 → 4 个
3 > 1、2 → 2 个
4 > 1、2 → 2 个
1、2 后面没有更小的 → 0 个
合计 4 + 2 + 2 = 8
✅ 输出 8
最少交换 8 次 ✓
🧮 样例 2:答案 1(考察稳定排序)
数据:4 0 / 4 0 / 2 0 / 3 0 / 1 0,其中有两个完全相同的 (4, 0)。
原下标(h, w)目标位次说明
1(4, 0)1与 2 号完全相同 → 按原顺序,1 号在前
2(4, 0)2与 1 号完全相同 → 2 号在后
3(2, 0)4
4(3, 0)3
5(1, 0)5
1
位次序列
按原顺序 1 ~ 5:位次是 1、2、4、3、5
B = [1, 2, 4, 3, 5]
B = [1, 2, 4, 3, 5]
2
数逆序对
1 后面都比它大 → 0
2 后面都比它大 → 0
4 > 3 → 1 个
3、5 后面没有更小的 → 0
✅ 输出 1
🔑如果排序不稳定会怎样?假设把两个 (4, 0) 的位次互换了,位次序列会变成 [2, 1, 4, 3, 5],逆序对变成 1(2>1)+ 1(4>3)= 2,比正确答案多 1。因为"把 1 号同学换到 2 号后面"完全是多余的操作。相同元素必须保持原相对顺序(稳定排序),才能得到最少交换次数。
🟢 双重循环 O(n²)(推荐) 推荐
对每个 i,统计后面有多少个比它小的
时间 O(n²)
n = 3000 时约 4.5 × 10⁶ 次
代码 5 行
不需要额外数据结构
💡为什么够用:n ≤ 3000,双重循环最多约 450 万次比较,C++ 一秒能跑上亿次,完全不用优化。
🟠 树状数组 / 归并排序 O(n log n)
用数据结构在 O(n log n) 内统计逆序对
时间 O(n log n)
代码复杂(30 ~ 50 行)
需要离散化(h、w 可达 10⁹)
本题属于过度设计
⚠️什么时候必须用:当 n 达到 10⁵ 时,O(n²) 会超时(10¹⁰ 次),那时必须用树状数组或归并排序。本题 n ≤ 3000 是"善意提示"——直接暴力即可。
📈 性能对比
方案本题运算量n = 10⁵ 时
双重循环约 4.5 × 10⁶约 5 × 10⁹(超时)
树状数组约 4.5 × 10⁴约 1.7 × 10⁶(可行)
第一行输入 n,随后 n 行每行两个数(身高 体重)。程序会给出目标位次与逆序对数。
输入数据5
1 60
3 70
2 80
4 55
4 50
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
struct Stu {
long long h, w;
int id; // 原下标(1 起)
};
// 目标顺序:身高降序 → 体重降序 → 原下标升序(决定稳定性)
bool cmp(const Stu &a, const Stu &b) {
if (a.h != b.h) return a.h > b.h;
if (a.w != b.w) return a.w > b.w;
return a.id < b.id;
}
Stu s[3005];
int rankOf[3005]; // rankOf[id] = 该同学的目标位次
int main() {
int n;
scanf("%d", &n);
for (int i = 1; i <= n; i++) {
scanf("%lld %lld", &s[i].h, &s[i].w);
s[i].id = i;
}
// 排序后依次给出目标位次
sort(s + 1, s + n + 1, cmp);
for (int i = 1; i <= n; i++) rankOf[s[i].id] = i;
// 按原顺序写出位次序列,统计逆序对
long long ans = 0;
for (int i = 1; i <= n; i++) {
for (int j = i + 1; j <= n; j++) {
if (rankOf[i] > rankOf[j]) ans++;
}
}
printf("%lld\n", ans);
return 0;
}
🔑为什么"稳定"能保证最少?两个完全相同的同学(身高体重都一样)互换位置毫无意义,交换它们只会白白增加次数。所以让它们保持原来的相对顺序(即 id 升序)就能避免这些多余交换,从而得到最小值。比较函数里最后一行 return a.id < b.id; 就是稳定性的来源。
📖 关键几行怎么看
代码作用为什么这样写
return a.h > b.h;身高降序用 > 实现从高到低
return a.id < b.id;保证稳定相同元素按原序,避免多余交换
rankOf[s[i].id] = i;记录目标位次排序后第 i 个位置,就是该同学的目标位次
if (rankOf[i] > rankOf[j]) ans++;数逆序对i < j 但位次 i 更大,说明两人顺序反了
⚠️三个坑:① 排序时不加 id 比较,相同元素顺序随机,答案可能偏大;② h、w 可达 10⁹,必须用 long long(虽然本题只做比较不会溢出,但养成习惯);③ 把"位次序列"和"原序列"搞混,导致统计对象错误。
写完程序后,用这些数据自查一遍:
输入答案考察点
5
1 60 / 3 70 / 2 80 / 4 55 / 4 508题面样例 1
5
4 0 / 4 0 / 2 0 / 3 0 / 1 01题面样例 2(考察稳定排序)
1
5 50只有一人,无需交换
3
3 1 / 2 1 / 1 10已经是从高到低,无需交换
3
1 1 / 2 1 / 3 13完全逆序,3 人需要 3 次
4
2 1 / 2 1 / 2 1 / 2 10全部相同,保持原顺序即可
✅自查清单:① 排序键是 (h 降序, w 降序, id 升序) 吗?② 位次序列是按原顺序取的吗?③ 统计的是逆序对吗?
🚨 易错点清单
⚠️排序不稳定:不比较原下标,相同元素顺序不确定,答案可能偏大(样例 2 会输出 2 而不是 1)。
⚠️忘了逆序对这个结论:不要真去模拟交换过程,那样复杂度是 O(n²) 的交换次数,逻辑上也更难写对。
⚠️位次映射搞反:应该是rankOf[原下标] = 目标位次,不是反过来。
时间复杂度
O(n²)
空间复杂度
O(n)
n 最大
3000
最坏运算
约 4.5 × 10⁶
时间怎么算的?
排序:O(n log n)
统计逆序对:O(n²)
n = 3000 时约 3000 × 3000 / 2 = 4.5 × 10⁶ 次
空间都用在哪?
需要存下 n 个同学和 n 个位次。
✅ 约 450 万次比较,C++ 瞬间完成。n ≤ 3000 这个范围,正是为了让我们可以放心用 O(n²)。
// 结论:只允许相邻交换时,最少交换次数 = 逆序对数量
// 证明思路:
// (1) 每次相邻交换最多让逆序对减少 1(交换相邻两元素只影响它们之间这一对)
// (2) 只要还不是有序,就一定存在相邻逆序对,交换它可让逆序对减少 1
// (3) 所以下界可达 -> 最少次数恰好是逆序对数
// 逆序对统计:O(n^2)
long long cnt = 0;
for (int i = 0; i < n; i++)
for (int j = i + 1; j < n; j++)
if (a[i] > a[j]) cnt++;
// 逆序对统计:归并排序 O(n log n)(n 很大时用)
long long mergeCount(vector<int> &v, int l, int r) { /* 分治统计 */ }
// 逆序对统计:树状数组 O(n log n)(需离散化)
// 把值域压缩到 [1, n] 后,用 BIT 统计"已出现的比我大的数的个数"
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
逆序对相邻交换的最少次数排队、卡片排序、最少交换问题
稳定排序相同元素保持原序所有涉及"相同元素不该交换"的题
目标位次映射原下标 ↔ 位次排列变位、置换类问题
🌟思考题:如果题目改成"允许交换任意两位(不限于相邻)",最少交换次数是多少?(提示:那种情况下答案是 n 减去"置换环的个数",与逆序对无关——所以"是否限制相邻"会完全改变解法。)
#include <bits/stdc++.h>
using namespace std;
struct Stu {
long long h, w;
int id; // 原下标(1 起)
};
// 目标顺序:身高降序 → 体重降序 → 原下标升序(决定稳定性)
bool cmp(const Stu &a, const Stu &b) {
if (a.h != b.h) return a.h > b.h;
if (a.w != b.w) return a.w > b.w;
return a.id < b.id;
}
Stu s[3005];
int rankOf[3005]; // rankOf[id] = 该同学的目标位次
int main() {
int n;
scanf("%d", &n);
for (int i = 1; i <= n; i++) {
scanf("%lld %lld", &s[i].h, &s[i].w);
s[i].id = i;
}
// 排序后依次给出目标位次
sort(s + 1, s + n + 1, cmp);
for (int i = 1; i <= n; i++) rankOf[s[i].id] = i;
// 按原顺序写出位次序列,统计逆序对
long long ans = 0;
for (int i = 1; i <= n; i++) {
for (int j = i + 1; j <= n; j++) {
if (rankOf[i] > rankOf[j]) ans++;
}
}
printf("%lld\n", ans);
return 0;
}// 结论:只允许相邻交换时,最少交换次数 = 逆序对数量
// 证明思路:
// (1) 每次相邻交换最多让逆序对减少 1(交换相邻两元素只影响它们之间这一对)
// (2) 只要还不是有序,就一定存在相邻逆序对,交换它可让逆序对减少 1
// (3) 所以下界可达 -> 最少次数恰好是逆序对数
// 逆序对统计:O(n^2)
long long cnt = 0;
for (int i = 0; i < n; i++)
for (int j = i + 1; j < n; j++)
if (a[i] > a[j]) cnt++;
// 逆序对统计:归并排序 O(n log n)(n 很大时用)
long long mergeCount(vector<int> &v, int l, int r) { /* 分治统计 */ }
// 逆序对统计:树状数组 O(n log n)(需离散化)
// 把值域压缩到 [1, n] 后,用 BIT 统计"已出现的比我大的数的个数"小 A 的购物策略为:
- 总是优先买优先级最高的东西;
- 如果有多个最高优先级商品,购买价格最低的;
- 如果有多个优先级最高且价格最低的商品,购买商品名字典序最小的。
小 A 想知道能购买哪些商品。
之后 N 行,每行一个商品,依次为 S_i P_i V_i,代表第 i 个商品的商品名、价格、优先级。
数据保证不存在两个名字相同的商品。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 20 4 apple 6 8 bus 15 1 cab 1 10 water 4 8 | bus cab water |
对于所有测试点,保证 1 ≤q |S_i| ≤q 10,1 ≤q M, P_i ≤q 10^5,1 ≤q N ≤q 10^3,1 ≤q V_i ≤q 10。商品名仅由小写字母组成且不存在两个相同的商品名。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
小 A 有 M 元预算。商店有 N 个商品,每个商品有名字 S、价格 P、优先级 V 三个属性,V 越小优先级越高。购物策略为:
总是优先买优先级最高的商品
若有多个最高优先级,买价格最低的
若仍相同,买名字字典序最小的
请按字典序从小到大输出所有买到的商品名。
💡人话翻译:把商品按 (V, P, 名字) 三级排序,然后从头到尾扫一遍,买得起就买、买不起就跳过。注意输出要按名字字典序,不是按购买顺序。
🔍 关键词提取
多关键字排序贪心预算约束字典序输出
已知条件
项目说明
输入第一行 M、N;随后 N 行每行 S、P、V
输出买到的商品名,按字典序升序,每行一个
数据范围N ≤ 1000,M, P ≤ 10⁵
优先级1 ≤ V ≤ 10,V 越小越优先
保证商品名互不相同,仅含小写字母,长度 ≤ 10
需要解决的问题
购买顺序怎么定?按 (V 升序, P 升序, 名字升序) 排序
怎么决定买不买?依次扫描,买得起(M ≥ P)就买、预算减去 P
为什么一趟扫描就够?因为排序顺序不变,"当前买得起的最优商品"永远排在未处理序列的最前面
📥 读入
M 元预算
N 个商品(名、价、优先级)
V 越小越优先
名字互不相同
⚖️ 排序键
第一关键字 V 升序
第二关键字 P 升序
第三关键字 名字字典序
用结构体 + cmp
💰 贪心购买
按排序顺序扫描
M ≥ P 就买
预算减去 P
买不起就跳过
📤 输出
收集买到的商品名
再按名字字典序排序
每行一个
注意输出顺序≠购买顺序
商品列表:
商品名价格 P优先级 V
apple68
bus151
cab110
water48
第一步:按 (V, P, 名字) 排序
排序后顺序商品VP说明
1bus115V 最小,优先级最高
2water84V 相同比价格,4 < 6
3apple86与 water 同 V,价格更大
4cab101V 最大,排最后
第二步:依次决定买不买
1
第 1 个:bus(15 元)
预算 20 ≥ 15 → 买
预算变为 20 − 15 = 5
已买:bus
2
第 2 个:water(4 元)
预算 5 ≥ 4 → 买
预算变为 5 − 4 = 1
已买:bus、water
3
第 3 个:apple(6 元)
预算 1 < 6 → 买不起,跳过
跳过
4
第 4 个:cab(1 元)
预算 1 ≥ 1 → 买
预算变为 0
已买:bus、water、cab
第三步:按字典序输出
买到的商品是 bus、water、cab,按名字字典序排列:bus、cab、water。
bus
cab
water
🔑两个容易忽略的点:① 输出顺序是名字字典序,不是购买顺序(购买顺序是 bus、water、cab);② 排序键用 V 作第一关键字,所以在样例里最贵的 bus(15 元)反而最先被考虑——"优先级"比"价格"重要得多。
🟢 排序 + 一趟扫描(推荐) 推荐
按 (V,P,名字) 排序,然后顺序扫描买得起的
时间 O(N log N)
一次排序一次扫描
代码简短
无需重复查找
💡为什么一趟扫描等价于"每轮重新找最优"?因为排序顺序是固定的,被跳过的商品在后续轮次里依然排在同一位置,所以"当前买得起的最优商品"就是排序序列里第一个未处理且买得起的。
🟠 每轮重新扫描找最优
每买一件就重新遍历全部商品找当前最优
时间 O(N²)
N = 1000 时 10⁶ 次,也能过
逻辑更贴近题面描述
但代码更啰嗦
⚠️都能过:N ≤ 1000 时即使 O(N²) 也够快。但从写法上看,排序法更简洁,也更容易理解"策略"的本质。
📈 性能对比
方案复杂度代码量
排序 + 扫描O(N log N)约 25 行
每轮重扫O(N²)约 30 行
第一行输入 M 和 N,随后 N 行每行一个商品(名字 价格 优先级)。
输入数据20 4
apple 6 8
bus 15 1
cab 1 10
water 4 8
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
struct Good {
string name;
int p; // 价格
int v; // 优先级(越小越优先)
};
// 三级排序:优先级 -> 价格 -> 名字字典序
bool cmp(const Good &a, const Good &b) {
if (a.v != b.v) return a.v < b.v;
if (a.p != b.p) return a.p < b.p;
return a.name < b.name; // string 自带字典序比较
}
int main() {
int M, N;
scanf("%d %d", &M, &N);
vector<Good> g(N);
for (int i = 0; i < N; i++) {
char buf[20];
scanf("%s %d %d", buf, &g[i].p, &g[i].v);
g[i].name = buf;
}
sort(g.begin(), g.end(), cmp);
vector<string> bought;
for (int i = 0; i < N; i++) {
if (M >= g[i].p) { // 买得起就买
M -= g[i].p;
bought.push_back(g[i].name);
}
}
sort(bought.begin(), bought.end()); // 输出要求按字典序
for (const string &s : bought) printf("%s\n", s.c_str());
return 0;
}
🔑为什么最后还要再排一次序?购买顺序是按"优先级"排的,而输出要求按"商品名字典序",这两个顺序完全不同,所以买完之后要把名字单独排序再输出。
📖 关键几行怎么看
代码作用为什么这样写
if (a.v != b.v) return a.v < b.v;优先级最高V 越小越优先,所以升序
return a.name < b.name;字典序C++ 的 string 直接用 < 就是字典序
if (M >= g[i].p)买得起判断注意每买一件预算就减少
sort(bought.begin(), bought.end())输出前排序输出要求字典序,与购买顺序无关
⚠️三个坑:① 直接把购买顺序当输出顺序(样例里购买顺序是 bus、water、cab,但输出必须是 bus、cab、water);② 排序时把价格当成第一关键字(应该优先级优先);③ 忘记更新预算,导致后面错误地多买。
写完程序后,用这些数据自查一遍:
输入答案考察点
20 4
apple 6 8 / bus 15 1 / cab 1 10 / water 4 8bus
cab
water题面样例
5 1
pen 6 1(无输出)预算不够,一件都买不起
10 2
b 1 1 / a 1 1a
b优先级价格都相同,按名字字典序先买 a
3 3
x 1 3 / y 1 2 / z 1 1x
y按优先级买 z、y,预算只剩 1,x 买不起
100 2
aa 5 1 / ab 5 1aa
ab同优先级同价格,名字小者优先买,但最终输出按字典序
✅自查清单:① 排序键是 V → P → 名字吗?② 每买一件都扣钱了吗?③ 输出按字典序排了吗?
🚨 易错点清单
⚠️输出顺序错:必须是名字字典序,不是购买顺序。
⚠️排序键顺序错:优先级是第一关键字,价格是第二关键字,不能颠倒。
⚠️忘记扣预算:每买一件都要 M -= p,否则会把后面买不起的也买下来。
时间复杂度
O(N log N)
空间复杂度
O(N)
N 最大
1000
预算 M
≤ 10⁵
时间怎么算的?
排序 O(N log N)
扫描购买 O(N)
输出前再排序 O(N log N)
合计仍是 O(N log N)
空间都用在哪?
需要存 N 个商品和购买清单。
✅ N 只有 1000,排序开销极小,瞬间完成。
// 字符串字典序比较
if (a.name < b.name) { /* a 在前 */ } // C++ string 直接用 < 比较
// C 风格字符串需要用 strcmp
if (strcmp(a, b) < 0) { /* a 在前 */ }
// 多关键字排序 + 输出前重排的通用套路
sort(goods.begin(), goods.end(), cmpBuyOrder); // 按购买优先级排序
vector<string> chosen;
for (auto &x : goods) if (budget >= x.price) { budget -= x.price; chosen.push_back(x.name); }
sort(chosen.begin(), chosen.end()); // 按输出要求重新排序
// 贪心的常见前提
// 只要"选择顺序"与"资源消耗"单调相关,一趟扫描就等价于反复挑最优
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
多关键字排序优先级 → 价格 → 名字电商推荐、任务调度、排行榜
贪心购买顺序扫描,买得起就买预算分配、背包简化版
输出顺序重排购买顺序 ≠ 输出顺序所有"按规则选、按要求输出"的题
🌟思考题:如果题目改成"买到的商品总数最多"(忽略优先级,只要求件数最多),策略要怎么变?(提示:那就应该优先买最便宜的,此时排序键要换成"价格升序",这是经典的贪心结论。)
bus cab water
#include <bits/stdc++.h>
using namespace std;
struct Good {
string name;
int p; // 价格
int v; // 优先级(越小越优先)
};
// 三级排序:优先级 -> 价格 -> 名字字典序
bool cmp(const Good &a, const Good &b) {
if (a.v != b.v) return a.v < b.v;
if (a.p != b.p) return a.p < b.p;
return a.name < b.name; // string 自带字典序比较
}
int main() {
int M, N;
scanf("%d %d", &M, &N);
vector<Good> g(N);
for (int i = 0; i < N; i++) {
char buf[20];
scanf("%s %d %d", buf, &g[i].p, &g[i].v);
g[i].name = buf;
}
sort(g.begin(), g.end(), cmp);
vector<string> bought;
for (int i = 0; i < N; i++) {
if (M >= g[i].p) { // 买得起就买
M -= g[i].p;
bought.push_back(g[i].name);
}
}
sort(bought.begin(), bought.end()); // 输出要求按字典序
for (const string &s : bought) printf("%s\n", s.c_str());
return 0;
}// 字符串字典序比较
if (a.name < b.name) { /* a 在前 */ } // C++ string 直接用 < 比较
// C 风格字符串需要用 strcmp
if (strcmp(a, b) < 0) { /* a 在前 */ }
// 多关键字排序 + 输出前重排的通用套路
sort(goods.begin(), goods.end(), cmpBuyOrder); // 按购买优先级排序
vector<string> chosen;
for (auto &x : goods) if (budget >= x.price) { budget -= x.price; chosen.push_back(x.name); }
sort(chosen.begin(), chosen.end()); // 按输出要求重新排序
// 贪心的常见前提
// 只要"选择顺序"与"资源消耗"单调相关,一趟扫描就等价于反复挑最优现在需要对这些礼盒进行排序,排序规则如下:
1. 先按礼盒总价格从小到大排序;
2. 如果总价格相同,按礼盒中最贵商品的价格从小到大排序;
3. 如果仍然相同,按礼盒中最便宜商品的价格从小到大排序;
4. 如果仍然相同,按礼盒编号从小到大排序。
请输出排序后的礼盒编号。
接下来 n 行,每行包含 k 个整数,第 i 行表示第 i 个礼盒中各商品的价格。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 4 3 3 5 2 4 1 5 2 2 4 3 4 3 | 3 4 2 1 |
| 编号 | 商品价格 | 总价 | 最大值 | 最小值 |
| :-: | :-: | :-: | :-: | :-: |
| 1 | 3 5 2 | 10 | 5 | 2 |
| 2 | 4 1 5 | 10 | 5 | 1 |
| 3 | 2 2 4 | 8 | 4 | 2 |
| 4 | 3 4 3 | 10 | 4 | 3 |
排序过程:
1. 按总价排序,3 号礼盒总价最小;
2. 其余总价均为 10,再按最大值排序,4 号最大值更小;
3. 1 号和 2 号最大值相同,再按最小值排序,2 号更小。
最终顺序为:3 4 2 1
数据范围
保证 1 ≤q n ≤q 10^3,1 ≤q k ≤q 10,1 ≤q 商品价格 ≤q 10^4。
💡 查看题解(思路 + 参考代码 + 复杂度) 美力程 GESP 题解库
每个礼盒包含 k 件商品。请按以下规则给礼盒排序,输出排序后的礼盒编号:
先按礼盒总价格从小到大
总价相同则按最贵商品价格从小到大
还相同则按最便宜商品价格从小到大
仍相同则按礼盒编号从小到大
💡人话翻译:这是一种"多关键字排序"。思路很固定:把四个比较关键字都算出来存进结构体,然后写一个比较函数,按优先级依次比较。第 4 条用编号兜底,保证不会出现"分不出先后"的情况。
🔍 关键词提取
多关键字排序结构体 + 比较函数总和/最大值/最小值
已知条件
项目说明
输入第一行 n、k;随后 n 行每行 k 个价格
输出排序后的礼盒编号(从 1 开始),空格分隔
数据范围n ≤ 1000,k ≤ 10
价格范围1 ≤ 价格 ≤ 10⁴
排序键总价 → 最高价 → 最低价 → 编号
需要解决的问题
排序键怎么存?结构体里放 sum、mx、mn、id 四个字段
比较函数怎么写?用 if 链依次比较,越靠前的关键字优先级越高
为什么最后要按编号?让排序有唯一确定的结果,同时保证算法稳定
📥 读入统计
读 n、k
每行读 k 个价格
同时算 sum/mx/mn
编号从 1 开始
🧮 四个键
sum:盒内总价
mx:最贵商品
mn:最便宜商品
id:礼盒编号
⚖️ 比较顺序
先比 sum 小者优先
再比 mx 小者优先
再比 mn 小者优先
最后比 id 小者优先
📤 输出
排序后只输出编号
空格分隔
行末不加空格
n ≤ 1000 用 sort 即可
先把每个礼盒的三个统计量算出来。
编号商品价格总价 sum最贵 mx最便宜 mn
13 5 21052
24 1 51051
32 2 4842
43 4 31043
1
第 1 级:比总价
3 号总价 8 最小 → 排在第一个
其余三个总价都是 10,需要进入下一级比较
确定第一个:3 号
2
第 2 级:比最贵商品
1 号 mx = 5
2 号 mx = 5
4 号 mx = 4
4 号的 4 最小 → 排在第二位
确定第二个:4 号(mx = 4)
3
第 3 级:比最便宜商品
1 号 mn = 2
2 号 mn = 1
总价、最贵都相同,只能比最低价
2 号的 1 更小 → 排在第三位
确定第三个:2 号(mn = 1)
4
第 4 级:比编号
只剩 1 号一个,直接排在最后
✅ 最终顺序 3 4 2 1
🔑样例里其实没用到第 4 级(前三级就分完了),但编码时必须写上——否则遇到"四个键全相同"的两个礼盒时,排序结果不确定,可能随机出错。用唯一标识(如编号)兜底,是多关键字排序的标准做法。
🧮 一组会用到第 4 级的数据
编号价格summxmn
12 3532
23 2532
💡两个礼盒的三项统计量完全一样,此时只能比编号:1 号排在 2 号前面。如果没有第 4 级,排序结果就不确定了。
🟢 结构体 + 比较函数(推荐) 推荐
把四个键存进结构体,写 cmp 按顺序比较
时间 O(n log n × k)
逻辑与题面一一对应
新增关键字只需加一行
不易出错
💡比较函数模板:if (a.sum != b.sum) return a.sum < b.sum;,依次往下写四个 if,最后一个直接返回编号比较。
🟠 把多键压成一个整数
比如 key = sum×1000 + mx×100 + ...
需要精心设计进制
容易发生溢出或位重叠
价格范围变化就要改
可读性差
⚠️注意:压成一个数确实能直接 sort,但本题四个键的取值范围不同(总价可达 10⁵),很难选一个安全的进制,不推荐。
📈 性能对比
方案代码量可维护性
结构体 + cmp约 25 行⭐⭐⭐⭐⭐
压成单键约 15 行(含位设计)⭐⭐
第一行输入 n 和 k,随后 n 行每行 k 个价格,程序会按四级关键字排序。
输入数据4 3
3 5 2
4 1 5
2 2 4
3 4 3
算一下!
随机出题
结果会显示在这里
点按钮开始 →
include <bits/stdc++.h>
using namespace std;
struct Box {
int id; // 礼盒编号(从 1 开始)
int sum; // 总价
int mx; // 最贵商品
int mn; // 最便宜商品
};
// 四级比较:越靠前的关键字优先级越高
bool cmp(const Box &a, const Box &b) {
if (a.sum != b.sum) return a.sum < b.sum; // 1. 总价小者优先
if (a.mx != b.mx) return a.mx < b.mx; // 2. 最贵商品小者优先
if (a.mn != b.mn) return a.mn < b.mn; // 3. 最便宜商品小者优先
return a.id < b.id; // 4. 编号小者优先
}
int main() {
int n, k;
scanf("%d %d", &n, &k);
vector<Box> v(n);
for (int i = 0; i < n; i++) {
v[i].id = i + 1;
int sum = 0, mx = 0, mn = 100000;
for (int j = 0; j < k; j++) {
int p;
scanf("%d", &p);
sum += p;
if (p > mx) mx = p;
if (p < mn) mn = p;
}
v[i].sum = sum; v[i].mx = mx; v[i].mn = mn;
}
sort(v.begin(), v.end(), cmp);
for (int i = 0; i < n; i++) {
if (i) printf(" ");
printf("%d", v[i].id);
}
printf("\n");
return 0;
}
🔑比较函数为什么能保证正确性?sort 要求比较函数满足"严格弱序":即 cmp(a,b) 为真表示 a 应排在 b 前面。我们按优先级依次比较,第一次出现差异的关键字就决定了顺序,这正是多关键字排序的本质。
📖 关键几行怎么看
代码作用为什么这样写
struct Box打包四个键四个字段一起参与比较,代码清晰
if (a.sum != b.sum) return ...逐级比较只有相等时才进入下一级,用 != 判断不等
return a.id < b.id;兜底保证排序结果唯一确定
mn = 100000初始化最小值价格 ≤ 10⁴,用大数初始化最稳
⚠️两个坑:① 比较函数写成 a.sum <= b.sum,违反严格弱序会导致 sort 行为未定义(可能崩溃);② 忘了第 4 级的编号比较,在四项全相同时排序结果不稳定。
写完程序后,用这些数据自查一遍:
输入答案考察点
4 3
3 5 2 / 4 1 5 / 2 2 4 / 3 4 33 4 2 1题面样例
1 2
5 51只有一个礼盒
2 2
2 3 / 3 21 2统计量完全相同,靠编号决胜
3 1
9 / 5 / 72 3 1k = 1 时 sum = mx = mn
2 2
1 1 / 1 11 2完全相同的数据,编号升序
✅自查清单:① 四个键都算了吗?② 比较用严格小于吗?③ 最后按编号兜底了吗?
🚨 易错点清单
⚠️比较函数用了 <=:必须用严格小于,否则 sort 的行为未定义。
⚠️漏掉编号兜底:四项完全相同时顺序不确定,不同编译器/不同数据集可能给出不同结果。
⚠️最小值初始化为 0:价格都是正整数,用 0 初始化 mn 会导致 mn 永远为 0。
时间复杂度
O(n log n × k)
空间复杂度
O(n)
n 最大
1000
k 最大
10
时间怎么算的?
读入并统计:O(n × k)
排序:O(n log n) 次比较
合计 O(n log n × k),n = 1000 时约 10⁴ 量级
空间都用在哪?
需要存 n 个结构体,每个含 4 个整数。
✅ n 只有 1000,任何排序实现都瞬间完成。
// 多关键字排序的通用写法
struct Node { int a, b, c, id; };
bool cmp(const Node &x, const Node &y) {
if (x.a != y.a) return x.a < y.a; // 第一关键字
if (x.b != y.b) return x.b < y.b; // 第二关键字
if (x.c != y.c) return x.c < y.c; // 第三关键字
return x.id < y.id; // 唯一标识兜底
}
// 用 lambda 写法(C++11 起)
sort(v.begin(), v.end(), [](const Node &x, const Node &y) {
if (x.a != y.a) return x.a < y.a;
if (x.b != y.b) return x.b < y.b;
return x.id < y.id;
});
// 只有两个关键字时可以用 pair / tuple 直接排序
vector<pair<int,int>> p; // 默认先比 first 再比 second
sort(p.begin(), p.end());
🌟 举一反三
把这道题用到的基本功拆出来,它们能迁移到很多同类问题上。
能力点本题怎么用还能迁移到
多关键字排序逐级比较直到分出胜负排行榜、成绩排序、优先级队列
唯一标识兜底用编号/下标保证顺序确定所有需要"稳定确定"的排序
结构体打包把相关字段放一起数据建模、图论建图
🌟思考题:如果题目改成"总价从大到小,但最贵商品价格从小到大"(升降序混合),比较函数该怎么改?(提示:把第一条改成 a.sum > b.sum,其余保持不变即可,每个关键字可以独立选择升降序。)
#include <bits/stdc++.h>
using namespace std;
struct Box {
int id; // 礼盒编号(从 1 开始)
int sum; // 总价
int mx; // 最贵商品
int mn; // 最便宜商品
};
// 四级比较:越靠前的关键字优先级越高
bool cmp(const Box &a, const Box &b) {
if (a.sum != b.sum) return a.sum < b.sum; // 1. 总价小者优先
if (a.mx != b.mx) return a.mx < b.mx; // 2. 最贵商品小者优先
if (a.mn != b.mn) return a.mn < b.mn; // 3. 最便宜商品小者优先
return a.id < b.id; // 4. 编号小者优先
}
int main() {
int n, k;
scanf("%d %d", &n, &k);
vector<Box> v(n);
for (int i = 0; i < n; i++) {
v[i].id = i + 1;
int sum = 0, mx = 0, mn = 100000;
for (int j = 0; j < k; j++) {
int p;
scanf("%d", &p);
sum += p;
if (p > mx) mx = p;
if (p < mn) mn = p;
}
v[i].sum = sum; v[i].mx = mx; v[i].mn = mn;
}
sort(v.begin(), v.end(), cmp);
for (int i = 0; i < n; i++) {
if (i) printf(" ");
printf("%d", v[i].id);
}
printf("\n");
return 0;
}// 多关键字排序的通用写法
struct Node { int a, b, c, id; };
bool cmp(const Node &x, const Node &y) {
if (x.a != y.a) return x.a < y.a; // 第一关键字
if (x.b != y.b) return x.b < y.b; // 第二关键字
if (x.c != y.c) return x.c < y.c; // 第三关键字
return x.id < y.id; // 唯一标识兜底
}
// 用 lambda 写法(C++11 起)
sort(v.begin(), v.end(), [](const Node &x, const Node &y) {
if (x.a != y.a) return x.a < y.a;
if (x.b != y.b) return x.b < y.b;
return x.id < y.id;
});
// 只有两个关键字时可以用 pair / tuple 直接排序
vector<pair<int,int>> p; // 默认先比 first 再比 second
sort(p.begin(), p.end());例如,一个体重为 50 kg,身高为 1.6 m 的人的身高体重指数为 50 kg/1.6 m/1.6 m = 19.53125 kg/m^2。
现在有 n 个小朋友,第 i 个小朋友的编号为 i,体重为 w_i,身高为 h_i。
请按照身高体重指数从高到低为小朋友们排序,数据保证不存在两个小朋友的身高体重指数完全相同。输出排序后小朋友的编号。
第一行为一个正整数 n,表示小朋友的个数;
第二行为 n 个整数 w_1, w_2, …, w_n 表示小朋友们的体重,单位为 kg;
第三行为 n 个浮点数 h_1, h_2, …, h_n 表示小朋友们的身高,单位为 m。
| # | 输入 | 输出 |
|---|---|---|
| 1 | 3 45 33 39 1.55 1.33 1.44 | 3 1 2 |
三个小朋友(编号依次为 1,2,3)的身高体重指数分别为(保留两位小数的结果):18.73,18.66,18.81,故排序后输出的编号为 3 1 2。
数据范围
1 ≤ n ≤ 1000,10 ≤ w_i ≤ 100,0.8 ≤ h_i ≤ 1.9,h_i 均恰有两位小数。
· 先把数据读进结构体数组,再按题意写 cmp。
· 定义末尾别忘分号;访问成员用 . ,指针用 -> 。
写完后可到洛谷
B4558 对照题解。②编程打卡 · 点一下就能勾选
- 完成 B3870《变长编码》,跑通全部样例
- 完成 B4361《排序》,跑通全部样例
- 完成 B4452《优先购买》,跑通全部样例
- 完成 B4502《礼盒排序》,跑通全部样例
- 完成 B4558《身高体重指数》,跑通全部样例
- 对比题解里的参考代码,找出自己写法的差异
四级模拟自测卷
- 1.B 返回 3×2
- 2.B 改的是副本
- 3.A x 是实参的别名
- 4.B 漏分号是编译错误
- 5.B 指针用箭头
- 6.B 3×4 = 12
- 7.A 副对角线才是 i+j==n-1
- 8.B 最后一趟只剩 1 个数,不用再排
- 9.B 这是常用验算方法
- 10.B 最坏才是 O(n²)
- 11.C 选快堆不稳定
- 12.B 1,1,2,3,5
- 13.A 递归三要素之一
- 14.B 改的是副本
- 15.B 要自己写比较,或用成员逐个比
- 16.B 选择排序不稳定
- 17.A 移动次数少
- 18.A void 函数不能赋值给变量
- 19.A 所以外层跑行、内层跑列最快
- 20.B "w" 是清空重写,"a" 才是追加